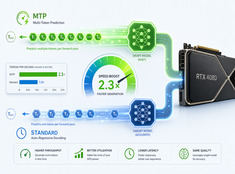
Qwen 3.6 27B und 35B MTP im Vergleich zur Standard-Version auf einer 16-GB-GPU
MTP vs. Standard-Decoding auf der RTX 4080 – echte Benchmarks
Ich habe die Leistung des spekulativen Dekodierens (Multi-Token Prediction, MTP) in Qwen 3.6 27B und 35B auf einer RTX 4080 mit 16 GB VRAM getestet.