
Kanban in Hermes Agent per flussi di lavoro con LLM self-hosted
Controlla il carico Kanban di Hermes sul tuo LLM self-hosted.
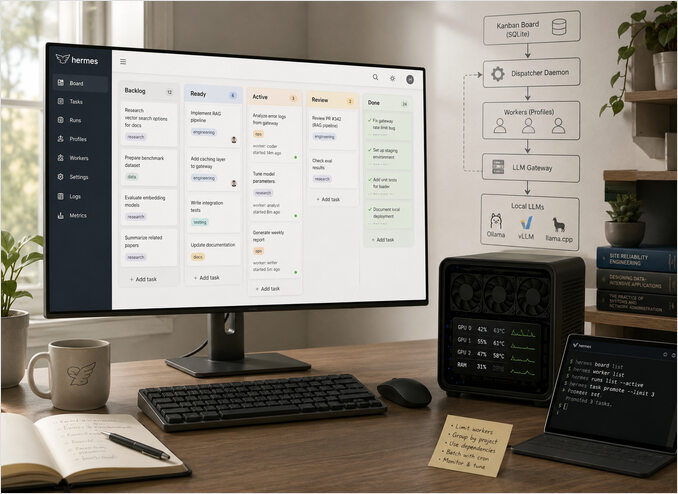
L’agente Hermes include una board in stile Kanban e il Hermes Gateway che possono saturare il tuo LLM auto-ospitato se troppi task vengono avviati contemporaneamente.
Posso affermare che in questo modo puoi facilmente mandare in tilt il tuo LLM con un attacco DDoS.
Hermes Kanban è una board multi-profilo persistente supportata da ~/.hermes/kanban.db.
Ogni corsia rappresenta una fase di lavoro e ogni carta è un task che può essere assunto da un profilo Hermes specifico.
Di default, il dispatcher può promuovere molti task ready in un’unica passata. Questo va bene per API cloud elastiche, ma può sovraccaricare un piccolo cluster GPU auto-ospitato.
Se sei nuovo di questo stack, inizia con la più ampia Guida all’impostazione e alle operazioni di Hermes e con il Pillar AI Systems per l’architettura circostante.
Questo articolo mostra come:
- Comprendere come il dispatch di Hermes Kanban interagisce con il tuo gateway LLM.
- Controllare la parallelizzazione in modo sicuro per task pesanti.
- Batch delle promozioni con cron in modo che i job di sfondo non collidano con l’uso interattivo.
- Monitorare e ottimizzare il sistema in modo che le GPU restino attive senza essere sovraccaricate.
Come funzionano Hermes Kanban e il dispatcher
Ad alto livello, il sistema ha tre livelli:
- Board - stato SQLite persistente per task, colonne, relazioni e cronologia.
- Worker - profili Hermes avviati in workspace isolati per elaborare un task.
- Dispatcher - un processo a lungo termine che scansiona le carte dispatchabili e avvia le esecuzioni.
I task creati dalla CLI o dalla dashboard solitamente iniziano in backlog o ready. I sottocomandi hermes kanban utilizzati di seguito sono riassunti nella Scheda rapida della CLI di Hermes Agent.
Il dispatcher scansiona le carte eleggibili, ne assume una atomicamente e avvia il profilo assegnato con i suoi strumenti e la memoria.
Ogni worker chiama poi il tuo gateway LLM o il runtime locale (ad esempio, endpoint compatibili con OpenAI supportati da Ollama, vLLM o llama.cpp). Per le scelte di deployment tra questi runtime, usa LLM Hosting nel 2026: Infrastruttura Locale Auto-Ospitata e Cloud Confrontata. Se stai ottimizzando il fan-out delle richieste su Ollama stesso, questo si abbina bene con Come Ollama gestisce le richieste parallele.
Se aggiungi molti task pesanti e non limiti le promozioni, il tuo gateway può essere inondato di richieste concorrenti.
Su un host con una singola GPU o vincolato da CPU, questo spesso significa code, thrashing e timeout invece di un throughput migliore.
Il limite pratico attuale
Nelle attuali build di Hermes su cui molte squadre lavorano, la configurazione del dispatcher espone solo due chiavi di dispatch Kanban e non applica un limite globale di task attivi dalla configurazione:
kanban:
  dispatch_in_gateway: false
  dispatch_interval_seconds: 10
Per il controllo dei task attivi, affidati alla cadenza di dispatch esplicita (hermes kanban dispatch --max ...) e alla modellazione delle dipendenze.
Problemi noti:
- Non eseguire il dispatch integrato nel gateway e
hermes kanban daemon --forcesulla stessa board, o potresti avere race condition nell’assunzione dei task. - Se il gateway è down, i task
readynon vengono dispatchati e potrebbero esplodere in un’unica volta quando il servizio torna. - Intervalli di dispatch più lunghi possono sembrare irregolari perché l’assunzione avviene a tick.
- Il comportamento può variare tra versioni perché i casi limite di run-state e reclaim sono stati corretti nel tempo.
Verifica rapida quando il comportamento sembra errato:
# 1) conferma che esattamente un percorso dispatcher è attivo
pgrep -af "hermes gateway start|hermes kanban daemon"

# 2) controlla le chiavi del dispatcher Kanban configurate
rg "dispatch_in_gateway|dispatch_interval_seconds" ~/.hermes/config.yaml

# 3) ispeziona la forma della coda
hermes kanban list --status ready
hermes kanban list --status running
Idei chiave:
- La configurazione del dispatcher collega
dispatch_in_gatewayedispatch_interval_seconds. dispatch --maxlimita i nuovi avvi in quella passata, non i task totali in esecuzione.- Per piccoli cluster auto-ospitati, inizia con valori conservativi e aumenta solo dopo che la latenza è rimasta stabile.
Quando si deploya Hermes per la prima volta vicino al tuo gateway LLM:
- Mantieni solo le chiavi del dispatcher Kanban supportate nella configurazione.
- Osserva l’utilizzo di GPU e CPU sotto pressione reale di coda.
- Usa la Strategia 1 o la Strategia 2 per un ritmo deterministico.
Risultati delle indagini e causa radice
hermes kanban dispatch non legge config.yaml per max_active_tasks.
In hermes_cli/kanban.py, il comando dispatch espone --max come un limite CLI (default None) e passa solo args.max a kb.dispatch_once(...). Non c’è una ricerca di configurazione max_active_tasks in questo percorso. Vedi hermes_cli/kanban.py raw.
Poi in kanban_db.dispatch_once, l’unico limite è max_spawn, con una logica equivalente a:
if max_spawn is not None and spawned >= max_spawn:
    break
Non c’è un controllo dei task già in esecuzione e nessun riferimento a max_active_tasks in quel percorso di dispatch. Vedi hermes_cli/kanban_db.py raw.
Comportamento effettivo:
hermes kanban dispatch
è illimitato per quella passata (limitato dalla dimensione della coda ready).
hermes kanban dispatch --max 2
limita solo i nuovi avvi in quella passata, non i task totali in esecuzione.
I manopole di configurazione collegate al dispatch del gateway sono kanban.dispatch_in_gateway e kanban.dispatch_interval_seconds.
Quindi max_active_tasks è ignorato in questo percorso di dispatch perché non è implementato lì.
Strategia 1 - Codificare dipendenze per flussi strettamente sequenziali
Alcuni workflow dovrebbero eseguirsi strettamente uno dopo l’altro — ad esempio:
- pipeline di dati multi-step con artefatti intermedi condivisi
- migrazioni o cambiamenti di infrastruttura
- job batch che scrivono nello stesso object store o database
Hermes Kanban supporta dipendenze genitore-figlio tra task in modo che una carta figlia diventi dispatchabile solo quando il suo genitore è completato.
Puoi modellare questo con uno script helper attorno alla CLI di Hermes:
#!/usr/bin/env bash

set -euo pipefail

parent_id="$(hermes kanban add \
  --title 'Ingest customer logs for April' \
  --profile 'etl-worker' \
  --column backlog)"

hermes kanban add \
  --title 'Generate April anomaly report' \
  --profile 'analytics-worker' \
  --column backlog \
  --parent "${parent_id}"

hermes kanban add \
  --title 'Publish April summary to dashboard' \
  --profile 'reporting-worker' \
  --column backlog \
  --parent "${parent_id}"
Con una politica di board appropriata e limiti di dispatcher bassi, solo il task genitore viene eseguito per primo.
Una volta completato, i task figlio diventano gradualmente pronti, e il dispatcher li preleva uno per uno senza mai superare i tuoi limiti di concorrenza.
Strategia 2 - Usare Linux cron con un limite di dispatch consapevole dei task in esecuzione
Se vuoi un ritmo deterministico, usa il cron del host più uno script wrapper.
Invece di chiamare sempre dispatch --max 2, conta prima i task correntemente in esecuzione, poi dispatcha solo i slot rimanenti.
Crea hermes-kanban-dispatch-capped.sh:
#!/usr/bin/env bash
set -euo pipefail

MAX_PARALLEL="${MAX_PARALLEL:-2}"
BOARD="${BOARD:-}"

board_args=()
if [[ -n "$BOARD" ]]; then
  board_args=(--board "$BOARD")
fi

# o dove il tuo hermes è installato
export PATH="/home/abc/.local/bin:$PATH"

running_out="$(hermes kanban "${board_args[@]}" list --status running)"

if [[ "$running_out" == *"(no matching tasks)"* ]]; then
  running_count=0
else
  running_count="$(printf '%s\n' "$running_out" | wc -l)"
fi

slots=$(( MAX_PARALLEL - running_count ))

if (( slots <= 0 )); then
  echo "Già al limite running=$running_count max=$MAX_PARALLEL dispatch saltato"
  exit 0
fi

echo "running=$running_count max=$MAX_PARALLEL slots=$slots dispatching fino a $slots"

hermes kanban "${board_args[@]}" dispatch --max "$slots"
Rendilo eseguibile:
chmod +x ./hermes-kanban-dispatch-capped.sh
Eseguilo con:
MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Per una board specifica:
BOARD=my-board MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Pianificalo una volta al minuto con cron:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-capped.sh >> /var/log/hermes/kanban-cron.log 2>&1
Note operative:
- Cron spesso ha un
PATHminimale, quindi sehermesnon viene trovato, usa il suo percorso completo all’interno dello script (ad esempio/usr/local/bin/hermes). - Se registri i log in
/var/log/hermes/..., crea prima quella directory e assicurati che l’utente cron abbia accesso in scrittura.
Esempio:
sudo mkdir -p /var/log/hermes
sudo chown "$USER":"$USER" /var/log/hermes
Crea o modifica le voci cron con:
crontab -e
Poi verifica con:
crontab -l
Cadenza sub-minuto con una singola voce cron
Cron batte una volta al minuto, ma puoi comunque dispatchare più frequentemente eseguendo un breve ciclo all’interno dello script.
Esempio hermes-kanban-dispatch-subminute.sh:
#!/usr/bin/env bash
set -euo pipefail

LOCK_FILE="/tmp/hermes-kanban-dispatch.lock"
RUNS_PER_MINUTE="${RUNS_PER_MINUTE:-4}"    # 4 esecuzioni => ogni 15 secondi
CAP_SCRIPT="${CAP_SCRIPT:-/opt/hermes/scripts/hermes-kanban-dispatch-capped.sh}"

exec 9>"$LOCK_FILE"
flock -n 9 || exit 0

sleep_seconds=$(( 60 / RUNS_PER_MINUTE ))

for ((i=1; i<=RUNS_PER_MINUTE; i++)); do
  "$CAP_SCRIPT"

  if (( i < RUNS_PER_MINUTE )); then
    sleep "$sleep_seconds"
  fi
done
Rendilo eseguibile:
chmod +x ./hermes-kanban-dispatch-subminute.sh
Pianificalo una volta al minuto:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-subminute.sh >> /var/log/hermes/kanban-subminute.log 2>&1
Questo dà una cadenza effettiva sub-minuto mentre flock previene esecuzioni sovrapposte.
Perché funziona:
list --status runningdà il carico corrente in esecuzione.dispatch --max Nlimita solo i nuovi avvi per quella passata.- Calcolando
Ncome slot rimanenti mantiene i task totali in esecuzione vicino al tuo limite target.
Avvertenza importante: questo limite funziona solo per i dispatch fatti tramite questo script.
Disabilita il dispatch integrato nel gateway, altrimenti potrebbe comunque promuovere task indipendentemente:
kanban:
  dispatch_in_gateway: false
La documentazione ufficiale descrive le capacità di entrambi i comandi e nota i default del dispatch del gateway nella guida alle funzionalità Kanban: Documentazione Hermes Kanban.
Cron interno di Hermes
Non usarlo.
Voi davvero volete che il vostro LLM elabori prompt regolari come Execute in terminal the command /path/hermes-kanban-dispatch-capped.sh, specialmente quando è impegnato a fare qualche lavoro utile?
Monitoraggio e ottimizzazione di Hermes Kanban
Quale strategia tu scelga, dovresti monitorare:
- Metriche del gateway LLM — frequenza delle richieste, latenza, tasso di errore, throughput di token.
- Salute del nodo — utilizzo GPU, uso VRAM, carico CPU e RAM.
- Metriche di Hermes — quanti task sono in backlog, ready, attivi e completati.
Per baseline delle metriche di produzione e dashboard, vedi Monitorare l’inferenza LLM in produzione con Prometheus e Grafana e l’ampio Hub Prestazioni LLM.
Inizia con una bassa concorrenza, poi aumenta gradualmente i limiti monitorando:
- latenza in aumento a throughput costante
- aumento degli errori di timeout o di limite di frequenza
- code lunghe dove alcuni task restano attivi per molto tempo
Non appena vedi questi sintomi, torna alla configurazione stabile precedente e mantienila come tua configurazione predefinita.
Quando Kanban è lo strumento giusto
Hermes Kanban brilla quando hai:
- backlog di ricerca o ingegneria di lunga durata
- collaborazione multi-agente con profili nominati
- workflow che devono sopravvivere a riavvii e riavvii dell’host
- umani che vogliono una dashboard per triaggiare il lavoro
Se hai solo bisogno di un singolo run per creare alcuni helper temporanei, gli strumenti di delega del task incorporati sono di solito più semplici.
Una volta che hai bisogno di cronologia, dashboard e controllo rigoroso su come i tuoi agenti colpiscono gli LLM auto-ospitati, la board Kanban più il dispatcher è la fondazione giusta.
Con alcuni ritocchi di configurazione e batch opzionali basati su cron, puoi mantenere Hermes Kanban reattivo proteggendo al tempo stesso il tuo gateway e l’hardware.
Per una visione più ampia di come i worker di sfondo di tipo Hermes si inseriscano nelle architetture di assistenti AI di produzione — inclusi scheduler, polling basato su code, protocolli di assunzione, workflow durevoli e valutazione semantica — vedi Agenti di Polling negli Assistenti AI: 11 Pattern di Implementazione. Quando più profili nominati o agenti specialisti devono coordinarsi oltre il semplice dispatch di task, Pattern di Orchestrazione Multi-Agente copre le topologie di coordinamento — hub-and-spoke, fan-out, swarm — che sostengono configurazioni multi-agente più grandi su infrastruttura auto-ospitata.
