
Ottimizzazione dei costi per i sistemi LLM: dove si spendono realmente i soldi
Spendi i token dove contano davvero.
I costi degli LLM scalano linearmente con l’utilizzo. Un sistema che elabora 10.000 richieste al giorno a 0,01 $ per richiesta costa 100 $ al giorno, ovvero 365 $ all’anno. Su scala enterprise, si supera i 10.000 $.
L’ottimizzazione dei costi non si tratta di tagliare corners. Si tratta di spendere i token dove contano.
Ogni token sprecato è un token che potresti aver speso per una risposta migliore.
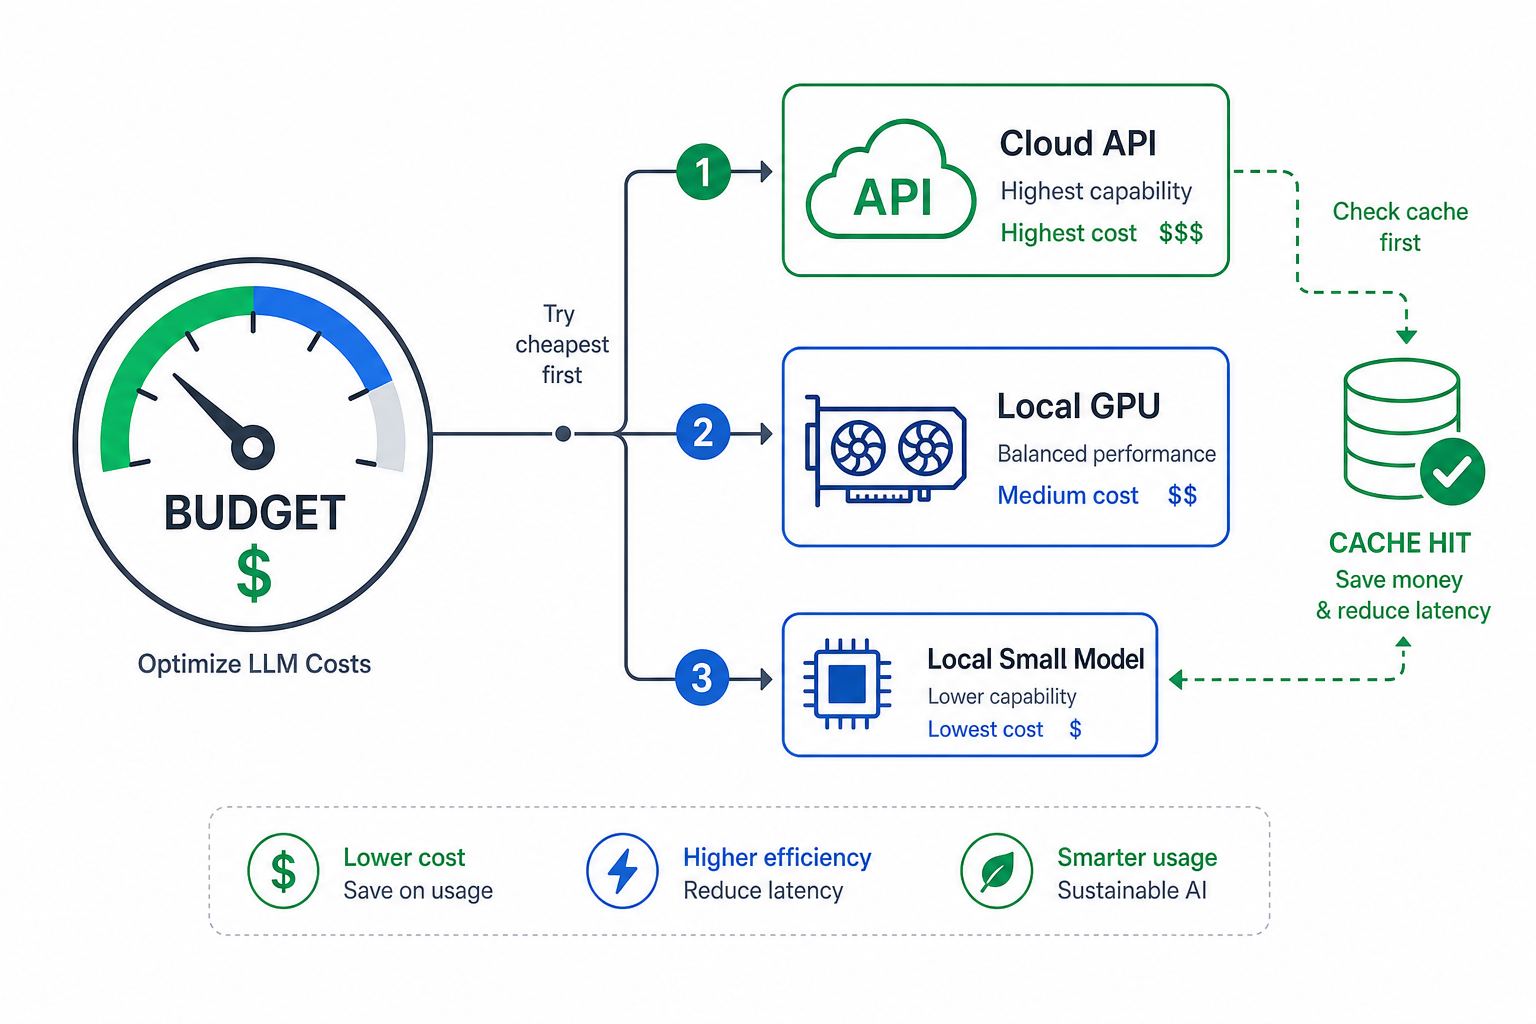
Budget dei token
Il modo più semplice per controllare i costi è impostare dei limiti. Per sessione, per attività o per giorno.
Strategia 1: Budget per sessione
I budget per sessione sono semplici:
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
Strategia 2: Budget per attività
I budget per attività sono più utili. Diverse attività richiedono quantità diverse di contesto:
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
Strategia 3: Budget adattivi
I budget adattivi si regolano in base a ciò che accade realmente. Se le attività di classificazione utilizzano costantemente 80 token, smetti di allocarne 100:
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
La media mobile esponenziale (peso 0.9) significa che l’utilizzo recente conta più della storia. Regola il peso in base alla volatilità dei tuoi carichi di lavoro.
API vs inferenza locale
L’inferenza locale è più economica su larga scala. Il punto di pareggio dipende dall’hardware e dai tassi API.
| Modello | API ($/M token) | Costo locale/ora | Pareggio |
|---|---|---|---|
| GPT-4o | 2,50 $ / 10,00 $ | — | N/D |
| Claude Sonnet 4 | 3,00 $ / 15,00 $ | — | N/D |
| Qwen2.5-72B | 0,50 $ / 2,00 $ | ~0,50 $ | ~4 ore/giorno |
| qwen3-32b | 0,30 $ / 1,20 $ | ~0,20 $ | ~2 ore/giorno |
| qwen3-8b | 0,10 $ / 0,40 $ | ~0,05 $ | ~1 ora/giorno |
I calcoli sull’hardware:
| Hardware | Costo iniziale | Elettricità mensile | Pareggio rispetto all’API |
|---|---|---|---|
| RTX 3090 (usato) | 600 $ | 15 $ | ~4 mesi |
| RTX 4090 | 1.500 $ | 20 $ | ~6 mesi |
| RTX 5080 | 1.000 $ | 18 $ | ~5 mesi |
| DGX Spark | 2.000 $ | 30 $ | ~8 mesi |
Con un utilizzo moderato — un’ora o più al giorno — l’inferenza locale si ripaga. Con un utilizzo elevato, i risparmi sono drastici. Il problema è il capitale iniziale. Una RTX 5080 costa 1.000 $. Una fattura API si può sospendere. L’hardware no.
Questo calcolo del pareggio presuppone che tu sia libero di cambiare, il che spesso è l’incognita maggiore rispetto al costo dell’hardware. Se i tuoi dati di fine-tuning, i tuoi strumenti di valutazione e gli schemi dei tuoi tool sono già costruiti attorno all’API di un provider, il vero costo della migrazione è il tempo di ingegneria necessario per svincolarsi — non il prezzo di una GPU. Data Gravity: Il vero costo dell’IA API-First copre questo meccanismo di lock-in e un’elenco di controllo per valutare quanto sei già dentro, prima di fare questi calcoli.
Strategie di fallback
Quando il tuo modello preferito è troppo costoso o troppo lento, passa a qualcosa di più economico. La chiave è sapere quando la qualità è “abbastanza buona”.
Strategia 1: Fallback basati sulla qualità
Il fallback basato sulla qualità prova i modelli finché l’output non raggiunge una soglia:
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
Il problema è la valutazione stessa. Come misuri la qualità senza chiamare un altro modello? Alcuni sistemi usano un piccolo classificatore. Altri usano controlli euristici — lunghezza, struttura, presenza di parole chiave. Nessuno di questi è perfetto.
Strategia 2: Fallback basati sulla latenza
Il fallback basato sulla latenza è più semplice. Instrada verso il modello più veloce che soddisfi il tuo budget di tempo:
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
Caching
Il caching è l’ottimizzazione dei costi più sottovalutata. I prompt identici accadono più spesso di quanto pensi — richieste di classificazione, query di tipo FAQ, chiamate di tool ripetute.
Strategia 1: Caching dei prompt
Il caching esatto dei prompt è semplice:
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
Strategia 2: Caching semantico
Il caching semantico è più utile. Cattura prompt che sono diversi ma significano la stessa cosa:
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
La soglia conta. 0.95 è aggressivo — solo prompt molto simili corrispondono. 0.85 è più permissivo ma rischia di restituire risposte errate. Misura il tuo tasso di mancato successo e regola.
La cache delle risposte per le query comuni ne vale la pena. Se gli utenti chiedono “com’è il meteo” o “che ore sono” ripetutamente, metti in cache il pattern, non solo il prompt esatto:
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
Non è sofisticato, ma funziona. Le query comuni sono comuni per una ragione.
Quando l’ottimizzazione aiuta
L’ottimizzazione conta quando elabori grandi volumi, esegui carichi di lavoro misti o paghi costi API che si accumulano.
Non conta quando stai facendo prototipazione, usi un singolo modello o elabori bassi volumi. La complessità di budgeting, fallback e caching non vale la pena per un sistema che fa 100 richieste al giorno.
Fai prima funzionare il flusso di base. Aggiungi ottimizzazioni quando arriva la fattura.
Compromessi
| Strategia | Costo | Qualità | Complessità |
|---|---|---|---|
| Nessuna ottimizzazione | Massima | Costante | Minima |
| Budget dei token | Moderata | Variabile | Media |
| Modelli di fallback | Bassa-Media | Variabile | Media |
| Caching | Minima | Alta (per hit di cache) | Media |
| Ibrida | Ottimizzata | Ottimizzata | Massima |
I sistemi di produzione di solito usano un approccio ibrido. Budget per sessione, fallback su qualità o latenza, caching di ciò che si può. La complessità è reale, ma così sono i risparmi.
Correlati
- Data Gravity: Il vero costo dell’IA API-First — perché il calcolo del pareggio sopra è solo metà della decisione di self-hosting
- La frontiera efficiente dei modelli open source nel 2026 — economia della dimensione del modello dietro il pareggio: un modello da 27B su una 4090 affittata contro i prezzi attuali dei token Sonnet
- Strategie di routing dei modelli — routing basato sulle capacità, consapevole dei costi e della latenza
- Guardrail LLM in pratica — validazione degli input, filtraggio degli output, sicurezza
- Progettazione di sistemi multi-modello — architettura per più modelli
- Architettura LLM — pilastro di progettazione dei sistemi: routing, costi, guardrail e orchestrazione
