
ASIC per LLM e chip di inferenza specializzati (perché sono importanti)
Le ASIC e il silicio personalizzato aumentano la velocità e l'efficienza dell'inferenza dei modelli LLM
Il futuro dell’AI non riguarda solo modelli più intelligenti. Riguarda anche il silicio che corrisponde al modo in cui questi modelli vengono effettivamente serviti. L’hardware specializzato per l’inferenza LLM sta seguendo un percorso simile al passaggio del mining di Bitcoin dalle GPU agli ASIC appositamente progettati, sebbene con vincoli più stringenti poiché i modelli e le ricette di precisione continuano a evolversi.
Per ulteriori informazioni su throughput, latenza, VRAM e benchmark tra runtime e hardware, consulta Prestazioni LLM: Benchmark, Colli di Bottiglia e Ottimizzazione.
 Electrical Imagination - LLM da testo a immagine Flux.
Perché gli LLM traggono vantaggio dall’hardware specifico per l’inferenza
I grandi modelli linguistici hanno trasformato l’AI, ma ogni risposta fluente dipende da enormi flussi prevedibili di matematica matriciale e traffico di memoria. Man mano che le spese per l’inferenza crescono — superando spesso quelle per l’addestramento nel ciclo di vita di un modello — i chip ottimizzati per il servizio (serving), e non per ogni possibile carico di lavoro, diventano economicamente vantaggiosi.
L’analogia con il mining di Bitcoin è imperfetta ma istruttiva. Entrambi sono compiti ripetitivi e ben definiti, dove l’eliminazione della generalità non utilizzata dal die può garantire grandi miglioramenti in termini di throughput e joule per operazione utile.
Cosa suggerisce la storia del mining di Bitcoin sugli ASIC per l’inferenza
Il mining di Bitcoin è evoluto attraverso quattro generazioni:
| Era | Hardware | Vantaggio Chiave | Limitazione |
|---|---|---|---|
| 2015–2020 | GPU (CUDA, ROCm) | Flessibilità | Consumi elevati, limitato dalla memoria |
| 2021–2023 | TPUs, NPUs | Specializzazione a grana grossolana | Ancora orientato all’addestramento |
| 2024–2025 | ASIC per Transformer | Ottimizzati per inferenza a bit bassi | Generalità limitata |
L’AI sta seguendo un percorso simile. Ogni transizione ha migliorato le prestazioni e l’efficienza energetica di ordini di grandezza.
Tuttavia, a differenza degli ASIC per Bitcoin (che calcolano solo SHA-256), gli ASIC per l’inferenza necessitano di una certa flessibilità. I modelli evolvono, le architetture cambiano e i schemi di precisione migliorano. Il trucco è specializzarsi abbastanza — cablando a fixo i pattern centrali mantenendo al contempo adattabilità sui margini.
Come l’inferenza LLM differisce dall’addestramento (e cosa sfruttano i chip)
I carichi di lavoro di inferenza espongono pattern che l’hardware specializzato può sfruttare:
- La bassa precisione domina — L’aritmetica a 8 bit, 4 bit, anche ternaria o binaria funziona bene per l’inferenza
- La memoria è il collo di bottiglia — Il trasferimento dei pesi e delle cache KV consuma molta più energia del calcolo
- La latenza conta più del throughput — Gli utenti si aspettano token in meno di 200 ms
- Massive parallelità delle richieste — Migliaia di richieste di inferenza concorrenti per chip
- Pattern prevedibili — Gli strati Transformer sono altamente strutturati e possono essere cablati a fixo
- Opportunità di sparsità — I modelli utilizzano sempre più tecniche di potatura (pruning) e MoE (Mixture-of-Experts)
Un chip di inferenza appositamente progettato può cablare a fixo queste assunzioni per ottenere prestazioni per watt migliori di 10–50 volte rispetto alle GPU general purpose.
Chi sta costruendo silicio per inferenza ottimizzato per LLM
Il mercato degli ASIC per l’inferenza abbraccia aziende consolidate, design wafer-scale e startup che puntano su silicio dalla forma di un transformer:
| Azienda | Chip / Piattaforma | Specialità |
|---|---|---|
| Groq | LPU (Language Processing Unit) | Throughput deterministico per LLM |
| Etched AI | ASIC Sohu | Motore Transformer cablato a fixo |
| Tenstorrent | Grayskull / Blackhole | ML general purpose con mesh a banda larga |
| Taalas | HC1 (prodotto Llama 3.1 8B) / roadmap HC2 | Silicio “hardcore” specifico per modello; unisce memoria e calcolo |
| OpenAI × Broadcom | Chip di Inferenza Personalizzato | Presumibilmente lancio nel 2026 |
| Intel | Crescent Island | GPU Xe3P solo per inferenza con 160GB HBM |
| Cerebras | Wafer-Scale Engine (WSE-3) | Enorme banda di memoria} sulla die |
Gran parte di questo è già nei data center di produzione, non nella presentazione aziendale. Team più piccoli come d-Matrix, Rain AI, Mythic e Tenet stanno anche perseguendo architetture ottimizzate per l’inferenza a bit bassi e la sparsità strutturata.
Taalas HC1, Chat Jimmy e il servizio ultra-veloce di modelli piccoli
Taalas è un esempio recente della scuola del “specializza quasi tutto”. L’azienda sostiene che il confine memoria-calcolo (DRAM off-chip rispetto a SRAM on-chip) domina il costo, l’energia e la complessità ingegneristica per l’inferenza, e che il silicio per modello — ciò che chiamano Modelli Hardcore — può collassare quel confine quando una deployment è disposta a fissare pesi e grafo.
Il loro primo prodotto spedito, HC1, cabla a fixo una variante di Llama 3.1 8B. Questa scelta è pragmatica: il modello è abbastanza piccolo da essere implementato rapidamente, è documentato apertamente ed è ancora utile per molte attività di automazione, classificazione e stesura dove la profondità di ragionamento bruta conta meno di latenza e costo. Taalas riporta un ordine di grandezza di 16k–17k token decodificati al secondo per utente per questa configurazione (la metodologia del fornitore e i confronti appaiono nella loro documentazione), insieme a rivendicazioni di grandi miglioramenti in termini di capitale ed energia rispetto agli stack GPU convenzionali per la stessa classe di modello. I componenti di prima generazione utilizzano una conservazione mista a bit bassi aggressiva; l’azienda descrive il passaggio verso formati float standard a 4 bit su HC2 per recuperare margine sulla qualità.
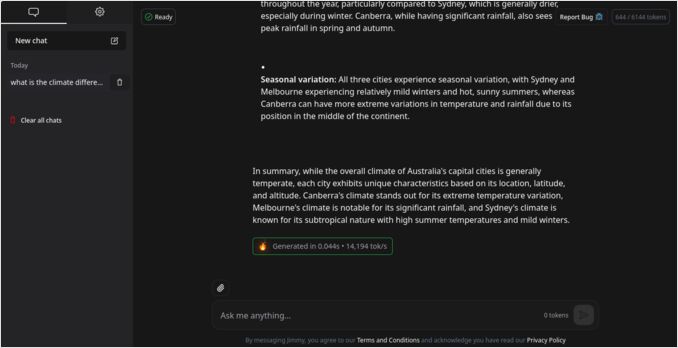
Per gli sviluppatori che vogliono provare in pratica cosa implica questa classe di throughput, Taalas esegue una demo di chatbot gratuita, Chat Jimmy, e offre l’accesso API attraverso un modulo di richiesta sul loro sito. Si tratta esplicitamente di una prova di concetto — non di un assistente di frontiera — ma illustra un pubblico reale che potrebbe preferire un modello modesto alla “velocità della cognizione umana” rispetto a un modello più grande che risulta lento o costoso.
Architettura di un ASIC per inferenza Transformer
Come appare realmente un chip ottimizzato per i transformer all’interno?
+--------------------------------------+
|         Interfaccia Host             |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  Interconnessione On-chip (mesh/ring)|
+--------------------------------------+
|  Tile di Calcolo / Core              |
|   — Unità di moltiplicazione matriciale densa |
|   — ALU a bassa precisione (int8/int4)|
|   — Unità Dequant / Attivazione      |
+--------------------------------------+
|  SRAM On-chip & buffer cache KV      |
|   — Pesi caldi, cache fuse           |
+--------------------------------------+
|  Pipeline Quantizzazione / Dequant   |
+--------------------------------------+
|  Scheduler / Controller              |
|   — Motore di esecuzione grafo statico |
+--------------------------------------+
|  Interfaccia DRAM / HBM Off-chip     |
+--------------------------------------+
Le principali funzionalità architetturali includono:
- Core di calcolo — Unità di moltiplicazione matriciale densa ottimizzate per operazioni int8, int4 e ternarie
- SRAM on-chip — Buffer ampi che trattengono pesi caldi e cache KV, minimizzando gli accessi costosi alla DRAM
- Interconnessioni streaming — Topologia mesh che abilita uno scaling efficiente tra più chip
- Motori di quantizzazione — Quantizzazione/dequantizzazione in tempo reale tra gli strati
- Stack compilatore — Traduce i grafi PyTorch/ONNX direttamente in micro-op specifiche del chip
- Kernel di attenzione cablati a fixo — Elimina l’overhead del flusso di controllo per softmax e altre operazioni
La filosofia di design riflette gli ASIC di Bitcoin: ogni transistor serve il carico di lavoro specifico. Nessun silicio sprecato per funzionalità di cui l’inferenza non ha bisogno.
Benchmark GPU contro ASIC per l’inferenza LLM
I dati pubblici rappresentativi mostrano come l’hardware specializzato per l’inferenza possa distaccarsi dagli stack GPU general purpose sulle stesse famiglie di modelli (verificare sempre la metodologia e le assunzioni sul batching per i propri carichi di lavoro):
| Modello | Hardware | Throughput (token/s) | Tempo al Primo Token | Moltiplicatore Prestazioni |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1.7s | Baseline (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0.22s | 3–18× più veloce |
| Llama-3.3-70B | Groq LPU | ~276 | ~0.2s | Costante 3× |
| Gemma-7B | Groq LPU | 814 | <0.1s | 5–15× più veloce |
| Llama-3.1-8B | Taalas HC1 (fornitore) | ~16k–17k decod t/s/utente | — | Asse separato (grafo 8B fisso, non 70B) |
Fonti: Groq.com, ArtificialAnalysis.ai, NVIDIA Developer Blog; i dati Taalas HC1 provengono dal post sul prodotto dell’azienda.
Le righe focalizzate su Groq mostrano grandi guadagni in termini di throughput e tempo al primo token rispetto a una baseline GPU di fascia alta sui modelli grandi. La riga di Taalas non è un altro moltiplicatore rispetto a quelle righe da 70B; illustra quanto lontano si possa spingere la decodifica per utente quando il modello e il grafo sono fissati nel silicio, a costo della flessibilità.
Compromessi quando si specializza il silicio per l’inferenza
La specializzazione acquista prestazioni, ma reintroduce rischi di prodotto e ingegneria:
-
Flessibilità vs. Efficienza. Un ASIC completamente fisso supera i modelli transformer di oggi a grandi velocità, ma potrebbe fare fatica con le architetture di domani. Cosa succede quando i meccanismi di attenzione evolvono o emergono nuove famiglie di modelli? Non si tratta di un’ipotesi — i modelli a spazio di stato, i modelli linguistici di diffusione e i modelli di mondo JEPA stanno già sfidando la dominanza del transformer sul lato dei modelli; consulta cosa c’è dopo gli LLM per scoprire dove quelle architetture potrebbero lasciare indietro il silicio transformer cablato a fixo.
-
Quantizzazione e Precisione. Una precisione inferiore salva enormi quantità di energia, ma gestire il degrado della precisione richiede schemi di quantizzazione sofisticati. Non tutti i modelli quantizzano bene a 4 bit o meno.
-
Ecosistema Software. L’hardware senza compilatori, kernel e framework robusti è inutile. NVIDIA domina ancora in larga parte a causa dell’ecosistema maturo di CUDA. I nuovi produttori di chip devono investire pesantemente in software.
-
Costo e Rischio. Il taping out di un chip costa decine di milioni di dollari e richiede 12–24 mesi. Per le startup, questa è una scommessa massiccia su assunzioni architetturali che potrebbero non reggere.
Tuttavia, alla scala iper-scalare, anche un guadagno di efficienza di 2× si traduce in miliardi di risparmi. Per i [provider cloud](https://www.glukhov.org/it/developer-tools/comparisons/popularity-of-ai-tools-programming-languages-ides-cloud-providers/ “Popularità dei linguaggi di programmazione e degli strumenti per sviluppatori software”}) che eseguono milioni di richieste di inferenza al secondo, il silicio personalizzato è sempre più irrinunciabile.
Specifiche ideali per un chip di inferenza LLM
| Caratteristica | Specifica Ideale |
|---|---|
| Processo | Nodo 3–5nm |
| SRAM On-chip | 100MB+ accoppiato strettamente |
| Precisione | Supporto nativo int8 / int4 / ternario |
| Throughput | 500+ token/secondo (modello 70B) |
| Latenza | <100ms tempo al primo token |
| Interconnessione | Mesh a bassa latenza o collegamenti ottici |
| Compilatore | Toolchain PyTorch/ONNX → microcode |
| Energia | <0.3 joule per token |
Guardando avanti (2026–2030)
Ci si aspetta che il panorama dell’hardware per l’inferenza si stratifichi in tre fasce principali:
-
Chip per l’Addestramento. Le GPU di fascia alta come NVIDIA B200 e AMD Instinct MI400 continueranno a dominare l’addestramento grazie alla loro flessibilità FP16/FP8 e all’enorme banda di memoria.
-
ASIC per l’Inferenza. Gli acceleratori transformer cablati a fixo a bassa precisione gestiranno il servizio di produzione alla scala iper-scalare, ottimizzati per costo ed efficienza.
-
NPU per Edge. Chip piccoli e ultra-efficienti porteranno gli LLM quantizzati su smartphone, veicoli, dispositivi IoT e robot, abilitando l’intelligenza on-device senza dipendenza dal cloud.
Oltre all’hardware puro, vedremo:
- Cluster ibridi — GPU per l’addestramento flessibile, ASIC (o motori di inferenza wafer-scale) per il servizio efficiente
- Inference-as-a-Service — Ipotescalers che mescolano acceleratori di prima parte (AWS Inferentia, Google TPU e altri) con le GPU
- Co-design Hardware–Software — Modelli progettati per sparsità a blocchi, routing MoE e strati amichevoli alla quantizzazione
- Silicio per modello o per famiglia — Aziende come Taalas scommettono che alcune deployment scambieranno la flessibilità architetturale per un estremo risparmio di costi e latenza su un grafo noto
- API di inferenza aperte — Pressione per mantenere le interfacce di servizio portabili anche quando il silicio non lo è
Pensieri finali
L’“ASIC-izzazione” dell’inferenza AI è già in corso. Proprio come il mining di Bitcoin è evoluto dai CPU al silicio specializzato, la deployment dell’AI} sta seguendo lo stesso percorso.
La prossima rivoluzione nell’AI non riguarderà modelli più grandi — riguarderà chip migliori. L’hardware ottimizzato per i pattern specifici dell’inferenza transformer determinerà chi può distribuire l’AI economicamente su larga scala.
Proprio come i minatori di Bitcoin hanno ottimizzato via ogni watt sprecato, l’hardware per l’inferenza strizzerà ogni ultimo FLOP-per-joule. Quando ciò accadrà, la vera svolta non sarà negli algoritmi — sarà nel silicio che li esegue.
Il futuro dell’AI sta essere inciso nel silicio, un transistor alla volta.
Per ulteriori benchmark, scelte hardware e tuning delle prestazioni, controlla il nostro hub Prestazioni LLM: Benchmark, Colli di Bottiglia e Ottimizzazione.
Link Utili
- Benchmark Ufficiali Groq
- Taalas — La strada verso l’AI ubiquitaria (HC1, roadmap, filosofia)
- Chat Jimmy — Demo Taalas Llama 3.1 8B
- Modulo di richiesta accesso API Taalas
- Artificial Analysis - Classifica Prestazioni LLM
- NVIDIA H100 Technical Brief
- Etched AI - Annunci ASIC Transformer
- Cerebras Wafer-Scale Engine
- Prezzi di NVidia RTX 5080 e RTX 5090 in Australia - Ottobre 2025
- Prestazioni LLM e Lane PCIe: Considerazioni Chiave
- Test di velocità dei Grandi Modelli Linguistici
- Confronto sulla idoneità delle GPU NVidia per l’AI
- La Quadro RTX 5880 Ada 48GB è Buona?
