
Vincolare gli LLM con output strutturati: Ollama, Qwen3 e Python o Go
Alcuni modi per ottenere output strutturati da Ollama
Modelli di Linguaggio su Larga Scala (LLM) sono potenti, ma in produzione raramente desideriamo paragrafi liberi. Invece, vogliamo dati prevedibili: attributi, fatti o oggetti strutturati che possiamo alimentare in un’applicazione. Questo è l’Output Strutturato degli LLM.
L’applicazione dello schema riduce la frequenza con cui logit scadenti si trasformano in JSON non validi, ma la temperatura e le penalità restano importanti per le tempeste di retry; consulta parametri di inferenza agentica per Qwen e Gemma quando combini vincoli di format con agenti.
Il layer di servizio ha comunque bisogno di logica di analisi-normalizzazione-validazione—vedi validazione dell’output strutturato degli LLM in Python che regge—perché Ollama e i client possono disaccordare sulle stringhe esatte anche quando è impostato format.
Alcun tempo fa Ollama ha introdotto il supporto per l’output strutturato (annuncio), rendendo possibile vincolare le risposte di un modello per farle corrispondere a uno schema JSON. Questo sblocca pipeline di estrazione dati coerenti per compiti come la catalogazione delle funzionalità degli LLM, il benchmarking dei modelli o l’automazione dell’integrazione di sistema.
In questo post, tratteremo:
- Cos’è l’output strutturato e perché è importante
- Un modo semplice per ottenere output strutturato dagli LLM
- Come funziona la nuova funzionalità di Ollama
- Esempi di estrazione delle capacità degli LLM:
Cos’è l’Output Strutturato?
Normalmente, gli LLM generano testo libero:
“Il modello X supporta il ragionamento con chain-of-thought, ha una finestra di contesto di 200K token e parla inglese, cinese e spagnolo.”
È leggibile, ma difficile da analizzare.
Invece, con l’output strutturato, richiediamo uno schema rigoroso:
{
  "name": "Modello X",
  "supports_thinking": true,
  "max_context_tokens": 200000,
  "languages": ["Inglese", "Cinese", "Spagnolo"]
}
Questo JSON è facile da validare, archiviare in un database o passare a un’interfaccia utente.
Metodo semplice per ottenere Output Strutturato dagli LLM
A volte gli LLM comprendono cos’è lo schema e possiamo chiedere all’LLM di restituire l’output in JSON utilizzando uno schema particolare. Il modello Qwen3 di Alibaba è ottimizzato per il ragionamento e le risposte strutturate. Puoi esplicitamente istruirlo a rispondere in JSON.
Esempio 1: Utilizzo di Qwen3 con ollama in Python, richiedendo JSON con schema
import json
import ollama

prompt = """
You are a structured data extractor.
Return JSON only.
Text: "Elon Musk is 53 and lives in Austin."
Schema: { "name": string, "age": int, "city": string }
"""

response = ollama.chat(model="qwen3", messages=[{"role": "user", "content": prompt}])
output = response['message']['content']

# Parse JSON
try:
    data = json.loads(output)
    print(data)
except Exception as e:
    print("Error parsing JSON:", e)
Output:
{"name": "Elon Musk", "age": 53, "city": "Austin"}
Applicazione della Validazione dello Schema con Pydantic
Per evitare output malformati, è possibile validarli rispetto a uno schema Pydantic in Python.
from pydantic import BaseModel

class Person(BaseModel):
    name: str
    age: int
    city: str

# Suppose 'output' is the JSON string from Qwen3
data = Person.model_validate_json(output)
print(data.name, data.age, data.city)
Questo garantisce che l’output conformi alla struttura prevista.
Output Strutturato di Ollama
Ollama ora consente di passare uno schema nel parametro format. Il modello viene quindi vincolato a rispondere solo in JSON che conforma allo schema (documentazione).
In Python, si definisce tipicamente lo schema con Pydantic e si lascia che Ollama lo utilizzi come schema JSON.
Esempio 2: Estrazione dei Metadati delle Funzionalità di un LLM
Supponiamo di avere uno snippet di testo che descrive le capacità di un LLM:
“Qwen3 ha un forte supporto multilingue (inglese, cinese, francese, spagnolo, arabo). Consente passaggi di ragionamento (chain-of-thought). La finestra di contesto è di 128K token.”
Vuoi dati strutturati:
from pydantic import BaseModel
from typing import List
from ollama import chat

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]

prompt = """
Analyze the following description and return the model’s features in JSON only.
Model description:
'Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
It allows reasoning steps (chain-of-thought).
The context window is 128K tokens.'
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=LLMFeatures.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Possibile output:
{
  "name": "Qwen3",
  "supports_thinking": true,
  "max_context_tokens": 128000,
  "languages": ["Inglese", "Cinese", "Francese", "Spagnolo", "Arabo"]
}
Esempio 3: Confronto di più Modelli
Immetti descrizioni di più modelli ed estraili in forma strutturata:
from typing import List

class ModelComparison(BaseModel):
    models: List[LLMFeatures]

prompt = """
Extract features of each model into JSON.

1. Llama 3.1 supports reasoning. Context window is 128K. Languages: English only.
2. GPT-4 Turbo supports reasoning. Context window is 128K. Languages: English, Japanese.
3. Qwen3 supports reasoning. Context window is 128K. Languages: English, Chinese, French, Spanish, Arabic.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=ModelComparison.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Output:
{
  "models": [
    {
      "name": "Llama 3.1",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["Inglese"]
    },
    {
      "name": "GPT-4 Turbo",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["Inglese", "Giapponese"]
    },
    {
      "name": "Qwen3",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["Inglese", "Cinese", "Francese", "Spagnolo", "Arabo"]
    }
  ]
}
Questo rende banale fare benchmark, visualizzare o filtrare i modelli in base alle loro funzionalità.
Esempio 4: Rilevamento Automatico delle Lacune
È persino possibile consentire valori null quando un campo è mancante:
from typing import Optional

class FlexibleLLMFeatures(BaseModel):
    name: str
    supports_thinking: Optional[bool]
    max_context_tokens: Optional[int]
    languages: Optional[List[str]]
Questo garantisce che lo schema rimanga valido anche se alcune informazioni sono sconosciute.
Vantaggi, Avvertenze e Migliori Pratiche
L’uso dell’output strutturato tramite Ollama (o qualsiasi sistema che lo supporti) offre molti vantaggi, ma presenta anche alcune avvertenze.
Vantaggi
- Garanzie più forti: Il modello viene richiesto di conformarsi a uno schema JSON anziché a testo libero.
- Analisi più facile: È possibile eseguire direttamente
json.loadso validare con Pydantic / Zod, anziché usare regex o euristiche. - Evoluzione basata su schema: È possibile versionare lo schema, aggiungere campi (con valori predefiniti) e mantenere la retrocompatibilità.
- Interoperabilità: I sistemi a valle si aspettano dati strutturati.
- Determinismo (migliore con bassa temperatura): Quando la temperatura è bassa (ad es. 0), il modello è più incline a attenersi rigidamente allo schema. I documenti di Ollama lo raccomandano.
Avvertenze e Trappole
- Mancato rispetto dello schema: Il modello potrebbe ancora discostarsi, ad esempio omettere una proprietà obbligatoria, riordinare le chiavi o includere campi extra. È necessaria la validazione.
- Schemi complessi: Schema JSON molto profondi o ricorsivi potrebbero confondere il modello o portare a fallimenti.
- Ambiguità nel prompt: Se il prompt è vago, il modello potrebbe indovinare erroneamente i campi o le unità.
- Incoerenza tra modelli: Alcuni modelli possono essere migliori o peggiori nel rispettare i vincoli strutturati.
- Limiti di token: Lo schema stesso aggiunge costi di token al prompt o alla chiamata API.
Migliori Pratiche e Suggerimenti (tratti dal blog di Ollama + esperienza)
- Usa Pydantic (Python) o Zod (JavaScript) per definire i tuoi schemi e generare automaticamente gli schemi JSON. Questo evita errori manuali.
- Includi sempre istruzioni come “rispondi solo in JSON” o “non includere commenti o testo extra” nel tuo prompt.
- Usa temperatura = 0 (o molto bassa) per minimizzare la casualità e massimizzare l’aderenza allo schema. Ollama raccomanda il determinismo.
- Validare e potenzialmente prevedere un fallback (ad es. retry o pulizia) quando l’analisi JSON o la validazione dello schema fallisce.
- Inizia con uno schema più semplice, poi estendilo gradualmente. Non complicare eccessivamente all’inizio.
- Includi istruzioni di errore utili ma vincolanti: ad esempio, se il modello non riesce a compilare un campo obbligatorio, rispondere con
nullanziché ometterlo (se il tuo schema lo consente).
Esempio Go 1: Estrazione delle Funzionalità di un LLM
Ecco un semplice programma Go che chiede a Qwen3 un output strutturato sulle funzionalità di un LLM.
package main

import (
	"context"
	"encoding/json"
	"fmt"
	"log"

	"github.com/ollama/ollama/api"
)

type LLMFeatures struct {
	Name             string   `json:"name"`
	SupportsThinking bool     `json:"supports_thinking"`
	MaxContextTokens int      `json:"max_context_tokens"`
	Languages        []string `json:"languages"`
}

func main() {
	client, err := api.ClientFromEnvironment()
	if err != nil {
		log.Fatal(err)
	}

	prompt := `
  Analyze the following description and return the model’s features in JSON only.
  Description:
  "Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
  It allows reasoning steps (chain-of-thought).
  The context window is 128K tokens."
  `

	// Define the JSON schema for structured output
	formatSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"name": map[string]string{
				"type": "string",
			},
			"supports_thinking": map[string]string{
				"type": "boolean",
			},
			"max_context_tokens": map[string]string{
				"type": "integer",
			},
			"languages": map[string]any{
				"type": "array",
				"items": map[string]string{
					"type": "string",
				},
			},
		},
		"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
	}

	// Convert schema to JSON
	formatJSON, err := json.Marshal(formatSchema)
	if err != nil {
		log.Fatal("Failed to marshal format schema:", err)
	}

	req := &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  formatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var features LLMFeatures
	var rawResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		rawResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(rawResponse), &features); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	fmt.Printf("Parsed struct: %+v\n", features)
}
Per compilare ed eseguire questo programma Go di esempio, supponiamo di avere questo file main.go in una cartella ollama-struct,
Dobbiamo eseguire all’interno di questa cartella:
# initialise module
go mod init ollama-struct
# pull all the dependencise
go mod tidy
# build & execute
go build -o ollama-struct main.go
./ollama-struct
Esempio di Output
Parsed struct: {Name:Qwen3 SupportsThinking:true MaxContextTokens:128000 Languages:[Inglese Cinese Francese Spagnolo Arabo]}
Esempio Go 2: Confronto di più Modelli
Puoi estendere questo per estrarre un elenco di modelli per il confronto.
  type ModelComparison struct {
		Models []LLMFeatures `json:"models"`
	}

	prompt = `
	Extract features from the following model descriptions and return as JSON:

	1. PaLM 2: This model has limited reasoning capabilities and focuses on basic language understanding. It supports a context window of 8,000 tokens. It primarily supports English language only.
	2. LLaMA 2: This model has moderate reasoning abilities and can handle some logical tasks. It can process up to 4,000 tokens in its context. It supports English, Spanish, and Italian languages.
	3. Codex: This model has strong reasoning capabilities specifically for programming and code analysis. It has a context window of 16,000 tokens. It supports English, Python, JavaScript, and Java languages.

	Return a JSON object with a "models" array containing all models.
	`

	// Define the JSON schema for model comparison
	comparisonSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"models": map[string]any{
				"type": "array",
				"items": map[string]any{
					"type": "object",
					"properties": map[string]any{
						"name": map[string]string{
							"type": "string",
						},
						"supports_thinking": map[string]string{
							"type": "boolean",
						},
						"max_context_tokens": map[string]string{
							"type": "integer",
						},
						"languages": map[string]any{
							"type": "array",
							"items": map[string]string{
								"type": "string",
							},
						},
					},
					"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
				},
			},
		},
		"required": []string{"models"},
	}

	// Convert schema to JSON
	comparisonFormatJSON, err := json.Marshal(comparisonSchema)
	if err != nil {
		log.Fatal("Failed to marshal comparison schema:", err)
	}

	req = &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  comparisonFormatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var comp ModelComparison
	var comparisonResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		comparisonResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(comparisonResponse), &comp); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	for _, m := range comp.Models {
		fmt.Printf("%s: Context=%d, Languages=%v\n", m.Name, m.MaxContextTokens, m.Languages)
	}
Esempio di Output
PaLM 2: Context=8000, Languages=[Inglese]
LLaMA 2: Context=4000, Languages=[Inglese Spagnolo Italiano]
Codex: Context=16000, Languages=[Inglese Python JavaScript Java]
A proposito, qwen3:4b funziona bene su questi esempi, proprio come qwen3:8b.
Migliori Pratiche per gli Sviluppatori Go
- Imposta la temperatura a 0 per una massimale aderenza allo schema.
- Valida con
json.Unmarshale usa un fallback se l’analisi fallisce. - Mantieni gli schemi semplici — le strutture JSON profondamente annidate o ricorsive potrebbero causare problemi.
- Consenti campi opzionali (usa
omitemptynei tag delle strutture Go) se ti aspetti dati mancanti. - Aggiungi retry se il modello occasionalmente emette JSON non valido.
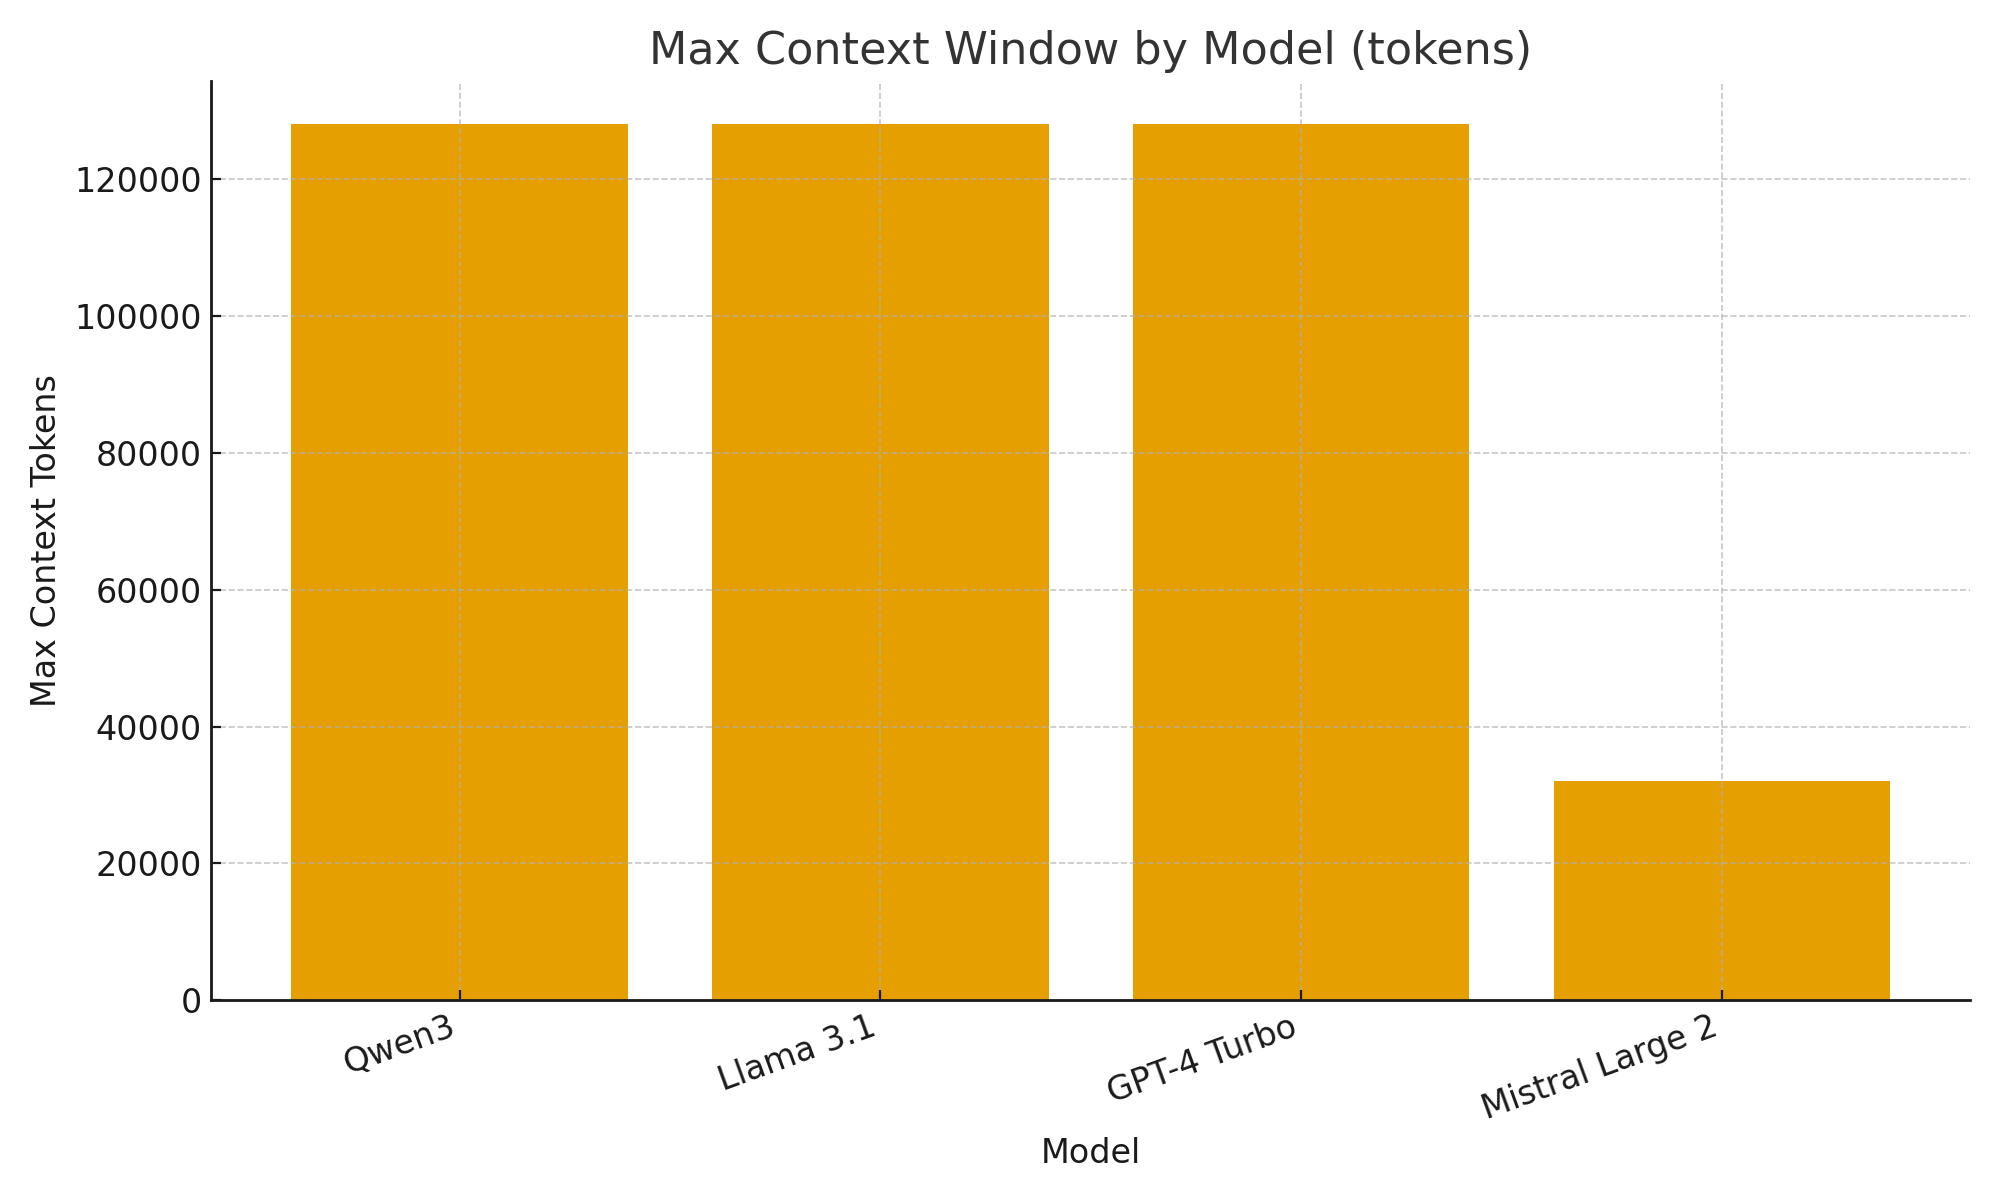
Esempio Completo - Disegno di un Grafico con Specifiche LLM (Passo dopo passo: da JSON strutturato a tabelle di confronto)
- Definisci uno schema per i dati che desideri
Usa Pydantic in modo da poter sia (a) generare uno Schema JSON per Ollama e (b) validare la risposta del modello.
from pydantic import BaseModel
from typing import List, Optional

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]
- Chiedi a Ollama di restituire solo JSON in quella forma
Passa lo schema in format= e abbassa la temperatura per il determinismo.
from ollama import chat

prompt = """
Extract features for each model. Return JSON only matching the schema.
1) Qwen3 supports chain-of-thought; 128K context; English, Chinese, French, Spanish, Arabic.
2) Llama 3.1 supports chain-of-thought; 128K context; English.
3) GPT-4 Turbo supports chain-of-thought; 128K context; English, Japanese.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format={"type": "array", "items": LLMFeatures.model_json_schema()},
    options={"temperature": 0}
)

raw_json = resp.message.content  # JSON list of LLMFeatures
- Validazione e normalizzazione
Valida sempre prima dell’uso in produzione.
from pydantic import TypeAdapter

adapter = TypeAdapter(list[LLMFeatures])
models = adapter.validate_json(raw_json)  # -> list[LLMFeatures]
- Costruisci una tabella di confronto (pandas)
Trasforma i tuoi oggetti validati in un DataFrame che puoi ordinare/filtrare ed esportare.
import pandas as pd

df = pd.DataFrame([m.model_dump() for m in models])
df["languages_count"] = df["languages"].apply(len)
df["languages"] = df["languages"].apply(lambda xs: ", ".join(xs))

# Reorder columns for readability
df = df[["name", "supports_thinking", "max_context_tokens", "languages_count", "languages"]]

# Save as CSV for further use
df.to_csv("llm_feature_comparison.csv", index=False)
- (Facoltativo) Visualizzazioni rapide
Grafici semplici ti aiutano a valutare visivamente le differenze tra i modelli rapidamente.
import matplotlib.pyplot as plt

plt.figure()
plt.bar(df["name"], df["max_context_tokens"])
plt.title("Max Context Window by Model (tokens)")
plt.xlabel("Model")
plt.ylabel("Max Context Tokens")
plt.xticks(rotation=20, ha="right")
plt.tight_layout()
plt.savefig("max_context_window.png")
In Sintesi
Con il nuovo supporto per l’output strutturato di Ollama, puoi trattare gli LLM non solo come chatbot, ma come motori di estrazione dati.
Gli esempi sopra hanno mostrato come estrarre automaticamente metadati strutturati sulle funzionalità degli LLM come supporto al ragionamento, dimensione della finestra di contesto e lingue supportate — compiti che altrimenti richiederebbero un’analisi fragile.
Che tu stia costruendo un catalogo di modelli LLM, un dashboard di valutazione o un assistente di ricerca alimentato da IA, gli output strutturati rendono l’integrazione fluida, affidabile e pronta per la produzione.
