
ASIC LLM i specjalizowane układy do inferencji (dlaczego są ważne)
ASICy i dedykowane układy półprzewodnikowe zwiększają szybkość i wydajność inferencji modeli LLM
Przyszłość AI to nie tylko kwestia bardziej inteligentnych modeli. Dotyczy ona również półprzewodników, które są dostosowane do rzeczywistego sposobu uruchamiania tych modeli. Specjalistyczny sprzęt do wnioskowania LLM podąża ścieżką przypominającą ewolucję kopania Bitcoina od GPU po dedykowane układy ASIC, jednak w znacznie trudniejszych warunkach, ponieważ modele i schematy precyzji wciąż się zmieniają.
Więcej informacji na temat przepustowości, opóźnień, pamięci VRAM oraz testów porównawczych na różnych środowiskach i sprzęcie znajdziesz w artykule LLM Performance: Benchmarks, Bottlenecks & Optimization.
 Wyobraźnia Elektryczna - Flux text to image LLM.
Dlaczego LLM-y odgrywają rolę sprzętu do wnioskowania
Wielkie modele językowe zrewolucjonizowały AI, ale każda płynna odpowiedź zależy od ogromnych, przewidywalnych strumieni obliczeń macierzowych i ruchu pamięci. Wraz ze wzrostem kosztów wnioskowania — często przewyższających koszty treningu w cyklu życia modelu — układy zoptymalizowane do obsługi (serving), a nie do każdego możliwego obciążenia, stają się ekonomicznie atrakcyjne.
Analogia z kopaniem Bitcoina jest niedoskonała, ale pouczająca. Oba to zadania powtarzalne i o zdefiniowanych granicach, w których usunięcie niepotrzebnej ogólności z układu może przynieść znaczące zyski w przepustowości i dżule na przydatną operację.
Co historia kopania Bitcoina mówi o ASIC-ach do wnioskowania
Kopanie Bitcoina ewoluowało przez cztery pokolenia:
| Era | Sprzęt | Główna korzyść | Ograniczenie |
|---|---|---|---|
| 2015–2020 | GPU (CUDA, ROCm) | Elastyczność | Duże zużycie energii, ograniczenia pamięci |
| 2021–2023 | TPU, NPU | Specjalizacja o dużym ziarnie | Nadal nastawione na trening |
| 2024–2025 | ASIC Transformatory | Dostosowane do wnioskowania o niskiej precyzji | Ograniczona ogólność |
AI podąża podobną ścieżką. Każda zmiana generacji poprawiła wydajność i efektywność energetyczną o rząd wielkości.
Jednak, w przeciwieństwie do ASIC-ów do Bitcoina (które liczą wyłącznie SHA-256), ASIC-i do wnioskowania potrzebują pewnej elastyczności. Modele się zmieniają, architektury się rozwijają, a schematy precyzji ulepszają. Kluczem jest specjalizacja właściwego stopnia — twardokodowanie wzorców rdzeniowych przy zachowaniu adaptacyjności na krawędziach.
Jak wnioskowanie LLM różni się od treningu (i co wykorzystują układy)
Obciążenia wnioskowania ujawniają wzorce, które specjalistyczny sprzęt może wykorzystać:
- Dominuje niska precyzja — arytmetyka 8-bitowa, 4-bitowa, a nawet trójwartościowa lub binarna dobrze działa we wnioskowaniu
- Pamięcią jest wąskim gardłem — Przesyłanie wag i pamięci podręcznej KV zużywa znacznie więcej energii niż obliczenia
- Opóźnienia są ważniejsze niż przepustowość — Użytkownicy oczekują tokenów w mniej niż 200 ms
- Masywne równoległe żądania — Tysiące równoległych żądań wnioskowania na układ
- Przewidywalne wzorce — Warstwy transformatora są silnie zstructured i mogą być twardokodowane
- Możliwości rzadkości (sparsity) — Modele coraz częściej stosują techniki przycinania i MoE (Mixture-of-Experts)
Dedykowany układ do wnioskowania może twardokodować te założenia, osiągając 10–50-krotnie lepszą wydajność na wat w porównaniu z ogólnymi GPU.
Kto tworzy krzem zoptymalizowany pod wnioskowanie LLM
Rynek ASIC-ów do wnioskowania obejmuje obecnych liderów, projektory w skali wafla oraz startupy stawiające na krzem o kształcie transformatora:
| Firma | Układ / Platforma | Specjalność |
|---|---|---|
| Groq | LPU (Language Processing Unit) | Deterministyczna przepustowość dla LLM |
| Etched AI | ASIC Sohu | Twardokodowany silnik transformatora |
| Tenstorrent | Grayskull / Blackhole | Ogólny ML z wysokiej przepustowości meshem |
| Taalas | HC1 (produkt Llama 3.1 8B) / droga rozwoju HC2 | Krzem „hardcore” dla konkretnego modelu; łączenie pamięci i obliczeń |
| OpenAI × Broadcom | Własny układ do wnioskowania | Pogłoski o wdrożeniu w 2026 r. |
| Intel | Crescent Island | GPU Xe3P tylko do wnioskowania z 160 GB HBM |
| Cerebras | Wafer-Scale Engine (WSE-3) | Ogromna przepustowość pamięci na die |
Duża część tego sprzętu jest już w użyciu w centrach danych produkcyjnych, a nie tylko na slajdach. Mniejsze zespoły, takie jak d-Matrix, Rain AI, Mythic i Tenet, również rozwijają architektury dostosowane do wnioskowania o niskiej precyzji i strukturalnej rzadkości.
Taalas HC1, Chat Jimmy i ultrabłyskawiczne serwowanie małych modeli
Taalas to niedawny przykład szkoły „specjalizacja prawie wszystkiego”. Firma argumentuje, że granica pamięć–obliczenia (DRAM poza chipem versus SRAM w chipie) dominuje nad kosztami, energią i złożonością inżynieryjną we wnioskowaniu, a krzem dla konkretnego modelu — nazywany przez nich Modelami Hardcore — może zniwelować tę granicę, jeśli wdrożenie jest gotowe zafiksować wagi i graf.
Ich pierwszy produkt dostarczany na rynek, HC1, twardokoduje wariant Llama 3.1 8B. Ten wybór jest pragmatyczny: model jest na tyle mały, aby szybko go uruchomić, jest dobrze udokumentowany i wciąż przydatny do wielu zadań automatyzacji, klasyfikacji i szkicowania, gdzie głębokość rozumowania liczy się mniej niż opóźnienie i koszt. Taalas raportuje około 16–17 tys. zdekodowanych tokenów na sekundę na użytkownika dla tej konfiguracji (metodologia i porównania są dostępne w ich publikacji), obok twierdzeń o dużych zyskach w kapitale i energii w porównaniu z konwencjonalnymi stosami GPU dla tej samej klasy modeli. Układy pierwszej generacji używają agresywnego mieszania niskiej precyzji; firma opisuje przejście do standardowych 4-bitowych formatów zmiennoprzecinkowych w HC2, aby odzyskać zapas wydajności jakości.
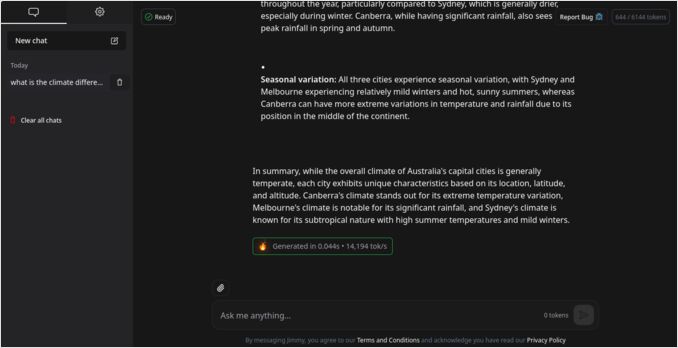
Dla deweloperów, którzy chcą doświadczyć, co oznacza taka klasa przepustowości w praktyce, Taalas oferuje darmowy demo czatbota, Chat Jimmy, oraz zapewnia dostęp do API poprzez formularz zgłoszeniowy na swojej stronie. Jest to wyraźnie koncept dowodowy — nie asystent klasy frontier — ale ilustruje rzeczywistą grupę odbiorców, którzy mogą preferować skromny model działający z „prędkością myślenia ludzkiego” zamiast większego modelu, który wydaje się powolny lub kosztowny.
Architektura ASIC-a do wnioskowania transformatora
Jak właściwie wygląda układy zoptymalizowany pod transformator pod maską?
+--------------------------------------+
|         Interfejs Gościa             |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  Połączenia wewnętrzne na chipie     |
|  (mesh/obręcz)                       |
+--------------------------------------+
|  Kafle obliczeniowe / Rdzenie        |
|   — Jednostki mnożenia macierzowego  |
|   — ALU o niskiej precyzji (int8/int4)|
|   — Jednostki dewantyzacji i aktywności|
+--------------------------------------+
|  SRAM i bufor pamięci KV na chipie   |
|   — Gorące wagi, spięte cache        |
+--------------------------------------+
|  Rury do kwantyzacji / dewantyzacji  |
+--------------------------------------+
|  Harmonogramista / Kontroler         |
|   — Silnik wykonywania statycznego   |
|     grafu                            |
+--------------------------------------+
|  Interfejs DRAM / HBM poza chipem    |
+--------------------------------------+
Kluczowe funkcje architektoniczne obejmują:
- Rdzenie obliczeniowe — Gęste jednostki mnożenia macierzowego zoptymalizowane pod int8, int4 i operacje trójwartościowe
- SRAM na chipie — Duże bufora przechowują gorące wagi i pamięć podręczną KV, minimalizując kosztowne dostępy do DRAM
- Przepływowe połączenia — Topologia mesh umożliwia efektywne skalowanie między wieloma chipami
- Silniki kwantyzacji — Kwantyzacja/dewantyzacja w czasie rzeczywistym między warstwami
- Stack kompilatora — Tłumaczy grafy PyTorch/ONNX bezpośrednio na mikrooperacje specyficzne dla chipa
- Twardokodowane rdzenie uwagi — Eliminuje narzut przepływu sterowania dla softmaxu i innych operacji
Filozofia projektu odzwierciedla ASIC-i do Bitcoina: każdy tranzystor służy konkretnemu obciążeniu. Żadnego marnowania krzemu na funkcje niepotrzebne do wnioskowania.
Testy porównawcze GPU versus ASIC dla wnioskowania LLM
Reprezentatywne publiczne dane pokazują, jak specjalistyczny sprzęt do wnioskowania może odejść od ogólnych stosów GPU na tych samych rodzinach modeli (zawsze weryfikuj metodykę i założenia dotyczące batchy dla własnych obciążeń):
| Model | Sprzęt | Przepustowość (tokeny/s) | Czas do pierwszego tokenu | Mnożnik wydajności |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1,7 s | Punkt odniesienia (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0,22 s | 3–18× szybszy |
| Llama-3.3-70B | Groq LPU | ~276 | ~0,2 s | Konsekwentnie 3× |
| Gemma-7B | Groq LPU | 814 | <0,1 s | 5–15× szybszy |
| Llama-3.1-8B | Taalas HC1 (dane producenta) | ~16–17 tys. tokenów/s/użytkownika (dekodowanie) | — | Osobna oś (stały graf 8B, nie 70B) |
Źródła: Groq.com, ArtificialAnalysis.ai, NVIDIA Developer Blog; dane Taalas HC1 pochodzą z postu produktowego firmy.
Wiersze dotyczące Groq pokazują duże zyski w przepustowości i czasie do pierwszego tokenu w porównaniu z zaawansowanym GPU przy dużych modelach. Wiersz dla Taalas nie jest kolejnym mnożnikiem względem tych linii 70B; ilustruje, jak daleko można pchnąć dekodowanie na użytkownika, gdy model i graf są zafiksowane w krzemie, kosztem elastyczności.
Kompromisy przy specjalizacji krzemu do wnioskowania
Specjalizacja przynosi wydajność, ale przywraca ryzyko produktowe i inżynieryjne:
-
Elastyczność versus Efektywność. W pełni zafiksowany ASIC świetnie radzi sobie z dzisiejszymi modelami transformatora, ale może mieć trudności z jutrzejszymi architekturami. Co się stanie, gdy mechanizmy uwagi się zmienią lub pojawią się nowe rodziny modeli? To nie jest hipoteza — modele przestrzeni stanu, dyfuzyjne modele językowe i modele świata JEPA już kwestionują dominację transformatora po stronie modeli; zobacz co nastąpi po LLM-ach, aby dowiedzieć się, gdzie te architektury mogą pozostawić twardokodowany krzem transformatora.
-
Kwantyzacja i Dokładność. Niższa precyzja oszczędza ogromne ilości energii, ale zarządzanie degradacją dokładności wymaga zaawansowanych schematów kwantyzacji. Nie wszystkie modele kwantyzują się dobrze do 4 bitów lub mniej.
-
Ekosystem oprogramowania. Sprzęt bez solidnych kompilatorów, rdzeni i frameworków jest bezużyteczny. NVIDIA wciąż dominuje w dużej mierze dzięki dojrzałemu ekosystemowi CUDA. Nowi producenci chipów muszą mocno inwestować w oprogramowanie.
-
Koszt i Ryzyko. Wytłoczenie układu kosztuje dziesiątki milionów dolarów i zajmuje 12–24 miesiące. Dla startupów to ogromna stawka na założenia architektoniczne, które mogą się nie sprawdzić.
Niemniej, w skali hiperskaliowania, nawet dwukrotny zysk efektywności przekłada się na miliardy oszczędności. Dla dostawców chmury przetwarzających miliony żądań wnioskowania na sekundę, własny krzem staje się coraz bardziej niezbywalny.
Lista życzeń dla układu do wnioskowania LLM
| Cecha | Idealna Specyfikacja |
|---|---|
| Proces | Tłok 3–5 nm |
| SRAM na chipie | 100 MB lub więcej ściśle sprzężonych |
| Precyzja | Natywne wsparcie int8 / int4 / trójwartościowe |
| Przepustowość | 500+ tokenów/sek (model 70B) |
| Opóźnienie | <100 ms do pierwszego tokenu |
| Połączenia | Mesh o niskim opóźnieniu lub łącza optyczne |
| Kompilator | Łańcuch narzędzi PyTorch/ONNX → mikrokodek |
| Energia | <0,3 dżule na token |
Spojrzenie w przyszłość (2026–2030)
Można oczekiwać, że krajobraz sprzętu do wnioskowania ustratyfikuje się w trzy szerokie poziomy:
-
Układy do treningu. Zaawansowane GPU, takie jak NVIDIA B200 i AMD Instinct MI400, będą nadal dominować w treningu dzięki elastyczności FP16/FP8 i ogromnej przepustowości pamięci.
-
ASIC-i do wnioskowania. Twardokodowane akceleratory transformatora o niskiej precyzji będą obsługiwać serwing produkcyjny w skali hiperskaliowania, zoptymalizowane pod koszt i efektywność.
-
NPU na krawędzi (Edge). Małe, ultraefektywne układy wprowadzą skwantyzowane LLM-y do smartfonów, pojazdów, urządzeń IoT i robotów, umożliwiając inteligencję na urządzeniu bez zależności od chmury.
Poza samym sprzętem zobaczymy:
- Hibrydowe klastry — GPU do elastycznego treningu, ASIC-i (lub silniki wnioskowania w skali wafla) do efektywnego serwingu
- Wnioskowanie jako usługa — Hiperskalery mieszający akceleratory pierwszej strony (AWS Inferentia, Google TPU i inne) z GPU
- Współprojektowanie sprzętu i oprogramowania — Modele kształtowane pod rzadkość blokową, routing MoE i warstwy przyjazne kwantyzacji
- Krzem dla konkretnego modelu lub rodziny — Firmy takie jak Taalas stawiające, że niektóre wdrożenia będą wymieniać elastyczność architektoniczną na ekstremalny koszt i opóźnienia przy znanym grafie
- Otwarte API wnioskowania — Presja na utrzymanie przenośności interfejsów serwingu, nawet gdy krzem nie jest przenośny
Końcowe myśli
„ASIC-izacja” wnioskowania AI już się rozpoczęła. Tak samo, jak kopanie Bitcoina ewoluowało od CPU po specjalistyczny krzem, wdrażanie AI podąża tą samą ścieżką.
Następna rewolucja w AI nie będzie dotyczyła większych modeli — będzie dotyczyła lepszych chipów. Sprzęt zoptymalizowany pod specyficzne wzorce wnioskowania transformatora zadecyduje, kto będzie mógł ekonomicznie wdrażać AI w dużej skali.
Tak samo, jak kopacze Bitcoina optymalizowali każdy zmarnowany wat, sprzęt do wnioskowania będzie wyłuskiwał każdy ostatni FLOP na dżul. Kiedy to się stanie, prawdziwy przełom nie nastąpi w algorytmach — nastąpi w krzemie, na którym działają.
Przyszłość AI jest wytrącana w krzemie, jeden tranzystor po drugim.
Po więcej testów porównawczych, wyborów sprzętowych i strojenia wydajności, sprawdź nasze centrum LLM Performance: Benchmarks, Bottlenecks & Optimization.
Przydatne Linki
- Oficjalne testy porównawcze Groq
- Taalas — Ścieżka do powszechnej AI (HC1, mapa drogowa, filozofia)
- Chat Jimmy — demo Taalas Llama 3.1 8B
- Formularz zgłoszeniowy do dostępu API Taalas
- Artificial Analysis - Lider wydajności LLM
- Techniczna notatka NVIDIA H100
- Etched AI - Ogłoszenie ASIC Transformatora
- Wafer-Scale Engine Cerebras
- Ceny kart NVidia RTX 5080 i RTX 5090 w Australii - październik 2025
- Wydajność LLM i przewody PCIe: Kluczowe kwestie
- Test prędkości Wielkich Modeli Językowych
- Porównanie przydatności GPU NVidia dla AI
- Czy Quadro RTX 5880 Ada 48GB jest dobry?
