Security

Samowzmacniające pętle pamięci w agentach AI: przyczyny i rozwiązania

Samowzmacniające pętle pamięci w agentach AI: przyczyny i rozwiązania

„Gdy zapamiętane wnioski stają się nowymi dowodami.”

Trwałe pamięć zamienia agenta w narzędzie, które niesie kontekst dalej, zamiast wymagać każdego razy wyjaśnień, ale otwiera również tryb błędu, którego unikają czaty bezstanowe: interpretacja może stać się pamięcią, być odzyskaną jako fakt i uzasadniać mocniejszą wersję samą.
Grawitacja danych: prawdziwa koszt strategii API-first w sztucznej inteligencji

Grawitacja danych: prawdziwa koszt strategii API-first w sztucznej inteligencji

Dlaczego Twój stos AI staje się co miesiąc bardziej kleisty.

Każde wywołanie API wydaje się prostą transakcją – dopóki nie gromadzi się ich na tyle dużo, że dane do dostrojenia, zestawy do ewaluacji oraz schematy narzędzi nie zaczynają być ukształtowane wokół jednego dostawcy, a zmiana dostawcy przestaje być jedynie zmianą routingu.

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Ochronne mechanizmy dla LLM w praktyce: co naprawdę działa

Kontroluj ryzyko, nie tylko model.

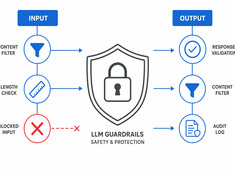
Modele językowe (LLM) są nieprzewidywalne. Mogą halucynować, wyciekać dane, generować szkodliwe treści lub odmawiać spełnienia legalnych żądań. Mechanizmy ochronne (guardrails) ograniczają zachowanie modelu, nie tracąc przy tym jego możliwości.