Gpu

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

Dlaczego kontekst 128K zawodzi na 16 GB

Model może reklamować okno kontekstowe 128K i mimo to zawiedzie przy 40K tokenach na karcie GPU 16 GB. Architektoniczny limit nigdy nie gwarantował, że wagi, cache KV, bufora obliczeniowe i kompozytor pulpitu zmieszczą się jednocześnie na Twojej karcie.
GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

Porównanie GPU AI trzech dostawców

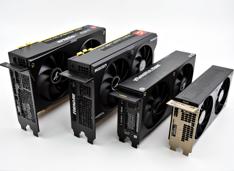
Krajobraz sprzętu do sztucznej inteligencji uległ znaczącej zmianie w 2026 roku, przy czym NVIDIA, AMD i Intel rywalizują o deweloperów potrzebujących kart graficznych (GPU) zdolnych do uruchamiania lokalnie dużych modeli językowych (LLM) oraz obciążeń wnioskowania (inference).

Ollama w Docker Compose z GPU i trwałym magazynowaniem modeli

Ollama w Docker Compose z GPU i trwałym magazynowaniem modeli

Serwer Ollama w stylu Compose-first z obsługą GPU i trwałym zapisem danych.

Ollama świetnie działa na “gołym” metalu (bez warstwy wirtualizacji). Staje się jeszcze ciekawszy, gdy traktujesz go jak usługę: stabilny punkt końcowy, przypięte wersje, trwałe przechowywanie danych oraz GPU, które jest dostępne, lub go nie ma.