API

Frameworki Go w 2026 roku: porównanie net/http, chi, Gin, Echo i Fiber

Frameworki Go w 2026 roku: porównanie net/http, chi, Gin, Echo i Fiber

Pięć stosów HTTP od Go, jedna platforma testowa, realne dane.

Język Go zawiera w swojej standardowej bibliotece produkcyjnie gotowy serwer HTTP, a od wersji Go 1.22 wbudowany router sam radzi sobie z dopasowaniem metod i parametrów ścieżki. Pytanie o wybór frameworku się zawęziło, ale nie zniknęło.

llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

„Gdy llama-server wyprzedza Ollamę”

Ollama i llama.cpp są często porównywane tak, jakby były rywalizującymi silnikami inferencji. Rzeczywisty wybór polega na decyzji między zarządzaną usługą modeli a zestawem narzędzi, który obsługujesz bezpośrednio.

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Kiedy przejść z Ollamy na vLLM

Ollama to jeden z najprostszych sposobów na uruchomienie lokalnego modelu językowego, jednak wygoda może ukrywać moment, w którym lokalny eksperyment staje się współdzieloną usługą inferencyjną wymagającą lepszego planowania zadań i obserwowalności.

Idempotentność w rozproszonych systemach, która naprawdę działa

Idempotentność w rozproszonych systemach, która naprawdę działa

Zatrzymaj duplikujące efekty uboczne

Idempotentność w rozproszonych systemach to cecha, która ratuje Cię, gdy sieć kłamie, kolejka ponawia próby, klient panikuje, a operator wciska odtwarzanie. W systemach produkcyjnych wielokrotne dostarczanie danych jest normalne. Wielokrotne efekty uboczne to błąd.

Szybki start Vane (Perplexica 2.0) z Ollama i llama.cpp

Szybki start Vane (Perplexica 2.0) z Ollama i llama.cpp

Własna wyszukiwarka AI z lokalnymi modelami LLM

Vane to jeden z bardziej pragmatycznych projektów w przestrzeni „AI-search z cytatami”: samodzielnie hostowany silnik odpowiedzi, który łączy wyszukiwanie na żywej sieci z modelami LLM (lokalnymi lub w chmurze), a jednocześnie pozwala zachować pełną kontrolę nad całym stackiem.

Szybki start z llama.cpp: CLI i serwer

Szybki start z llama.cpp: CLI i serwer

Uruchamiaj modele GGUF za pomocą CLI i serwera

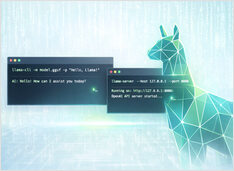
llama.cpp to silnik inferencji w językach C/C++ dla modeli GGUF: llama-cli do interaktywnego czatu, llama-completion do skryptowych promptów oraz llama-server dla kompatybilnego z OpenAI interfejsu API HTTP.

Airtable dla programistów i DevOps - plany, API, Webhooki oraz przykłady w Go i Pythonie

Airtable dla programistów i DevOps - plany, API, Webhooki oraz przykłady w Go i Pythonie

Airtable - ograniczenia planu bezpłatnego, API, webhooks, Go & Python.

Airtable najlepiej można opisać jako platformę o niskim poziomie kodowania, zbudowaną wokół współdzielonego interfejsu “spreadsheet-like” (podobnego do arkusza kalkulacyjnego), który jest świetny do szybkiego tworzenia narzędzi operacyjnych (wewnętrznych śledzi, lekkich CRM, potoków treści, kolejek ocen AI), gdzie nieprogramiści potrzebują przyjaznego interfejsu, a programiści potrzebują powierzchni API do automatyzacji i integracji.