Cheatsheet

Usuń wszystkie modele routera llama.cpp bez restartowania

Usuń wszystkie modele routera llama.cpp bez restartowania

Darmowa pamięć VRAM bez zabijania llama-server.

Tryb routera w llama.cpp to jedna z najbardziej przydatnych zmian wprowadzonych do llama-server w ciągu ostatnich lat. Wreszcie daje lokalnym operatorom modeli LLM coś w rodzaju zarządzania modelami, do którego są przyzwyczajeni z Ollama, jednocześnie zachowując surową wydajność i kontrolę na niskim poziomie, która sprawia, że warto korzystać z llama.cpp w pierwszej kolejności.

llama.swap: szybki start z przełącznikiem modeli dla lokalnych LLM zgodnych z OpenAI

llama.swap: szybki start z przełącznikiem modeli dla lokalnych LLM zgodnych z OpenAI

Gorąca wymiana lokalnych LLMów bez zmian w klientach.

Wkrótce będziesz jugglingiem w vLLM, llama.cpp i wielu innych — każdy stack na własnym porcie. Wszystkie komponenty dół wciąż wymagają jednego /v1 bazowego adresu URL; inaczej będziesz w nieskończoność przesuwać porty, profile i jednorazowe skrypty. llama-swap to /v1 proxy umieszczane przed tymi stackami.

LocalAI QuickStart: Uruchamianie lokalnie modeli LLM zgodnych z OpenAI

LocalAI QuickStart: Uruchamianie lokalnie modeli LLM zgodnych z OpenAI

Uruchom własny serwer z API zgodnym z OpenAI przy użyciu LocalAI w kilka minut.

LocalAI to serwer inferencji typu self-hosted i first-local zaprojektowany tak, aby zachowywał się jak kompatybilny zamiennik API OpenAI do uruchamiania obciążeń AI na Twoim własnym sprzęcie (laptop, stacja robocza lub serwer lokalny).

Szybki start z llama.cpp: CLI i serwer

Szybki start z llama.cpp: CLI i serwer

Uruchamiaj modele GGUF za pomocą CLI i serwera

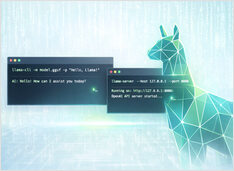
llama.cpp to silnik inferencji w językach C/C++ dla modeli GGUF: llama-cli do interaktywnego czatu, llama-completion do skryptowych promptów oraz llama-server dla kompatybilnego z OpenAI interfejsu API HTTP.