
Kanban dans Hermes Agent pour les workflows de LLM auto-hébergés
Contrôler la charge du Kanban Hermes sur votre LLM auto-hébergé.
L’Agent Hermes est livré avec un tableau de type Kanban et la passerelle Hermes (Hermes Gateway), qui peuvent saturer votre LLM auto-hébergé si trop de tâches sont expédiées en même temps.
Je peux vous affirmer que vous pouvez facilement « ddos » votre propre LLM de cette manière.
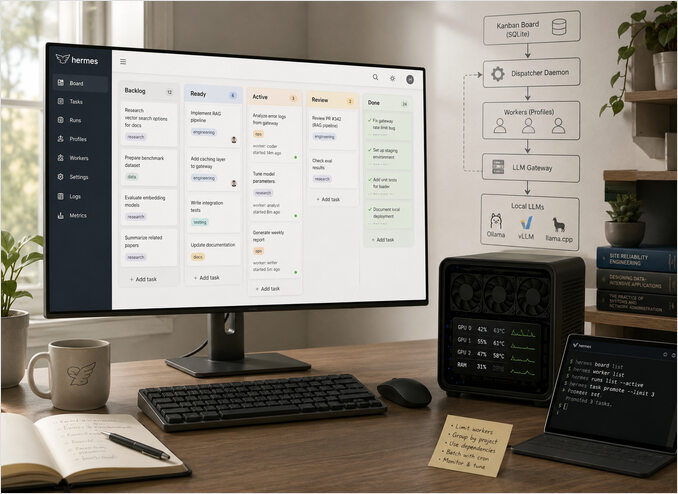
Hermes Kanban est un tableau multi-profiles durable, basé sur ~/.hermes/kanban.db.
Chaque voie (lane) représente une phase de travail, et chaque carte est une tâche qui peut être réclamée par un profil Hermes spécifique.
Par défaut, l’expéditeur (dispatcher) peut promouvoir de nombreuses tâches en état ready en une seule passe. C’est acceptable pour les API cloud élastiques, mais cela peut surcharger un petit cluster GPU auto-hébergé.
Si vous découvrez cette pile technologique, commencez par le guide de configuration et d’exploitation Hermes et par le pilier Systèmes IA pour l’architecture environnante.
Cet article montre comment :
- Comprendre l’interaction entre l’expédition Hermes Kanban et votre passerelle LLM.
- Contrôler la parallelisation en toute sécurité pour les tâches lourdes.
- Regrouper les promotions avec cron afin que les tâches en arrière-plan n’entrent pas en collision avec l’utilisation interactive.
- Surveiller et ajuster le système pour que les GPU restent occupés sans être surchargés.
Fonctionnement d’Hermes Kanban et de l’expéditeur
À haut niveau, le système comporte trois couches :
- Tableau - État SQLite durable pour les tâches, les colonnes, les relations et l’historique.
- Travailleurs - Profils Hermes lancés dans des espaces de travail isolés pour traiter une tâche.
- Expéditeur - Un processus de longue durée qui scanne les cartes expédiables et lance les exécutions.
Les tâches créées depuis l’interface en ligne de commande ou le tableau de bord commencent généralement en état backlog ou ready. Les sous-commandes hermes kanban utilisées ci-dessous sont résumées dans la fiche de référence CLI de l’Agent Hermes.
L’expéditeur scanne les cartes éligibles, en réclame une de manière atomique, puis lance le profil assigné avec ses outils et sa mémoire.
Chaque travailleur appelle ensuite votre passerelle LLM ou votre environnement d’exécution local (par exemple, des points de terminaison compatibles OpenAI basés sur Ollama, vLLM ou llama.cpp). Pour les choix de déploiement entre ces environnements d’exécution, utilisez Hébergement de LLM en 2026 : Comparaison de l’Infrastructure Locale Auto-Hébergée et du Cloud. Si vous ajustez la dispersion des requêtes sur Ollama lui-même, cela s’associe bien avec Comment Ollama gère les requêtes parallèles.
Si vous ajoutez de nombreuses tâches lourdes sans limiter les promotions, votre passerelle peut être inondée de requêtes concurrentes.
Sur un hôte à GPU unique ou limité par le CPU, cela signifie souvent file d’attente, thrashing (dégradations des performances dues à l’échange mémoire) et dépassements de délai au lieu d’un meilleur débit.
La limitation pratique actuelle
Dans les versions actuelles de Hermes utilisées par de nombreuses équipes, la configuration de l’expéditeur n’expose que deux clés de déploiement Kanban et n’applique pas de limite globale de tâches actives via la configuration :
kanban:
  dispatch_in_gateway: false
  dispatch_interval_seconds: 10
Pour le contrôle des tâches actives, appuyez-vous sur une cadence d’expédition explicite (hermes kanban dispatch --max ...) et sur la modélisation des dépendances.
Pièges connus :
- Ne faites pas tourner l’expédition intégrée à la passerelle et
hermes kanban daemon --forcesur le même tableau, ou vous pouvez obtenir des conflits de réclamation (claim races). - Si la passerelle est en panne, les tâches
readyne sont pas expédiées et peuvent former une rafale (burst) plus tard lorsque le service revient. - Des intervalles d’expédition plus longs donnent une sensation irrégulière car la réclamation se fait par pas (ticks).
- Le comportement peut varier d’une version à l’autre, car les cas limites liés à l’état d’exécution et à la réclamation ont été corrigés au fil du temps.
Vérification rapide lorsque le comportement semble incorrect :
# 1) confirmer qu'un seul chemin d'expéditeur est actif
pgrep -af "hermes gateway start|hermes kanban daemon"

# 2) vérifier les clés de l'expéditeur Kanban configurées
rg "dispatch_in_gateway|dispatch_interval_seconds" ~/.hermes/config.yaml

# 3) inspecter la forme de la file d'attente
hermes kanban list --status ready
hermes kanban list --status running
Idées clés :
- La configuration de l’expéditeur câble
dispatch_in_gatewayetdispatch_interval_seconds. dispatch --maxlimite les nouvelles créations (spawns) lors de cette passe, et non le nombre total de tâches en cours d’exécution.- Pour les petits clusters auto-hébergés, commencez de manière conservatrice et n’augmentez les limites qu’une fois que la latence est stable.
Lors du premier déploiement d’Hermes à proximité de votre passerelle LLM :
- Conservez uniquement les clés d’expéditeur Kanban prises en charge dans la configuration.
- Observez l’utilisation du GPU et du CPU sous une pression réelle de file d’attente.
- Utilisez la Stratégie 1 ou la Stratégie 2 pour un rythme de travail déterministe.
Résultats d’investigation et cause racine
hermes kanban dispatch ne lit pas max_active_tasks dans config.yaml.
Dans hermes_cli/kanban.py, la commande d’expédition expose --max comme une limite CLI (valeur par défaut None) et ne transmet que args.max à kb.dispatch_once(...). Il n’y a pas de recherche de configuration max_active_tasks dans ce chemin. Voir hermes_cli/kanban.py brut.
Ensuite, dans kanban_db.dispatch_once, la seule limite est max_spawn, avec une logique équivalente à :
if max_spawn is not None and spawned >= max_spawn:
    break
Il n’y a aucune vérification des tâches déjà en cours d’exécution et aucune référence à max_active_tasks dans ce chemin d’expédition. Voir hermes_cli/kanban_db.py brut.
Comportement effectif :
hermes kanban dispatch
illimité pour cette passe (limité par la taille de la file d’attente ready).
hermes kanban dispatch --max 2
limite uniquement les nouvelles créations lors de cette passe, et non le nombre total de tâches en cours d’exécution.
Les paramètres de configuration câblés autour de l’expédition de la passerelle sont kanban.dispatch_in_gateway et kanban.dispatch_interval_seconds.
Donc, max_active_tasks est ignoré dans ce chemin d’expédition car il n’est pas implémenté là-bas.
Stratégie 1 - Encoder les dépendances pour les flux strictement séquentiels
Certains flux de travail doivent s’exécuter strictement les uns après les autres — par exemple :
- des pipelines de données à plusieurs étapes avec des artefacts intermédiaires partagés
- des migrations ou des modifications d’infrastructure
- des tâches par lots qui écrivent dans le même objet store ou la même base de données
Hermes Kanban prend en charge les dépendances parent-enfant entre les tâches, de sorte qu’une carte enfant ne devient expédiable que lorsque son parent est terminé.
Vous pouvez modéliser cela avec un petit script d’aide autour de la CLI Hermes :
#!/usr/bin/env bash

set -euo pipefail

parent_id="$(hermes kanban add \
  --title 'Ingest customer logs for April' \
  --profile 'etl-worker' \
  --column backlog)"

hermes kanban add \
  --title 'Generate April anomaly report' \
  --profile 'analytics-worker' \
  --column backlog \
  --parent "${parent_id}"

hermes kanban add \
  --title 'Publish April summary to dashboard' \
  --profile 'reporting-worker' \
  --column backlog \
  --parent "${parent_id}"
Avec une politique de tableau appropriée et des limites d’expéditeur basses, seule la tâche parente s’exécute d’abord.
Une fois celle-ci terminée, les tâches enfants deviennent progressivement prêtes, et l’expéditeur les récupère une par une sans jamais dépasser vos limites de concurrence.
Stratégie 2 - Utiliser Linux cron avec une limite d’expédition consciente des tâches en cours
Si vous souhaitez un rythme de travail déterministe, utilisez le cron de l’hôte plus un petit script d’habillage (wrapper).
Au lieu d’appeler toujours dispatch --max 2, comptez d’abord les tâches actuellement en cours d’exécution, puis n’expédiez que les emplacements restants.
Créez hermes-kanban-dispatch-capped.sh :
#!/usr/bin/env bash
set -euo pipefail

MAX_PARALLEL="${MAX_PARALLEL:-2}"
BOARD="${BOARD:-}"

board_args=()
if [[ -n "$BOARD" ]]; then
  board_args=(--board "$BOARD")
fi

# ou là où votre hermes est installé
export PATH="/home/abc/.local/bin:$PATH"

running_out="$(hermes kanban "${board_args[@]}" list --status running)"

if [[ "$running_out" == *"(no matching tasks)"* ]]; then
  running_count=0
else
  running_count="$(printf '%s\n' "$running_out" | wc -l)"
fi

slots=$(( MAX_PARALLEL - running_count ))

if (( slots <= 0 )); then
  echo "Already at limit running=$running_count max=$MAX_PARALLEL dispatch skipped"
  exit 0
fi

echo "running=$running_count max=$MAX_PARALLEL slots=$slots dispatching up to $slots"

hermes kanban "${board_args[@]}" dispatch --max "$slots"
Rendez-le exécutable :
chmod +x ./hermes-kanban-dispatch-capped.sh
Lancez-le avec :
MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Pour un tableau spécifique :
BOARD=my-board MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Planifiez-le une fois par minute avec cron :
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-capped.sh >> /var/log/hermes/kanban-cron.log 2>&1
Notes opérationnelles :
- Cron a souvent un
PATHminimal, donc sihermesn’est pas trouvé, utilisez son chemin complet dans le script (par exemple/usr/local/bin/hermes). - Si vous journalisez dans
/var/log/hermes/..., créez d’abord ce répertoire et assurez-vous que l’utilisateur cron a accès en écriture.
Exemple :
sudo mkdir -p /var/log/hermes
sudo chown "$USER":"$USER" /var/log/hermes
Créez ou modifiez les entrées cron avec :
crontab -e
Puis vérifiez avec :
crontab -l
Cadence inférieure à la minute avec une seule entrée cron
Cron tourne une fois par minute, mais vous pouvez toujours expédier plus fréquemment en exécutant une boucle courte à l’intérieur du script.
Exemple hermes-kanban-dispatch-subminute.sh :
#!/usr/bin/env bash
set -euo pipefail

LOCK_FILE="/tmp/hermes-kanban-dispatch.lock"
RUNS_PER_MINUTE="${RUNS_PER_MINUTE:-4}"    # 4 exécutions => toutes les 15 secondes
CAP_SCRIPT="${CAP_SCRIPT:-/opt/hermes/scripts/hermes-kanban-dispatch-capped.sh}"

exec 9>"$LOCK_FILE"
flock -n 9 || exit 0

sleep_seconds=$(( 60 / RUNS_PER_MINUTE ))

for ((i=1; i<=RUNS_PER_MINUTE; i++)); do
  "$CAP_SCRIPT"

  if (( i < RUNS_PER_MINUTE )); then
    sleep "$sleep_seconds"
  fi
done
Rendez-le exécutable :
chmod +x ./hermes-kanban-dispatch-subminute.sh
Planifiez-le une fois par minute :
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-subminute.sh >> /var/log/hermes/kanban-subminute.log 2>&1
Cela donne une cadence effective inférieure à la minute, tandis que flock empêche les exécutions qui se chevauchent.
Pourquoi cela fonctionne :
list --status runningdonne la charge d’exécution actuelle.dispatch --max Nlimite uniquement les nouvelles créations pour cette passe.- Calculer
Ncomme les emplacements restants maintient le nombre total de tâches en cours d’exécution proche de votre limite cible.
Avertissement important : cette limite ne fonctionne que pour les expéditions effectuées via ce script.
Désactivez l’expédition intégrée à la passerelle, sinon elle peut encore promouvoir des tâches indépendamment :
kanban:
  dispatch_in_gateway: false
Les documents officiels décrivent les deux capacités de commande et notent les valeurs par défaut de l’expédition de la passerelle dans le guide des fonctionnalités Kanban : documentation Hermes Kanban.
Cron interne Hermes
Ne l’utilisez pas.
Voulez-vous vraiment que votre LLM traite des invites régulières comme Execute in terminal the command /path/hermes-kanban-dispatch-capped.sh, surtout quand il est occupé à effectuer un travail utile ?
Surveillance et ajustement d’Hermes Kanban
Quelle que soit la stratégie choisie, vous devez surveiller :
- Les métriques de la passerelle LLM — taux de requêtes, latence, taux d’erreurs, débit de tokens.
- La santé de l’hôte — utilisation du GPU, utilisation de la VRAM, charge du CPU et RAM.
- Les métriques Hermes — combien de tâches sont en backlog, prêtes, actives et terminées.
Pour les lignes de base de métriques de production et les tableaux de bord, voir Surveiller l’inférence LLM en production avec Prometheus et Grafana et le centre de performances LLM.
Commencez avec une faible concurrence, puis augmentez progressivement les limites tout en surveillant :
- l’augmentation de la latence à débit constant
- l’augmentation des erreurs de dépassement de délai ou de limites de débit (rate limit)
- des queues de fin longues où certaines tâches restent actives très longtemps
Dès que vous voyez ces symptômes, revenez à la configuration stable précédente et conservez-la comme valeur par défaut.
Quand Kanban est l’outil approprié
Hermes Kanban brille quand vous avez :
- des files d’attente de recherche ou d’ingénierie de longue durée
- une collaboration multi-agents avec des profils nommés
- des flux de travail qui doivent survivre aux redémarrages et aux réinitialisations de l’hôte
- des humains qui veulent un tableau de bord pour trier le travail
Si vous avez seulement besoin d’une seule exécution pour créer quelques assistants temporaires, les outils intégrés de délégation de tâches sont généralement plus simples.
Dès que vous avez besoin d’historique, de tableaux de bord et d’un contrôle strict sur la manière dont vos agents frappent les LLM auto-hébergés, le tableau Kanban et l’expéditeur sont la base appropriée.
Avec quelques ajustements de configuration et un regroupement par cron facultatif, vous pouvez maintenir Hermes Kanban réactif tout en protégeant votre passerelle et votre matériel.
Pour une vue plus large sur la façon dont les travailleurs en arrière-plan de type Hermes s’intègrent aux architectures d’assistants IA de production — y compris les planificateurs, la surveillance par file d’attente, les protocoles de réclamation, les flux de travail durables et l’évaluation sémantique — voir Agents de surveillance dans les assistants IA : 11 schémas d’implémentation. Lorsque plusieurs profils nommés ou agents spécialisés doivent se coordonner au-delà de la simple expédition de tâches, les Schémas d’orchestration multi-agents couvrent les topologies de coordination — hub-et-rayon, dispersion, essaim — qui sous-tendent les configurations multi-agents plus importantes sur une infrastructure auto-hébergée.
