
Optimisation des coûts pour les systèmes LLM : où le budget est réellement dépensé
« Dépensez les tokens là où ils comptent vraiment. »
Les coûts des LLM (Grandes Modèles de Langage) évoluent de manière linéaire avec l’usage. Un système traitant 10 000 requêtes par jour à 0,01 $ par requête coûte 100 $ par jour, soit 365 $ par an. À l’échelle d’une entreprise, cela dépasse les 10 000 $.
L’optimisation des coûts ne consiste pas à prendre des raccourcis. Il s’agit de dépenser les jetons (tokens) là où cela compte.
Chaque jeton que vous gaspillez est un jeton que vous auriez pu consacrer à une meilleure réponse.
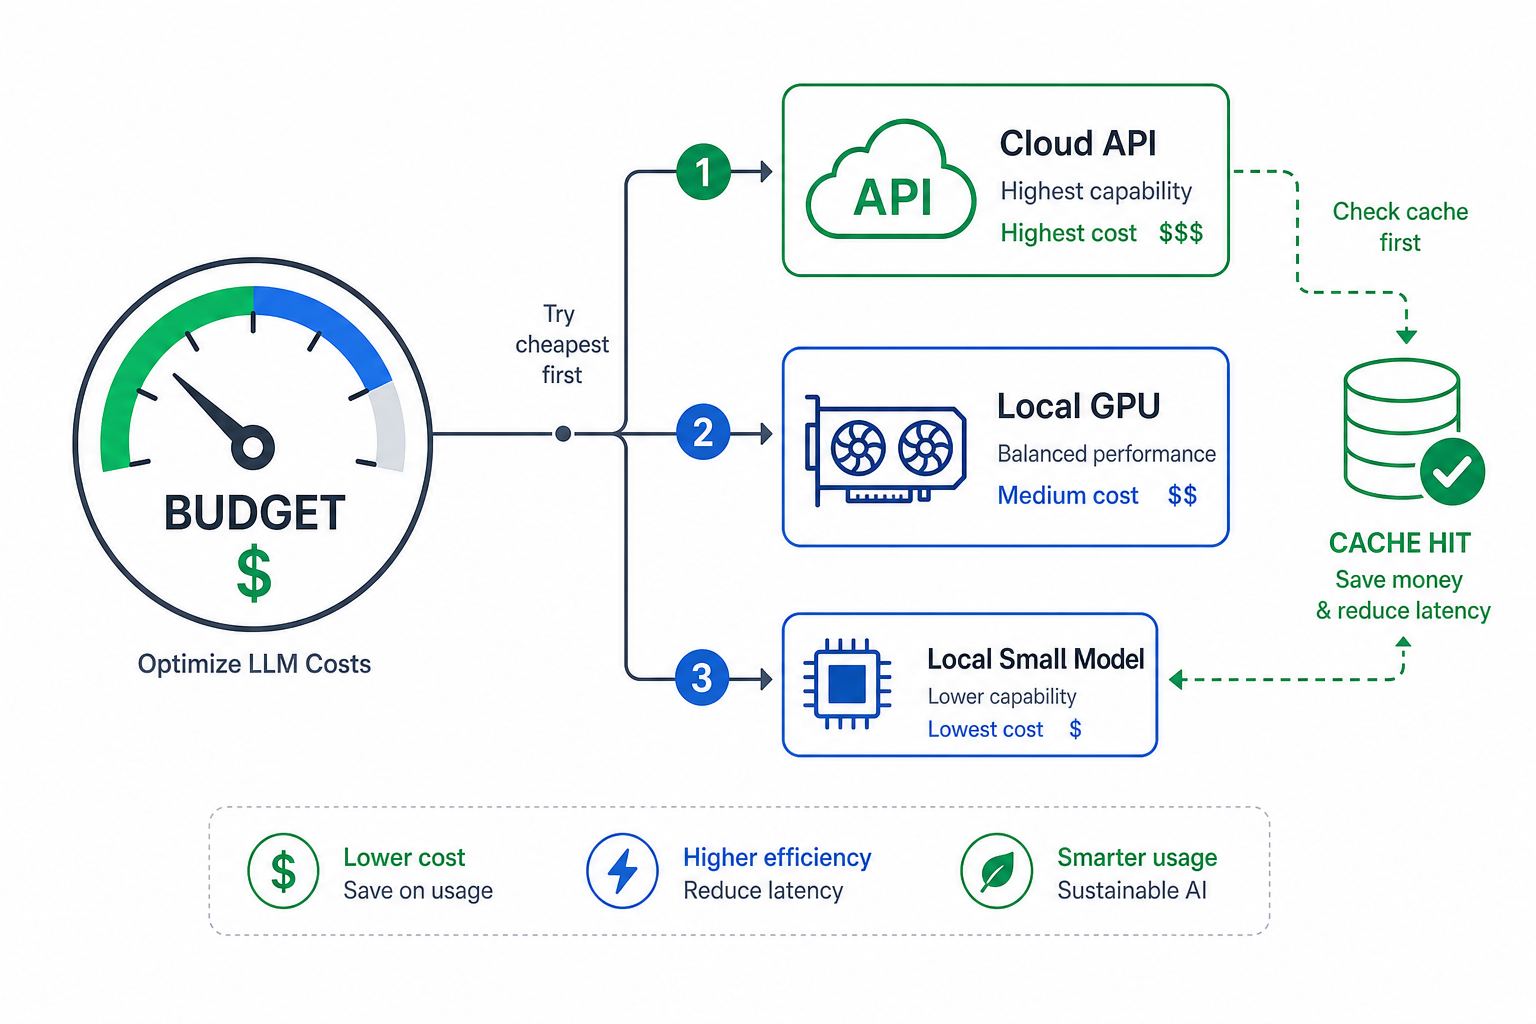
Gestion budgétaire des jetons
La manière la plus simple de maîtriser les coûts consiste à fixer des limites. Par session, par tâche ou par jour.
Stratégie 1 : Budgets par session
Les budgets par session sont simples :
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
Stratégie 2 : Budgets par tâche
Les budgets par tâche sont plus utiles. Différentes tâches nécessitent différentes quantités de contexte :
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
Stratégie 3 : Budgets adaptatifs
Les budgets adaptatifs s’ajustent en fonction de ce qui se passe réellement. Si les tâches de classification utilisent régulièrement 80 jetons, cessez d’allouer 100 :
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
La moyenne mobile exponentielle (poids de 0,9) signifie que les utilisations récentes comptent plus que l’historique. Ajustez le poids en fonction de la volatilité de vos charges de travail.
API vs inférence locale
L’inférence locale est moins chère à grande échelle. Le point d’équilibre dépend de votre matériel et des tarifs de l’API.
| Modèle | API ($/M jetons) | Coût local/heure | Point d’équilibre |
|---|---|---|---|
| GPT-4o | 2,50 $ / 10,00 $ | — | N/A |
| Claude Sonnet 4 | 3,00 $ / 15,00 $ | — | N/A |
| Qwen2.5-72B | 0,50 $ / 2,00 $ | ~0,50 $ | ~4 heures/jour |
| qwen3-32b | 0,30 $ / 1,20 $ | ~0,20 $ | ~2 heures/jour |
| qwen3-8b | 0,10 $ / 0,40 $ | ~0,05 $ | ~1 heure/jour |
Le calcul matériel :
| Matériel | Coût initial | Électricité/mois | Rentabilité vs API |
|---|---|---|---|
| RTX 3090 (occasion) | 600 $ | 15 $ | ~4 mois |
| RTX 4090 | 1 500 $ | 20 $ | ~6 mois |
| RTX 5080 | 1 000 $ | 18 $ | ~5 mois |
| DGX Spark | 2 000 $ | 30 $ | ~8 mois |
À un usage modéré — une heure ou plus par jour — l’inférence locale se rembourse. À un usage élevé, les économies sont considérables. L’obstacle est le capital initial. Une RTX 5080 coûte 1 000 $. Une facture d’API peut être mise en pause. Du matériel, non.
Ce calcul de rentabilité suppose que vous êtes libre de changer de fournisseur, ce qui est souvent l’inconnue majeure plus importante que le coût du matériel. Si vos données de fine-tuning, vos harnais d’évaluation et vos schémas d’outils sont déjà construits autour de l’API d’un fournisseur, le coût réel de la migration est le temps d’ingénierie nécessaire pour défaire cela — pas le prix d’un GPU. La gravité des données : le coût réel de l’IA priorisant les API couvre ce mécanisme de verrouillage ainsi qu’une liste de contrôle pour évaluer à quel point vous en êtes déjà prisonnier, avant de faire ces calculs.
Stratégies de repli
Lorsque votre modèle préféré est trop cher ou trop lent, utilisez un modèle moins coûteux en repli. La clé est de savoir quand la qualité est « suffisante ».
Stratégie 1 : Repli basé sur la qualité
Le repli basé sur la qualité essaie des modèles jusqu’à ce que la sortie atteigne un seuil :
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
Le problème est l’évaluation elle-même. Comment mesurer la qualité sans appeler un autre modèle ? Certains systèmes utilisent un petit classifieur. D’autres utilisent des vérifications heuristiques — longueur, structure, présence de mots-clés. Aucune de ces méthodes n’est parfaite.
Stratégie 2 : Repli basé sur la latence
Le repli basé sur la latence est plus simple. Affectez la requête au modèle le plus rapide qui respecte votre budget de temps :
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
Mémorisation (Caching)
La mise en cache (caching) est l’optimisation des coûts la plus sous-estimée. Des invites identiques surviennent plus souvent que vous ne le pensez — requêtes de classification, interrogations de type FAQ, appels d’outils répétés.
Stratégie 1 : Mise en cache des invites
La mise en cache exacte des invites est simple :
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
Stratégie 2 : Mise en cache sémantique
La mise en cache sémantique est plus utile. Elle capture les invites qui sont différentes mais qui signifient la même chose :
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
Le seuil est important. 0,95 est agressif — seules les invites très similaires sont appariées. 0,85 est plus tolérant mais risque de retourner des réponses incorrectes. Mesurez votre taux d’échec et ajustez.
La mise en cache des réponses pour les requêtes courantes en vaut aussi la peine. Si les utilisateurs demandent à plusieurs reprises « quel est le temps » ou « quelle heure est-il », mettez en cache le motif, pas seulement l’invite exacte :
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
Ce n’est pas sophistiqué, mais cela fonctionne. Les requêtes courantes le sont pour une raison.
Quand l’optimisation aide
L’optimisation est importante lorsque vous traitez de grands volumes, exécutez des charges de travail mixtes ou payez des coûts d’API qui s’accumulent.
Ce n’est pas important lorsque vous créez un prototype, utilisez un seul modèle ou traitez de faibles volumes. La complexité de la gestion budgétaire, du repli et de la mise en cache ne vaut pas le coup pour un système qui effectue 100 requêtes par jour.
Faites d’abord fonctionner le flux de base. Ajoutez l’optimisation lorsque la facture arrive.
Compromis
| Stratégie | Coût | Qualité | Complexité |
|---|---|---|---|
| Aucune optimisation | Le plus élevé | Constante | La plus faible |
| Gestion budgétaire des jetons | Modéré | Variable | Moyenne |
| Modèles de repli | Faible à moyen | Variable | Moyenne |
| Mise en cache | Le plus faible | Élevée (pour les hits de cache) | Moyenne |
| Hybride | Optimisé | Optimisé | La plus élevée |
Les systèmes de production fonctionnent généralement en mode hybride. Budget par session, repli sur la qualité ou la latence, mise en cache de ce qui est possible. La complexité est réelle, mais les économies le sont aussi.
Liens associés
- La gravité des données : le coût réel de l’IA priorisant les API — pourquoi le calcul de rentabilité ci-dessus n’est que la moitié de la décision d’auto-hébergement
- La frontière efficace des modèles ouverts en 2026 — l’économie de la taille des modèles derrière le point d’équilibre : un modèle de 27B sur une 4090 louée contre les prix actuels des jetons Sonnet
- Stratégies de routage de modèles — routage basé sur les capacités, conscient des coûts et de la latence
- Les garde-fous LLM en pratique — validation des entrées, filtrage des sorties, sécurité
- Conception de systèmes multi-modèles — architecture pour plusieurs modèles
- Architecture LLM — pilier de conception système : routage, coût, garde-fous et orchestration
