
PUAS pour LLM et puces d’inférence spécialisées (leur importance)
Les ASIC et le silicium sur mesure boostent la vitesse et l’efficacité de l’inférence des LLM
L’avenir de l’IA ne concerne pas uniquement des modèles plus intelligents. Il s’agit également de la silice qui correspond à la manière dont ces modèles sont réellement servis. Le matériel spécialisé pour l’inférence LLM suit un chemin rappelant la transition du minage de Bitcoin des GPU vers les ASIC dédiés, avec des contraintes plus rigoureuses car les modèles et les recettes de précision continuent d’évoluer.
Pour en savoir plus sur le débit, la latence, la VRAM et les tests de référence (benchmarks) à travers les temps d’exécution (runtimes) et le matériel, consultez Performance LLM : Benchmarks, Goulots d’étranglement & Optimisation.
 Électricité Imaginaire - LLM de texte vers image Flux.
Pourquoi les LLM bénéficient du matériel spécifique à l’inférence
Les grandes langues modèles ont transformé l’IA, mais chaque réponse fluide dépend d’énormes flux prévisibles de calculs matriciels et de trafic mémoire. À mesure que les dépenses d’inférence augmentent — dépassant souvent celles de l’entraînement au cours de la durée de vie d’un modèle — les puces optimisées pour le service (serving), et non pour tous les types de charge de travail possibles, deviennent économiquement attractives.
L’analogie avec le minage de Bitcoin est imparfaite mais instructive. Ce sont deux tâches répétitives et bien délimitées où la suppression de la généralité non utilisée sur la puce peut offrir d’importants gains en débit et en joules par opération utile.
Ce que l’histoire du minage de Bitcoin suggère sur les ASIC d’inférence
Le minage de Bitcoin a évolué à travers quatre générations :
| Ère | Matériel | Avantage Clé | Limitation |
|---|---|---|---|
| 2015–2020 | GPU (CUDA, ROCm) | Flexibilité | Consommation élevée, limité par la mémoire |
| 2021–2023 | TPU, NPU | Spécialisation grossière | Toujours orienté vers l’entraînement |
| 2024–2025 | ASIC Transformer | Ajusté pour l’inférence en bas de bit | Généricité limitée |
L’IA suit un chemin similaire. Chaque transition a amélioré les performances et l’efficacité énergétique de plusieurs ordres de grandeur.
Cependant, contrairement aux ASIC de Bitcoin (qui ne calculent que le SHA-256), les ASIC d’inférence ont besoin d’une certaine flexibilité. Les modèles évoluent, les architectures changent et les schémas de précision s’améliorent. L’astuce est de se spécialiser assez — en câblant en dur les modèles fondamentaux tout en maintenant une adaptabilité aux extrémités.
En quoi l’inférence LLM diffère de l’entraînement (et ce que les puces exploitent)
Les charges de travail d’inférence exposent des modèles que le matériel spécialisé peut cibler :
- Prédominance de la basse précision — l’arithmétique sur 8 bits, 4 bits, voire tertiaire ou binaire, fonctionne bien pour l’inférence
- La mémoire est le goulot d’étranglement — Le déplacement des poids et des caches KV consomme beaucoup plus d’énergie que le calcul
- La latence prime sur le débit — Les utilisateurs s’attendent à recevoir des jetons (tokens) en moins de 200 ms
- Parallélisme massif des requêtes — Des milliers de requêtes d’inférence concurrentes par puce
- Modèles prévisibles — Les couches Transformers sont très structurées et peuvent être câblées en dur
- Opportunités de sparsité — Les modèles utilisent de plus en plus la taille (pruning) et des techniques MoE (Mixture-of-Experts)
Une puce d’inférence sur mesure peut câbler en dur ces hypothèses pour atteindre des performances par watt 10 à 50 fois supérieures à celles des GPU à usage général.
Qui construit de la silice optimisée pour l’inférence LLM
Le marché des ASIC d’inférence couvre les acteurs établis, les conceptions à l’échelle de la wafer et les startups qui misent sur une silice de forme Transformer :
| Entreprise | Puce / Plateforme | Spécialité |
|---|---|---|
| Groq | LPU (Language Processing Unit) | Débit déterministe pour les LLM |
| Etched AI | ASIC Sohu | Moteur Transformer câblé en dur |
| Tenstorrent | Grayskull / Blackhole | ML général avec maillage haute bande passante |
| Taalas | HC1 (produit Llama 3.1 8B) / feuille de route HC2 | Silice « hardcore » spécifique au modèle ; fusionne le stockage et le calcul |
| OpenAI × Broadcom | Puce d’inférence sur mesure | Déploiement annoncé pour 2026 |
| Intel | Crescent Island | GPU Xe3P uniquement pour l’inférence avec 160 Go de HBM |
| Cerebras | Wafer-Scale Engine (WSE-3) | Bande passante mémoire massive sur la puce |
Beaucoup de cela est déjà dans les centres de données de production, pas seulement dans des présentations. Des équipes plus petites comme d-Matrix, Rain AI, Mythic et Tenet poursuivent également des architectures ajustées pour l’inférence en bas de bit et la sparsité structurée.
Taalas HC1, Chat Jimmy et le service ultra-rapide de petits modèles
Taalas est un exemple récent de l’école du « spécialiser presque tout ». L’entreprise soutient que la frontière entre mémoire et calcul (DRAM hors puce par rapport à SRAM sur puce) domine le coût, la consommation et la complexité d’ingénierie pour l’inférence, et que la silice par modèle — ce qu’ils appellent les Hardcore Models — peut effacer cette frontière lorsqu’un déploiement est prêt à figer les poids et le graphe.
Leur premier produit expédié, HC1, câble en dur une variante de Llama 3.1 8B. Ce choix est pragmatique : le modèle est assez petit pour être mis en service rapidement, documenté ouvertement, et reste utile pour de nombreuses tâches d’automatisation, de classification et de rédaction où la profondeur de raisonnement brute importe moins que la latence et le coût. Taalas rapporte de l’ordre de 16 k à 17 k jetons décodés par seconde par utilisateur pour cette configuration (la méthodologie du fournisseur et les comparaisons figurent dans leur compte rendu), accompagné d’affirmations de gains substantiels en capital et en puissance par rapport aux piles GPU conventionnelles pour la même classe de modèles. Les composants de première génération utilisent un stockage mixte agressif en bas de bit ; l’entreprise décrit un passage vers des formats flottants standard de 4 bits sur HC2 pour récupérer de la marge sur la qualité.
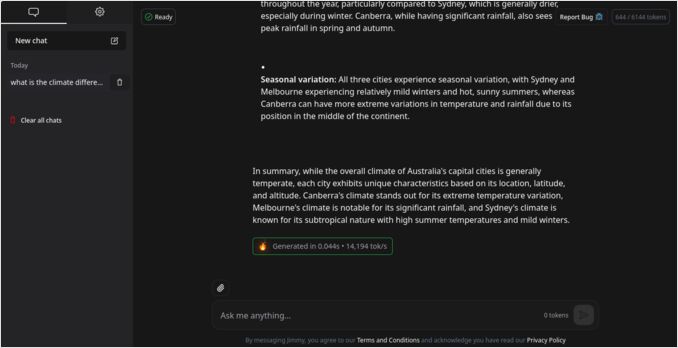
Pour les développeurs qui souhaitent ressentir ce que cette classe de débit implique en pratique, Taalas exécute une démo de chatbot gratuite, Chat Jimmy, et offre un accès API via un formulaire d’application sur leur site. Il s’agit explicitement d’une preuve de concept — et non d’un assistant de pointe — mais cela illustre un public réel qui peut préférer un modèle modeste à la « vitesse de cognition humaine » à un modèle plus grand qui semble lent ou coûteux.
Architecture d’un ASIC d’inférence Transformer
À quoi ressemble concrètement une puce optimisée pour le Transformer sous le capot ?
+--------------------------------------+
|         Interface Hôte               |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  Interconnexion sur puce (maillage/anneau) |
+--------------------------------------+
|  Tuiles / Cœurs de Calcul            |
|   — Unités de multiplication matricielle dense |
|   — ALU basse précision (int8/int4)  |
|   — Unités de déquantification / activation |
+--------------------------------------+
|  SRAM sur puce et tampons cache KV   |
|   — Poids chauds, caches fusionnés   |
+--------------------------------------+
|  Pipelines de Quantification / Déquantification |
+--------------------------------------+
|  Planificateur / Contrôleur          |
|   — Moteur d'exécution de graphe statique |
+--------------------------------------+
|  Interface DRAM / HBM hors puce      |
+--------------------------------------+
Les fonctionnalités architecturales clés incluent :
- Cœurs de calcul — Unités de multiplication matricielle dense optimisées pour les opérations int8, int4 et tertiaires
- SRAM sur puce — De grands tampons stockent les poids chauds et les caches KV, minimisant les accès coûteux à la DRAM
- Interconnexions en streaming — La topologie en maillage permet une mise à l’échelle efficace sur plusieurs puces
- Moteurs de quantification — Quantification/déquantification en temps réel entre les couches
- Pile de compilation (Compiler stack) — Traduit les graphes PyTorch/ONNX directement en micro-opérations spécifiques à la puce
- Noyaux d’attention câblés en dur — Élimine la surcharge de flux de contrôle pour le softmax et d’autres opérations
La philosophie de conception fait écho aux ASIC de Bitcoin : chaque transistor sert la charge de travail spécifique. Aucune silice gaspillée sur des fonctionnalités dont l’inférence n’a pas besoin.
Benchmarks GPU contre ASIC pour l’inférence LLM
Les chiffres publics représentatifs montrent comment le matériel d’inférence spécialisé peut s’éloigner des piles GPU à usage général sur les mêmes familles de modèles (toujours vérifier la méthodologie et les hypothèses de groupage (batching) pour vos propres charges de travail) :
| Modèle | Matériel | Débit (jetons/s) | Temps jusqu’au premier jeton | Multiplicateur de performance |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1,7 s | Référence (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0,22 s | 3 à 18× plus rapide |
| Llama-3.3-70B | Groq LPU | ~276 | ~0,2 s | 3× constant |
| Gemma-7B | Groq LPU | 814 | <0,1 s | 5 à 15× plus rapide |
| Llama-3.1-8B | Taalas HC1 (fournisseur) | ~16 k à 17 k décodage j/s/utilisateur | — | Axe séparé (graphe 8B fixe, non 70B) |
Sources : Groq.com, ArtificialAnalysis.ai, NVIDIA Developer Blog ; chiffres de Taalas HC1 d’après la publication produit de l’entreprise.
Les lignes centrées sur Groq montrent des gains importants en débit et en temps jusqu’au premier jeton par rapport à un GPU de pointe sur de grands modèles. La ligne Taalas n’est pas un autre multiplicateur par rapport à ces lignes 70B ; elle illustre à quel point le décodage par utilisateur peut être poussé lorsque le modèle et le graphe sont figés dans la silice, au prix de la flexibilité.
Compromis lors de la spécialisation de la silice d’inférence
La spécialisation achète la performance, mais elle réintroduit des risques produits et d’ingénierie :
-
Flexibilité contre Efficacité. Un ASIC entièrement fixe traverse les modèles Transformer actuels avec un souffle court, mais pourrait lutter avec les architectures de demain. Que se passe-t-il lorsque les mécanismes d’attention évoluent ou que de nouvelles familles de modèles émergent ? Ce n’est pas une hypothèse — les modèles d’espace d’état, les modèles de langage par diffusion et les modèles de monde JEPA défient déjà la dominance du Transformer côté modèle ; voir ce qui suit les LLM pour savoir où ces architectures pourraient laisser les silices Transformer câblées en dur.
-
Quantification et Précision. Une précision inférieure économise d’énormes quantités d’énergie, mais la gestion de la dégradation de la précision nécessite des schémas de quantification sophistiqués. Tous les modèles ne se quantifient pas gracieusement à 4 bits ou moins.
-
Écosystème Logiciel. Un matériel sans compilateurs, noyaux et cadres (frameworks) robustes est inutile. NVIDIA domine toujours en grande partie grâce à l’écosystème mature de CUDA. Les nouveaux fabricants de puces doivent investir massivement dans le logiciel.
-
Coût et Risque. La mise en fabrication (tape-out) d’une puce coûte des dizaines de millions de dollars et prend 12 à 24 mois. Pour les startups, c’est un pari massif sur des hypothèses architecturales qui pourraient ne pas se tenir.
Néanmoins, à l’échelle hypervisor, même des gains d’efficacité de 2× se traduisent par des milliards d’économies. Pour les fournisseurs cloud exécutant des millions de requêtes d’inférence par seconde, la silice sur mesure devient de plus en plus incontournable.
Spécifications d’un vœu pour une puce d’inférence LLM
| Fonction | Spécification Idéale |
|---|---|
| Process | Nœud 3–5 nm |
| SRAM sur puce | 100 Mo+ fortement couplés |
| Précision | Prise en charge native int8 / int4 / tertiaire |
| Débit | 500+ jetons/sec (modèle 70B) |
| Latence | <100 ms jusqu’au premier jeton |
| Interconnexion | Maillage à faible latence ou liaisons optiques |
| Compilateur | PyTorch/ONNX → chaîne d’outils microcode |
| Énergie | <0,3 joule par jeton |
Perspectives (2026–2030)
Attendez-vous à ce que le paysage du matériel d’inférence se stratifie en trois couches grossières :
-
Puces d’entraînement. Les GPU haut de gamme comme NVIDIA B200 et AMD Instinct MI400 continueront de dominer l’entraînement avec leur flexibilité FP16/FP8 et leur bande passante mémoire massive.
-
ASIC d’inférence. Les accélérateurs Transformer câblés en dur et en basse précision gèreront le service en production à l’échelle hypervisor, optimisés pour le coût et l’efficacité.
-
NPU de bord (Edge). De petites puces ultra-efficaces apporteront des LLM quantifiés aux smartphones, véhicules, appareils IoT et robots, permettant une intelligence sur l’appareil sans dépendance au cloud.
En plus du seul matériel, nous verrons :
- Clusters hybrides — GPU pour l’entraînement flexible, ASIC (ou moteurs d’inférence à l’échelle de la wafer) pour un service efficace
- Inférence en tant que service (Inference-as-a-Service) — Les hyperscalers mêlent des accélérateurs de première partie (AWS Inferentia, Google TPU, et autres) avec des GPU
- Co-conception matériel-logiciel — Modèles façonnés pour la sparsité par blocs, le routage MoE et les couches favorables à la quantification
- Silice par modèle ou par famille — Des entreprises comme Taalas parient que certains déploiements échangeront la flexibilité architecturale contre un coût et une latence extrêmes sur un graphe connu
- API d’inférence ouvertes — Pression pour garder les interfaces de service portables même lorsque la silice ne l’est pas
Réflexions finales
La « ASIC-isation » de l’inférence IA} est déjà en cours. Tout comme le minage de Bitcoin a évolué des CPU vers une silice spécialisée, le déploiement de l’IA} suit le même chemin.
La prochaine révolution de l’IA ne portera pas sur des modèles plus gros — elle portera sur de meilleures puces. Le matériel optimisé pour les motifs spécifiques de l’inférence Transformer déterminera qui peut déployer l’IA économiquement à grande échelle.
Tout comme les mineurs de Bitcoin ont optimisé chaque watt gaspillé, le matériel d’inférence extraira le dernier FLOP-par-joule. Lorsque cela se produira, la véritable percée ne sera pas dans les algorithmes — elle sera dans la silice qui les exécute.
L’avenir de l’IA est gravé dans la silice, un transistor à la fois.
Pour plus de benchmarks, de choix de matériel et d’ajustements de performance, consultez notre pôle Performance LLM : Benchmarks, Goulots d’étranglement & Optimisation.
Liens Utiles
- Benchmarks officiels Groq
- Taalas — La voie vers une IA ubique (HC1, feuille de route, philosophie)
- Chat Jimmy — démo Llama 3.1 8B de Taalas
- Formulaire de demande d’accès API Taalas
- Artificial Analysis - Classement des performances LLM
- Note technique NVIDIA H100
- Etched AI - Annonce de l’ASIC Transformer
- Moteur à l’échelle de la wafer Cerebras
- Prix des NVidia RTX 5080 et RTX 5090 en Australie - Octobre 2025
- Performance LLM et lanes PCIe : Considérations clés
- Test de vitesse des Grandes Langue Modèles
- Comparaison de la pertinence des GPU NVidia pour l’IA
- Le Quadro RTX 5880 Ada 48GB est-il bon ?
