
Contraindre les LLM avec une sortie structurée : Ollama, Qwen3 et Python ou Go
Quelques façons d'obtenir une sortie structurée avec Ollama
Modèles de langage de grande taille (LLM) sont puissants, mais en production nous ne voulons rarement de paragraphes en texte libre. Au contraire, nous voulons des données prévisibles : des attributs, des faits ou des objets structurés que vous pouvez injecter dans une application. C’est là que les Sorties structurées des LLM interviennent.
L’application de schémas (schema enforcement) réduit la fréquence avec laquelle de mauvais logits se transforment en JSON invalide, mais la température et les pénalités restent importantes pour les tempêtes de nouvelles tentatives ; consultez les paramètres de déduction agentic pour Qwen et Gemma lorsque vous combinez des contraintes format avec des agents.
La couche de service a toujours besoin de logique d’analyse, de normalisation et de validation — voir la validation des sorties structurées des LLM en Python qui tient la distance — car Ollama et les clients peuvent ne pas être d’accord sur les chaînes exactes même lorsque format est défini.
Il y a quelque temps, Ollama a introduit la prise en charge des sorties structurées (annonce), rendant possible de contraindre les réponses d’un modèle pour qu’elles correspondent à un schéma JSON. Cela débloque des pipelines d’extraction de données cohérents pour des tâches telles que le catalogage des fonctionnalités des LLM, le benchmarking des modèles ou l’automatisation de l’intégration de systèmes.
Dans cet article, nous allons aborder :
- Ce qu’est la sortie structurée et pourquoi c’est important
- Une méthode simple pour obtenir des sorties structurées des LLM
- Le fonctionnement de la nouvelle fonctionnalité d’Ollama
- Des exemples d’extraction des capacités des LLM :
Qu’est-ce qu’une sortie structurée ?
Normalement, les LLM génèrent du texte libre :
« Le modèle X prend en charge le raisonnement avec chaîne de pensée, dispose d’une fenêtre de contexte de 200K et parle anglais, chinois et espagnol. »
C’est lisible, mais difficile à analyser.
Au lieu de cela, avec les sorties structurées, nous demandons un schéma strict :
{
  "name": "Model X",
  "supports_thinking": true,
  "max_context_tokens": 200000,
  "languages": ["English", "Chinese", "Spanish"]
}
Ce JSON est facile à valider, à stocker dans une base de données ou à transmettre à une interface utilisateur (UI).
Méthode simple pour obtenir des sorties structurées d’un LLM
Les LLM comprennent parfois ce qu’est un schéma et nous pouvons demander au LLM de retourner la sortie en JSON en utilisant un schéma particulier. Le modèle Qwen3 d’Alibaba est optimisé pour le raisonnement et les réponses structurées. Vous pouvez lui indiquer explicitement de répondre en JSON.
Exemple 1 : Utilisation de Qwen3 avec ollama en Python, demande de JSON avec schéma
import json
import ollama

prompt = """
You are a structured data extractor.
Return JSON only.
Text: "Elon Musk is 53 and lives in Austin."
Schema: { "name": string, "age": int, "city": string }
"""

response = ollama.chat(model="qwen3", messages=[{"role": "user", "content": prompt}])
output = response['message']['content']

# Parse JSON
try:
    data = json.loads(output)
    print(data)
except Exception as e:
    print("Error parsing JSON:", e)
Sortie :
{"name": "Elon Musk", "age": 53, "city": "Austin"}
Application de la validation de schéma avec Pydantic
Pour éviter les sorties malformées, vous pouvez valider par rapport à un schéma Pydantic en Python.
from pydantic import BaseModel

class Person(BaseModel):
    name: str
    age: int
    city: str

# Suppose 'output' is the JSON string from Qwen3
data = Person.model_validate_json(output)
print(data.name, data.age, data.city)
Cela garantit que la sortie est conforme à la structure attendue.
Sorties structurées d’Ollama
Ollama vous permet désormais de passer un schéma dans le paramètre format. Le modèle est alors contraint de répondre uniquement en JSON conforme au schéma (documentation).
En Python, vous définissez généralement votre schéma avec Pydantic et laissez Ollama l’utiliser comme schéma JSON.
Exemple 2 : Extraction de métadonnées sur les fonctionnalités d’un LLM
Supposons que vous ayez un extrait de texte décrivant les capacités d’un LLM :
« Qwen3 a une forte prise en charge multilingue (anglais, chinois, français, espagnol, arabe). Il permet des étapes de raisonnement (chaîne de pensée). La fenêtre de contexte est de 128K jetons. »
Vous voulez des données structurées :
from pydantic import BaseModel
from typing import List
from ollama import chat

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]

prompt = """
Analyze the following description and return the model’s features in JSON only.
Model description:
'Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
It allows reasoning steps (chain-of-thought).
The context window is 128K tokens.'
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=LLMFeatures.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Sortie possible :
{
  "name": "Qwen3",
  "supports_thinking": true,
  "max_context_tokens": 128000,
  "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
}
Exemple 3 : Comparaison de plusieurs modèles
Fournissez des descriptions de plusieurs modèles et extrayez-les sous forme structurée :
from typing import List

class ModelComparison(BaseModel):
    models: List[LLMFeatures]

prompt = """
Extract features of each model into JSON.

1. Llama 3.1 supports reasoning. Context window is 128K. Languages: English only.
2. GPT-4 Turbo supports reasoning. Context window is 128K. Languages: English, Japanese.
3. Qwen3 supports reasoning. Context window is 128K. Languages: English, Chinese, French, Spanish, Arabic.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=ModelComparison.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Sortie :
{
  "models": [
    {
      "name": "Llama 3.1",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English"]
    },
    {
      "name": "GPT-4 Turbo",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Japanese"]
    },
    {
      "name": "Qwen3",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
    }
  ]
}
Cela rend trivial le benchmarking, la visualisation ou le filtrage des modèles en fonction de leurs fonctionnalités.
Exemple 4 : Détection automatique des lacunes
Vous pouvez même autoriser les valeurs null lorsqu’un champ est manquant :
from typing import Optional

class FlexibleLLMFeatures(BaseModel):
    name: str
    supports_thinking: Optional[bool]
    max_context_tokens: Optional[int]
    languages: Optional[List[str]]
Cela garantit que votre schéma reste valide même si certaines informations sont inconnues.
Avantages, avertissements et bonnes pratiques
L’utilisation de sorties structurées via Ollama (ou tout système qui le prend en charge) offre de nombreux avantages — mais comporte également quelques avertissements.
Avantages
- Garanties plus fortes : Le modèle est invité à se conformer à un schéma JSON plutôt qu’à un texte libre.
- Analyse plus facile : Vous pouvez directement
json.loadsou valider avec Pydantic / Zod, au lieu d’utiliser des expressions régulières ou des heuristiques. - Évolution basée sur le schéma : Vous pouvez versionner votre schéma, ajouter des champs (avec des valeurs par défaut) et maintenir la compatibilité ascendante.
- Interopérabilité : Les systèmes en aval s’attendent à des données structurées.
- Déterminisme (meilleur avec une basse température) : Lorsque la température est faible (par exemple, 0), le modèle a plus de chances de se conformer strictement au schéma. La documentation d’Ollama le recommande.
Avertissements et pièges
- Désaccord de schéma : Le modèle peut toujours s’en écarter — par exemple, manquer une propriété obligatoire, réordonner les clés ou inclure des champs supplémentaires. La validation est nécessaire.
- Schémas complexes : Les schémas JSON très profonds ou récursifs peuvent embrouiller le modèle ou entraîner des échecs.
- Ambiguïté dans l’invite : Si votre invite est vague, le modèle peut deviner incorrectement des champs ou des unités.
- Incohérence entre les modèles : Certains modèles peuvent être meilleurs ou moins bons dans le respect des contraintes structurées.
- Limites de jetons : Le schéma lui-même ajoute un coût en jetons à l’invite ou à l’appel API.
Bonnes pratiques et conseils (tirés du blog d’Ollama et de l’expérience)
- Utilisez Pydantic (Python) ou Zod (JavaScript) pour définir vos schémas et générer automatiquement les schémas JSON. Cela évite les erreurs manuelles.
- Incluez toujours des instructions comme « répondre uniquement en JSON » ou « ne pas inclure de commentaires ou de texte supplémentaire » dans votre invite.
- Utilisez température = 0 (ou très basse) pour minimiser le hasard et maximiser l’adhésion au schéma. Ollama recommande le déterminisme.
- Validez et prévoir un repli (par exemple, nouvelle tentative ou nettoyage) en cas d’échec de l’analyse JSON ou de la validation du schéma.
- Commencez par un schéma simple, puis étendez-le progressivement. N’essayez pas de le surcharger au départ.
- Incluez des instructions d’erreur utiles mais contraintes : par exemple, si le modèle ne peut pas remplir un champ obligatoire, qu’il réponde avec
nullplutôt que de l’omettre (si votre schéma le permet).
Exemple Go 1 : Extraction des fonctionnalités d’un LLM
Voici un simple programme en Go qui demande à Qwen3 une sortie structurée sur les fonctionnalités d’un LLM.
package main

import (
	"context"
	"encoding/json"
	"fmt"
	"log"

	"github.com/ollama/ollama/api"
)

type LLMFeatures struct {
	Name             string   `json:"name"`
	SupportsThinking bool     `json:"supports_thinking"`
	MaxContextTokens int      `json:"max_context_tokens"`
	Languages        []string `json:"languages"`
}

func main() {
	client, err := api.ClientFromEnvironment()
	if err != nil {
		log.Fatal(err)
	}

	prompt := `
  Analyze the following description and return the model’s features in JSON only.
  Description:
  "Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
  It allows reasoning steps (chain-of-thought).
  The context window is 128K tokens."
  `

	// Define the JSON schema for structured output
	formatSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"name": map[string]string{
				"type": "string",
			},
			"supports_thinking": map[string]string{
				"type": "boolean",
			},
			"max_context_tokens": map[string]string{
				"type": "integer",
			},
			"languages": map[string]any{
				"type": "array",
				"items": map[string]string{
					"type": "string",
				},
			},
		},
		"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
	}

	// Convert schema to JSON
	formatJSON, err := json.Marshal(formatSchema)
	if err != nil {
		log.Fatal("Failed to marshal format schema:", err)
	}

	req := &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  formatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var features LLMFeatures
	var rawResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		rawResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(rawResponse), &features); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	fmt.Printf("Parsed struct: %+v\n", features)
}
Pour compiler et exécuter ce programme Go d’exemple - supposons que nous ayons ce fichier main.go dans un dossier ollama-struct,
Nous devons exécuter à l’intérieur de ce dossier :
# initialise module
go mod init ollama-struct
# pull all the dependencise
go mod tidy
# build & execute
go build -o ollama-struct main.go
./ollama-struct
Exemple de sortie
Parsed struct: {Name:Qwen3 SupportsThinking:true MaxContextTokens:128000 Languages:[English Chinese French Spanish Arabic]}
Exemple Go 2 : Comparaison de plusieurs modèles
Vous pouvez étendre ceci pour extraire une liste de modèles pour comparaison.
  type ModelComparison struct {
		Models []LLMFeatures `json:"models"`
	}

	prompt = `
	Extract features from the following model descriptions and return as JSON:

	1. PaLM 2: This model has limited reasoning capabilities and focuses on basic language understanding. It supports a context window of 8,000 tokens. It primarily supports English language only.
	2. LLaMA 2: This model has moderate reasoning abilities and can handle some logical tasks. It can process up to 4,000 tokens in its context. It supports English, Spanish, and Italian languages.
	3. Codex: This model has strong reasoning capabilities specifically for programming and code analysis. It has a context window of 16,000 tokens. It supports English, Python, JavaScript, and Java languages.

	Return a JSON object with a "models" array containing all models.
	`

	// Define the JSON schema for model comparison
	comparisonSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"models": map[string]any{
				"type": "array",
				"items": map[string]any{
					"type": "object",
					"properties": map[string]any{
						"name": map[string]string{
							"type": "string",
						},
						"supports_thinking": map[string]string{
							"type": "boolean",
						},
						"max_context_tokens": map[string]string{
							"type": "integer",
						},
						"languages": map[string]any{
							"type": "array",
							"items": map[string]string{
								"type": "string",
							},
						},
					},
					"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
				},
			},
		},
		"required": []string{"models"},
	}

	// Convert schema to JSON
	comparisonFormatJSON, err := json.Marshal(comparisonSchema)
	if err != nil {
		log.Fatal("Failed to marshal comparison schema:", err)
	}

	req = &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  comparisonFormatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var comp ModelComparison
	var comparisonResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		comparisonResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(comparisonResponse), &comp); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	for _, m := range comp.Models {
		fmt.Printf("%s: Context=%d, Languages=%v\n", m.Name, m.MaxContextTokens, m.Languages)
	}
Exemple de sortie
PaLM 2: Context=8000, Languages=[English]
LLaMA 2: Context=4000, Languages=[English Spanish Italian]
Codex: Context=16000, Languages=[English Python JavaScript Java]
Au fait, qwen3:4b fonctionne bien sur ces exemples, tout comme qwen3:8b.
Bonnes pratiques pour les développeurs Go
- Définir la température à 0 pour une adhésion maximale au schéma.
- Valider avec
json.Unmarshalet prévoir un repli si l’analyse échoue. - Garder les schémas simples — les structures JSON très imbriquées ou récursives peuvent poser des problèmes.
- Autoriser les champs facultatifs (utilisez
omitemptydans les étiquettes de structure Go) si vous vous attendez à des données manquantes. - Ajouter des nouvelles tentatives si le modèle émet occasionnellement du JSON invalide.
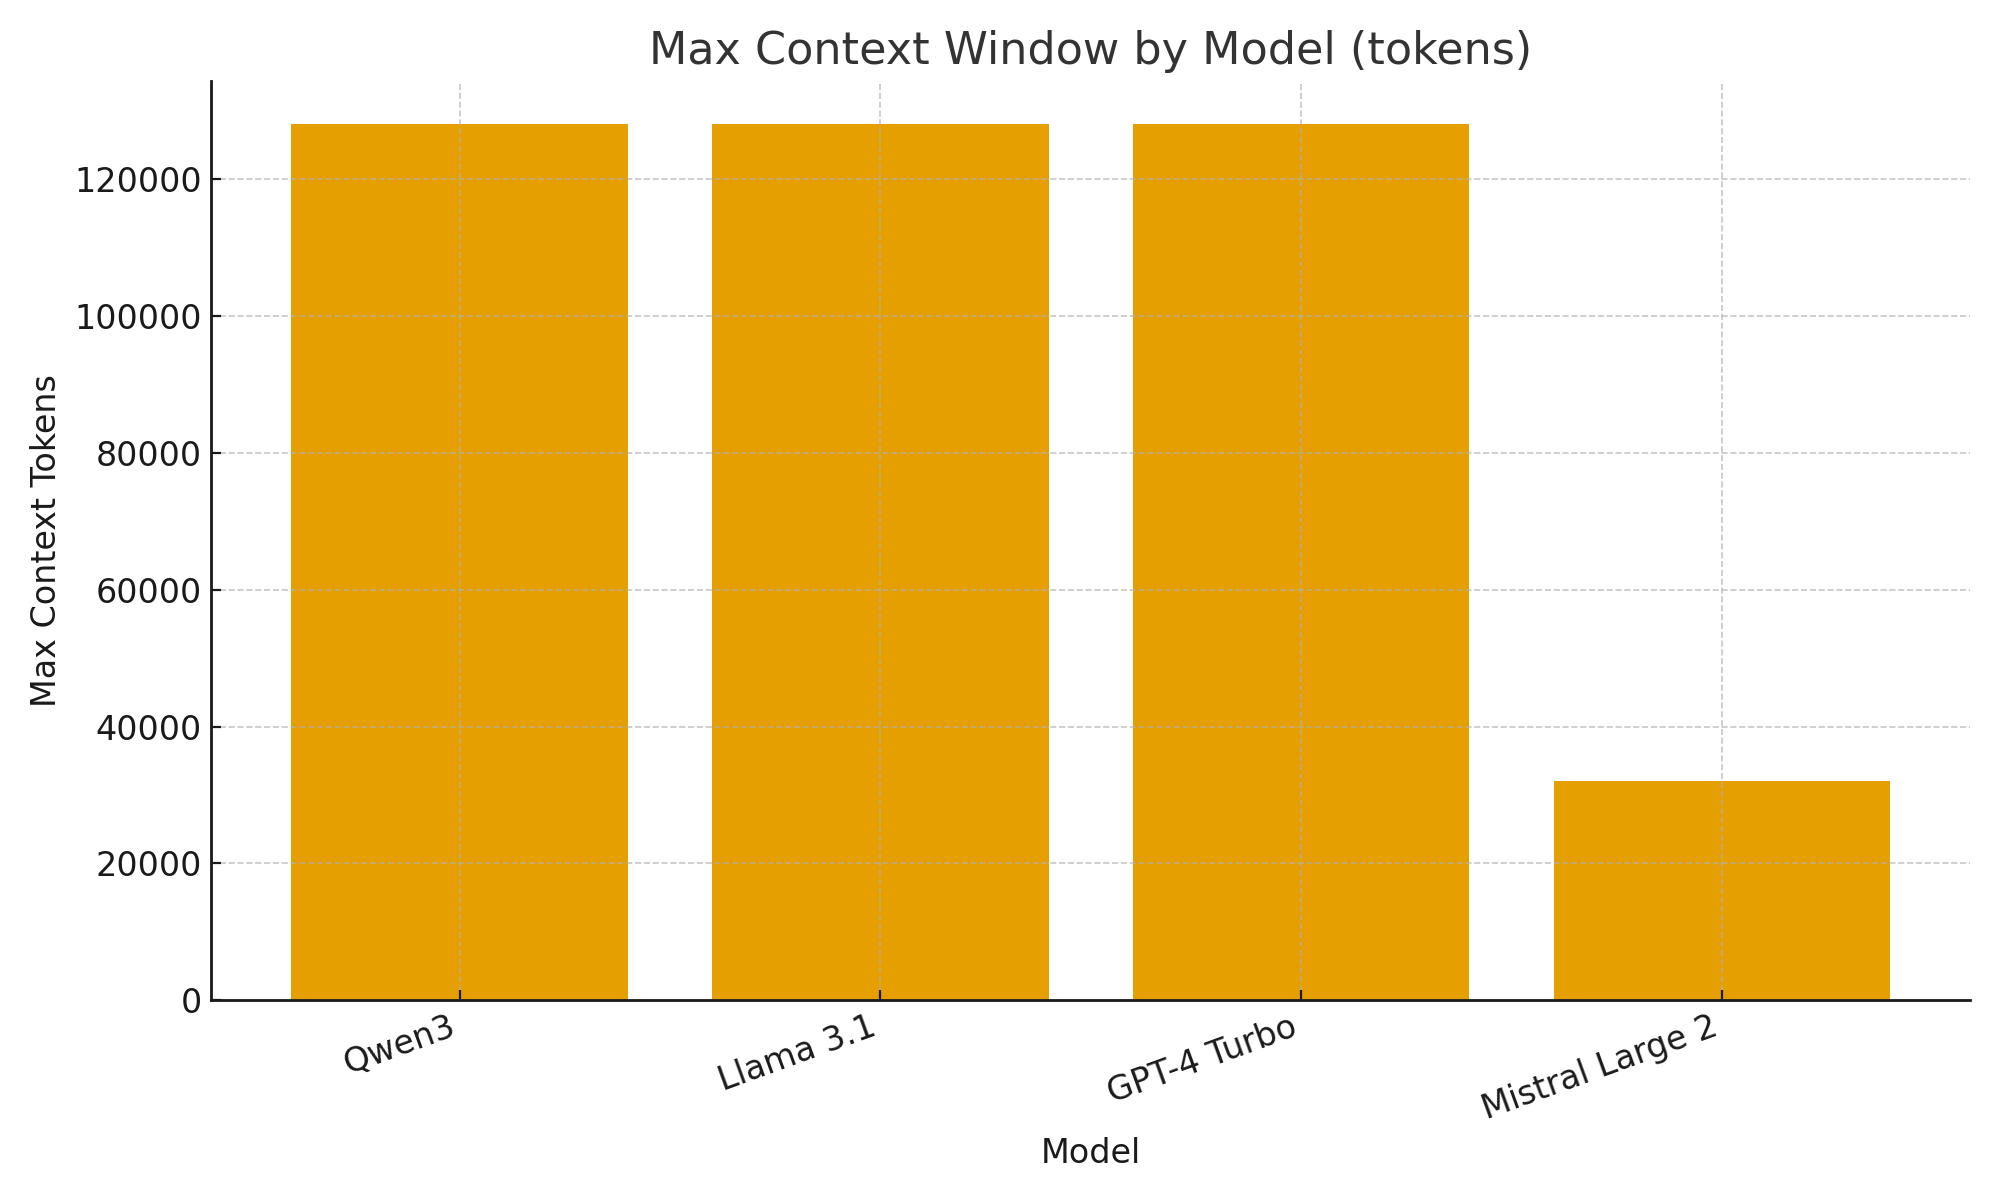
Exemple complet - Dessin d’un graphique avec les spécifications de LLM (Étape par étape : du JSON structuré aux tableaux de comparaison)
- Définir un schéma pour les données souhaitées
Utilisez Pydantic afin de pouvoir à la fois (a) générer un schéma JSON pour Ollama et (b) valider la réponse du modèle.
from pydantic import BaseModel
from typing import List, Optional

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]
- Demander à Ollama de retourner uniquement du JSON sous cette forme
Passez le schéma dans format= et baissez la température pour le déterminisme.
from ollama import chat

prompt = """
Extract features for each model. Return JSON only matching the schema.
1) Qwen3 supports chain-of-thought; 128K context; English, Chinese, French, Spanish, Arabic.
2) Llama 3.1 supports chain-of-thought; 128K context; English.
3) GPT-4 Turbo supports chain-of-thought; 128K context; English, Japanese.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format={"type": "array", "items": LLMFeatures.model_json_schema()},
    options={"temperature": 0}
)

raw_json = resp.message.content  # JSON list of LLMFeatures
- Valider et normaliser
Validez toujours avant l’utilisation en production.
from pydantic import TypeAdapter

adapter = TypeAdapter(list[LLMFeatures])
models = adapter.validate_json(raw_json)  # -> list[LLMFeatures]
- Construire un tableau de comparaison (pandas)
Transformez vos objets validés en DataFrame que vous pouvez trier/filtrer et exporter.
import pandas as pd

df = pd.DataFrame([m.model_dump() for m in models])
df["languages_count"] = df["languages"].apply(len)
df["languages"] = df["languages"].apply(lambda xs: ", ".join(xs))

# Reorder columns for readability
df = df[["name", "supports_thinking", "max_context_tokens", "languages_count", "languages"]]

# Save as CSV for further use
df.to_csv("llm_feature_comparison.csv", index=False)
- (Optionnel) Visuels rapides
De simples graphiques aident à évaluer rapidement visuellement les différences entre les modèles.
import matplotlib.pyplot as plt

plt.figure()
plt.bar(df["name"], df["max_context_tokens"])
plt.title("Max Context Window by Model (tokens)")
plt.xlabel("Model")
plt.ylabel("Max Context Tokens")
plt.xticks(rotation=20, ha="right")
plt.tight_layout()
plt.savefig("max_context_window.png")
En résumé
Avec la nouvelle prise en charge des sorties structurées d’Ollama, vous pouvez considérer les LLM non seulement comme des chatbots, mais comme des moteurs d’extraction de données.
Les exemples ci-dessus ont montré comment extraire automatiquement des métadonnées structurées sur les fonctionnalités des LLM comme la prise en charge du raisonnement, la taille de la fenêtre de contexte et les langues prises en charge — des tâches qui exigeraient autrement une analyse fragile.
Que vous créiez un catalogue de modèles LLM, un tableau de bord d’évaluation ou un assistant de recherche alimenté par l’IA, les sorties structurées rendent l’intégration fluide, fiable et prête pour la production.
