
Architektura asystenta AI: LLM, pamięć, narzędzia, routing, obserwowalność
Jak w rzeczywistości tworzony jest poważny asystent.
Produkcjonalny asystent AI to nie „LLM z promptem”. To system, który przyjmuje intencję, zachowuje stan, decyduje, kiedy odpytać źródła lub podjąć działanie, i ujawnia wystarczające detale runtime’u, aby debugować błędy.
To podejście systemowe to to, co badają systemy AI, gdy asystenci wykraczają poza pojedyncze wywołanie modelu.
OpenAI opisuje agenty jako aplikacje, które planują, wywołują narzędzia, współpracują i zachowują wystarczający stan do pracy wieloetapowej, podczas gdy Anthropic ujęcie tego samego problemu jako zarządzany szkielet (harness), który może bezpiecznie uruchamiać pliki, komendy, dostęp do sieci i kod.
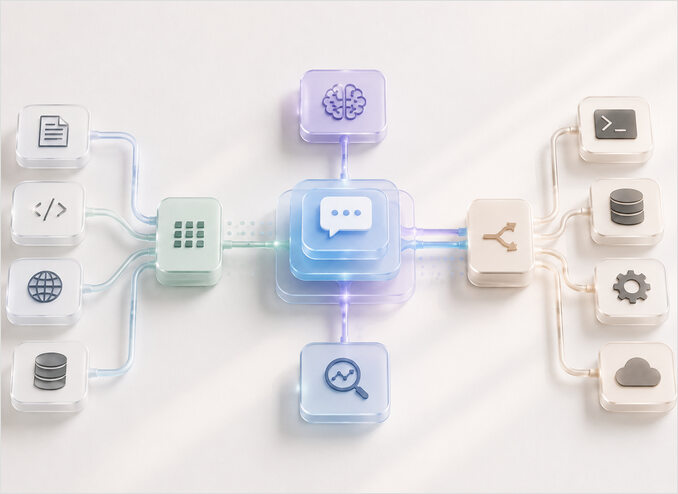
Najczytelniejsza architektura dzieli odpowiedzialności na pięć warstw: LLM, Pamięć, Narzędzia, Routowanie i Obserwowalność. Ten podział odpowiada możliwościom udostępnianym przez API dużych dostawców, przez MCP, przez własnoręczne runtime’y takie jak vLLM i llama.cpp oraz przez rzeczywiste systemy asystentów takie jak OpenClaw i Hermes.
Pamięć należy traktować jako coś więcej niż „dłuższy kontekst”. Systemy odpytywania przekształcają zewnętrzną wiedzę w jawną pamięć nieparametryczną — ten sam obszar projektowy omówiony szczegółowo w artykule Generowanie rozszerzone odpytywaniem (RAG) — a zarówno wytyczne Anthropic dotyczące kontekstu, jak i artykuł „Lost in the Middle” ostrzegają, że samo wciskanie większej liczby tokenów do kontekstu nie gwarantuje niezawodnego wywoływania.
Użycie narzędzi to granica kontraktu, a nie magia. Wywoływanie funkcji OpenAI, użycie narzędzi Anthropic i MCP opierają się na tym samym wzorcu: model emituje zapytanie strukturalne, jakiś runtime go wykonuje, a wynik płynie z powrotem do rozmowy. Jeśli ta granica jest nieostrożna, asystent staje się nieostrożny.
Mój uprzedzenie jest proste: zacznij nudno. Jeden orkiestrator, jedna trwała ścieżka pamięci, jeden ślad (trace) na żądanie i jedna jawna polityka dla wykonywania narzędzi. Wykresy multi-agentowe są użyteczne, ale dopiero po tym, gdy potrafisz wyjaśnić przypadki awarii pojedynczego agenta bez zgadywania.
Czym jest system asystenta AI
Praktyczna definicja jest następująca: system asystenta AI to runtime, który przekształca intencję użytkownika w odpowiedź lub działanie, łącząc interfejs modelu, składanie kontekstu, wykonywanie narzędzi, zarządzanie stanem i telemetrię. Dlatego użyteczna dokumentacja to nie tylko karty modeli. Użyteczna dokumentacja to referencje API, kontrakty narzędzi, przewodniki po odpytywaniu, dokumentacja routowania i dokumentacja śledzenia (tracing). API Responses OpenAI ujawnia interakcje stanowe, wbudowane narzędzia i wywoływanie funkcji. API Claude Anthropic ujawnia bezpośredni dostęp do komunikatów (Messages) oraz Zarządzane Agenty (Managed Agents). OpenClaw i Hermes idą krok dalej i pokazują, co się dzieje, gdy umieścisz te możliwości za trwałymi bramami (gatewayami), kanałami, sesjami i pamięcią.
Innymi słowy, system asystenta ma szerszy kontrakt niż ukończenie czatu (chat completion). Dobre wewnętrzne zobowiązanie wygląda mniej więcej tak:
AssistantRequest  = intencja użytkownika + tożsamość + sesja + załączniki + polityka
AssistantResponse = odpowiedź + akcje + cytaty + zmiany stanu + ID śladu
Ten kontrakt jest ważny, ponieważ każda produkcjonalna niezgoda w końcu sprowadza się do jednego z tych pytań: jaki kontekst był widoczny, które narzędzie się wykonało, który model odpowiedział, która pamięć została odczytana lub zapisana i gdzie ślad wskazuje, że system spędził czas. OpenTelemetry definiuje ślady (traces) jako ścieżkę żądania przez aplikację, co jest dokładnie abstrakcją potrzebną poważnym asystentom. LangSmith i OpenLIT specjalizują następnie ten pomysł dla LLM-ów, narzędzi, magazynów wektorowych i przepływów pracy agentów.
Główne komponenty i interfejsy
Podział komponentów poniżej to ten, który uważam za najtrwalszy. Jest to również podział, który najlepiej zgadza się z oficjalnymi API i otwartoźródłowymi runtime’ami, którymi ludzie faktycznie operują.
| Warstwa | Główna odpowiedzialność | Typowy interfejs | Przykładowe technologie |
|---|---|---|---|
| Warstwa LLM | Rozumowanie, generowanie, decydowanie, emisja wywołań strukturalnych | API Responses, API Messages, końcówki zgodne z OpenAI lub Anthropic | OpenAI, Anthropic, vLLM, llama.cpp, Ollama |
| Warstwa Pamięci | Zachowywanie stanu sesji, trwałych notatek i przeszukiwanej wiedzy | wektory (embeddings), wyszukiwanie wektorowe, narzędzia odczytu/zapisu pamięci, API odpytywania | Wektory i magazyny wektorowe OpenAI, Pinecone, Weaviate, pgvector, Milvus, pamięć Hermes, pamięć OpenClaw |
| Warstwa Narzędzi | Odczyt danych i wykonywanie działań poza modelem | narzędzia w schemacie JSON, narzędzia MCP, wyszukiwanie plików i sieci, natywne narzędzia runtime’u | Wywoływanie funkcji OpenAI, użycie narzędzi Anthropic, MCP, narzędzia LangChain, narzędzia zapytań LlamaIndex |
| Warstwa Routowania | Wybór modelu, backendu, polityki i ścieżki najemcy (tenant) | aliasy modeli, grupy awaryjne (failover), sprawdzanie zdrowia, budżety, powiązania kanałów | LiteLLM, multi-agentowe routowanie OpenClaw, rozwiązywanie runtime’u dostawcy w Hermes |
| Obserwacja | Wyjaśnienie, co się stało i dlaczego | ślady, rozpiętości (spans), logi, metryki, przebiegi oceny (evals) | OpenTelemetry, LangSmith, OpenLIT |
Powyższa tabela jest wyprowadzona z oficjalnych interfejsów dostawców, MCP, dokumentacji baz wektorowych oraz dokumentacji runtime’ów dla vLLM, llama.cpp, OpenClaw i Hermes.
Warstwa LLM powinna dobrze robić trzy rzeczy: konsumować bieżący kontekst roboczy, emitować albo finalną odpowiedź, albo zapytanie o działanie strukturalne i zwracać wystarczające metadane, aby wspierać ponowne próby i śledzenie. API Responses OpenAI jest wyraźnie zaprojektowane do interakcji stanowych oraz wbudowanych narzędzi i wywoływania funkcji. API Messages Anthropic ujawnia ten sam podstawowy cykl przez bloki tool_use i zwroty tool_result, podczas gdy Zarządzane Agenty dają Ci hostowany szkielet, jeśli nie chcesz budować cyklu samodzielnie. Własnoręczne runtime’y takie jak vLLM i llama.cpp są ważne, ponieważ zachowują znajome interfejsy w stylu dostawcy, pozwalając Ci umieścić wnioskowanie w swoim własnym środowisku.
Warstwa Pamięci powinna mentalnie podzielić się na trzy kategorie: pamięć robocza, trwała pamięć symboliczna i przeszukiwana pamięć semantyczna. Wektory OpenAI zwracają wektory, które można indeksować i przeszukiwać; Odpytywanie i Wyszukiwanie Plików OpenAI nakładają następnie wyszukiwanie semantyczne i słów kluczowych na magazyny wektorowe. Pinecone, Weaviate, pgvector i Milvus reprezentują cztery powszechne kształty magazynu: w pełni zarządzany, otwartoźródłowy wektorowo-natywny, natywny dla Postgresa i rozproszona baza wektorowa. Hermes i OpenClaw dodają użyteczne przypomnienie, że nie cała pamięć należy do magazynu wektorowego: notatki oparte na plikach, zweryfikowane awanse (promocje) i migawki (snapshoty) zakresu sesji to często uczciwszy projekt. Systemy Pamięci w Asystentach AI mapuje model międzyframeworkowy; System Pamięci Agenta Hermes rozpracowuje ograniczoną pamięć rdzeniową i zamrożone migawki sesji w jednym produkcie.
Warstwa Narzędzi to miejsce, w którym asystent przestaje być streszczeniowcem i zaczyna być oprogramowaniem. Wywoływanie funkcji OpenAI traktuje narzędzia jako funkcjonalność zdefiniowaną schematem, którą model może zdecydować wywołać. Anthropic mówi to samo bardziej wprost: użycie narzędzi to kontrakt między Twoją aplikacją a modelem, a model nigdy niczego nie wykonuje samodzielnie. MCP uogólnia ten kontrakt w protokół klient-serwer, w którym hosty łączą się z jednym lub więcej serwerów ujawniających narzędzia, prompty i zasoby — ta sama granica opisana krok po kroku w artykule Serwer MCP w Go. LangChain i LlamaIndex mieszczą się tu komfortowo jako biblioteki orkiestracji: LangChain skupia się na prefabrykowanej architekturze agentów i integracjach, podczas gdy LlamaIndex skupia się na dostępie do danych rozszerzonym o kontekst, silnikach zapytań i przepływach pracy.
Warstwa Routowania istnieje, ponieważ „który model?” to nigdy jedyne pytanie. Potrzebujesz też „która ścieżka dostawcy, który najemca, który budżet, która klasa opóźnień i które odwrócenie awaryjne?”. LiteLLM jest użyteczne, ponieważ jego oficjalna dokumentacja jest odświeżająco konkretna: ważony wybór, najmniej obciążony, oparty na opóźnieniach, oparty na kosztach routowanie i ograniczone odwrócenia awaryjne to wszystko wzorce pierwszorzędowe. OpenClaw rozszerza routowanie w górę do izolacji kanałów i agentów, podczas gdy Hermes rozszerza je w dół do slotów modeli dla pracy głównej i pomocniczej, takiej jak streszczanie, kompresja kontekstu i routowanie narzędzi MCP. To właściwy model mentalny: ruter wybiera więcej niż model, wybiera tor wykonania.
Warstwa Obserwacji to to, co zapobiega przekształcaniu się architektury w folklor. OpenTelemetry daje Ci abstrakcję śladu. LangSmith daje Ci widoczność end-to-end nad krokami aplikacji LLM i wspiera kształty wdrożenia chmurowego, hybrydowego i własnoręcznego. OpenLIT daje Ci obserwowalność AI natywną dla OpenTelemetry z opcjami instrumentacji bez kodu i ręcznej, w tym obsługą LLM-ów, frameworków agentów, baz wektorowych i GPU. Dla metryk produkcyjnych, śladów i wzorców SLO przez przepływy wnioskowania i agentów, zobacz Obserwowalność dla Systemów LLM. Jeśli Twój asystent nie ma śladu na żądanie, rozpiętości na wywołanie modelu i historii zdarzeń dla wykonania narzędzi, to nie masz jeszcze prawdziwej architektury. Masz wibracje (vibes).
Zbieranie, wzbogacanie, odpowiadanie
Sekwencja, która wciąż pojawia się w rzeczywistych systemach, to zbieranie -> wzbogacanie -> odpowiadanie -> rejestrowanie. Różne frameworki owijają ją w różny sposób, ale przepływ jest na tyle stabilny, aby traktować go jako kręgosłup.
Krok zbierania jest zwykle ważniejszy niż wygląda. OpenClaw i Hermes obaj umieszczają trwałą bramę (gateway) przed asystentem, ponieważ wejście (ingress) to nie tylko wprowadzanie tekstu. Obejmuje ono metadane kanału, tożsamości, autoryzację, granice sesji, wiadomości bezpośrednie, grupy, ticki cron i semantykę dostarczania. Jeśli pominiesz tę warstwę i będziesz polegał na surowej abstrakcie widżetu czatu, ostatecznie i tak dołęczysz go z powrotem jako ad hoc middleware.
Krok wzbogacania to miejsce, w którym dojrzałe systemy rozchodzą się z zabawkami demo. Odpytywanie i Wyszukiwanie Plików OpenAI czynią odpytywanie jawnym przez magazyny wektorowe i wywołania wyszukiwania. LlamaIndex formalizuje ten sam wzorzec przez konektory danych, indeksy, silniki zapytań i przepływy pracy. Hermes idzie dalej, dzieląc majątek modeli na sloty główne i pomocnicze, rozładowując pracę taką jak kompresja, streszczanie i routowanie na mniejsze lub bardziej specjalistyczne modele. To wzorzec projektowy, który warto ukraść: nie wydawaj swoich najdroższych tokenów modelu na brudną robotę.
Krok odpowiadania to nie „generowanie tekstu”. To „zamykanie bieżącego cyklu”. Jeśli model może odpowiedzieć bezpośrednio, robi to. Jeśli potrzebuje narzędzia, emituje zapytanie strukturalne. Kontrakt użycia narzędzi Anthropic i przewodnik wywoływania funkcji OpenAI czynią to jawnym. Powodem, dla którego to jest ważne architektonicznie, jest to, że wyjścia teraz obejmują zarówno język, jak i przepływ sterowania. Twój obiekt odpowiedzi jest w części prozą, a w części planem runtime’u.
Krok rejestrowania to miejsce, gdzie pojawia się semantyka spójności. Pinecone oddziela ścieżki zapisu i odczytu i przetwarza zapisy po trwałym potwierdzeniu. Pamięć Hermes jest wstrzykiwana jako zamrożona migawka na sesję, aby mogła zachować wydajność cache prefiksu, co oznacza, że nowe zapisy nie pojawiają się automatycznie w bieżącym prompcie sesji. System Dreaming w OpenClaw awansuje tylko zweryfikowane, uzasadnione kandydatury do MEMORY.md, i jest to opcjonalne (opt-in), a nie zawsze włączone. Praktyczna lekcja polega na tym, że pamięć rzadko jest naprawdę „read-after-write” (odczyt po zapisie) przez każdą warstwę. Musisz projektować z myślą o stopniowej widoczności.
OpenClaw i Hermes jako systemy referencyjne
OpenClaw i Hermes są użytecznymi przypadkami referencyjnymi, ponieważ nie są tylko opakowaniami jednego API dostawcy. Obaj prezentują asystenta jako długoterminowy system z bramami, sesjami, narzędziami, pamięcią i wieloma backendami modeli.
| Zagadnienie architektoniczne | Mapowanie OpenClaw | Mapowanie Hermes |
|---|---|---|
| Wejście i powierzchnie | Własna brama łącząca aplikacje czatu i powierzchnie kanałów | Pojedyncza tła brama wiadomości łącząca wiele zewnętrznych platform |
| Orkiestracja | Płaszczyzna sterowania centryczna na bramie dla kanałów i interakcji AI | Pętla AIAgent obsługująca składanie promptu, wybór dostawcy, dystrybucję narzędzi, ponowne próby i odwrócenie awaryjne |
| Routowanie | Multi-agentowe routowanie wiąże przychodzący ruch z izolowanymi agentami z oddzielnymi przestrzeniami roboczymi i sesjami | Sloty modeli główne i pomocnicze dzielą rdzenne wnioskowanie od kompresji, streszczania, zatwierdzeń i routowania MCP |
| Pamięć | Pamięć oparta na plikach plus opcjonalna aktywna pamięć i tła promocja Dreaming | MEMORY.md i USER.md wstrzyknięte jako zamrożona migawka sesji, plus zewnętrzni dostawcy pamięci |
| Narzędzia i rozszerzenie | Wbudowane narzędzia, narzędzia sesji, wtyczki dostawców, własne i własnoręczne końcówki | 40+ narzędzi, wbudowany klient MCP, zestawy narzędzi, umiejętności i wtyczki dostawców pamięci |
To mapowanie jest ugruntowane w oficjalnych dokumentach i repozytoriach OpenClaw i Hermes. OpenClaw dokumentuje architekturę bram, multi-agentowe routowanie, obsługę własnych i własnoręcznych dostawców, w tym vLLM i Ollama, opcjonalną aktywną pamięć i promocję opartą na Dreaming. Hermes dokumentuje bramę wiadomości, centralną pętlę AIAgent, sloty modeli główne i pomocnicze, wbudowaną pamięć i natywną integrację MCP.
Moje nieco opiniowane odczytanie jest takie, że oba systemy formułują ten sam argument architektoniczny w różnych akcentach. OpenClaw jest silnie centryczny na bramie. Hermes jest silnie centryczny na pętli agenta. Ale oba odrzucają płytkie idea, że asystent to tylko „prompt plus model”. Modelują kanały, tożsamości, semantykę pamięci, powierzchnie narzędzi i heterogeniczność backendów jako zagadnienia pierwszorzędowe. To dokładnie to, co powinna robić produkcjonalna architektura.
Praktyczny stos hybrydowy inspirowany oboma systemami wygląda tak:
edge:
  gateway: hermes or openclaw

routing:
  proxy: litellm
  policy: latency and budget aware
  tenancy: session and channel scoped

llm:
  primary: openai responses or anthropic messages
  local_fallback: vllm
  local_dev: ollama or llama.cpp

memory:
  session: sqlite or postgres
  semantic: pgvector or weaviate
  embeddings: openai embeddings or ollama embeddings

tools:
  contract: json schema tools plus mcp
  examples: filesystem, browser, web search, internal APIs

observability:
  traces: opentelemetry
  ai_dashboards: openlit or langsmith
  evals: openai evals plus app-specific regression sets
Ten stos to rozważany wzorzec wdrożenia, a nie narzucony przez dostawcę projekt. Działa, ponieważ oficjalne interfejsy się zgadzają: OpenAI i Anthropic ujawniają API nastawione na narzędzia, vLLM i llama.cpp emulują końcówki w stylu dostawcy, Ollama obsługuje lokalne modele i wektory, MCP standaryzuje zewnętrzne narzędzia, LiteLLM obsługuje routowanie i odwrócenie awaryjne, a platformy zgodne z OpenTelemetry mogą śledzić całą ścieżkę.
Wzorce, tabele i kompromisy
Istnieje kilka powtarzalnych wzorców asystentów wartych nazwania. Zarządzany asystent trzyma większość runtime’u wewnątrz API dostawcy. Asystent priorytetowo traktujący odpytywanie traktuje pamięć i wyszukiwanie jako główny wyróżnik. Asystent priorytetowo traktujący narzędzia zachowuje się bardziej jak operator niż chatbot. Asystent bramowy priorytyzuje zawsze dostępny dostęp przez powierzchnie wiadomości. Siatka specjalistów dekomponuje pracę na wiele agentów lub tras. Oficjalne dokumenty z OpenAI, Anthropic, LlamaIndex, LiteLLM, OpenClaw i Hermes wszystkie wspierają wersje tych wzorców, nawet jeśli nazywają je inaczej.
| Wzorzec | Dla czego optymalizuje | Najlepszy przypadek użycia | Ukryty koszt |
|---|---|---|---|
| Zarządzany asystent | Szybkość dostawy | Wewnętrzne kopiloty i bota wsparcia | Blokada dostawcy i mniej kontroli nad szczegółami runtime’u |
| Asystent priorytetowo traktujący odpytywanie | Uzmysłowione odpowiedzi na podstawie własnych danych | Dokumentacja, wsparcie, praca wiedzy | Jakość odpytywania staje się rzeczywistym produktem |
| Asystent priorytetowo traktujący narzędzia | Działanie ponad konwersację | Przepływy operacyjne, pobieranie danych, automatyzacje | Efekt uboczne, ponowne próby i zatwierdzenia stają się zagadnieniami rdzeniowymi |
| Asystent bramowy | Uniwersalny dostęp | Osobiste i zespołowe asystentów przez powierzchnie czatu | Złożoność tożsamości, sesji i bezpieczeństwa |
| Siatka specjalistów | Podział pracy | Złożone przepływy z rzeczywistymi granicami odpowiedzialności | Trudniejsze debugowanie, orkiestracja i projektowanie oceny |
Wzorzec siatki specjalistów rozwija się w odrębną dyscyplinę inżynieryjną, gdy liczba agentów rośnie. Dla sześciu kanonicznych wzorców koordynacji — orkiestrator-pracownik, sekwencyjny przepływ, wachlarz (fan-out), hierarchiczny, rój (swarm) i siatka — z konkretnymi trybami awarii i ramą decyzyjną produkcyjną, zobacz Wzorce Orkiestracji Multi-Agent.
Ta tabela wzorców jest syntezą z dokumentacji dostawców, dokumentacji frameworków i systemów referencyjnych, a nie twierdzeniem żadnego pojedynczego dostawcy.
| Kształt opcji | Typowe komponenty | Mocna strona | Słaba strona |
|---|---|---|---|
| Zarządzany | OpenAI Responses lub Anthropic Managed Agents, hostowane wyszukiwanie plików lub magazyny wektorowe | Najszybsza ścieżka, mniej części ruchomych, hostowane narzędzia | Najniższa kontrola nad ścieżką danych i semantyką runtime’u |
| Hybrydowy | API dostawcy plus własnoręczny ruter i magazyn wektorowy | Dobry balans prędkości i kontroli | Więcej kontraktów do utrzymania |
| Własnoręczny | vLLM lub llama.cpp lub Ollama, MCP, własnoręczna baza wektorowa, OTel | Silna prywatność i kontrola wdrożenia | Najwyższy ciężar operacyjny, nadmiar sprzętu i strojenia |
Notatki do tabeli: Hostowane Wyszukiwanie Plików OpenAI to narzędzie zarządzane, Anthropic oferuje zarządzany szkielet, Pinecone to zarządzana usługa wektorowa, podczas gdy vLLM, llama.cpp, Ollama, pgvector, Weaviate, Milvus, LangSmith self-hosted i OpenLIT wszystkie wspierają w różnym stopniu samodzielne zarządzanie lub operację hybrydową.
| Magazyn wektorowy | Kształt | Dlaczego zespoły go wybierają | Na co uważać |
|---|---|---|---|
| Pinecone | Zarządzana usługa wektorowa | Silna prostota operacyjna i skalowalna zarządzana architektura | Zewnętrzna zależność i ekonomika usługi zarządzanej |
| Weaviate | Otwartoźródłowa baza wektorowa | Wektory plus odwrócone indeksy i elastyczne wybory indeksów | Więcej strojenia klastra niż ścieżka tylko hostowana |
| pgvector | Rozszerzenie Postgresa | Zachowywanie wektorów z danymi relacyjnymi i istniejącym stosem SQL | Nie najlepsza dopasowanie dla każdego wysokiej skali zadania ANN |
| Milvus | Rozproszona baza wektorowa | Skala zaprojektowana pod konkretny cel i ekosystem wokół zarządzanego Zilliz Cloud | Kolejna specjalistyczna baza danych do operacji |
Notatki do tabeli: Pinecone dokumentuje zarządzaną płaszczyznę sterowania i regionalne płaszczyzny danych. Weaviate dokumentuje indeksy wektorowe i odwrócone z wieloma typami indeksów wektorowych. pgvector dodaje dokładne i przybliżone wyszukiwanie najbliższych sąsiadów do Postgresa. Milvus pozycjonuje się jako otwartoźródłowa, wysokiej wydajności, skalowalna baza wektorowa, z Zilliz Cloud jako opcją zarządzaną.
| Opcja LLM | Styl interfejsu | Najlepsze do | Na co uważać |
|---|---|---|---|
| OpenAI Responses | Stanowe odpowiedzi plus wbudowane narzędzia | Szybki start, hostowane narzędzia, strukturalne pętle | Dziedziczysz abstrakcje specyficzne dla platformy |
| Anthropic Messages | Bezpośredni dostęp do modelu z jawnym kontraktem użycia narzędzi | Jasne granice narzędzi i dobra kontrola w własnych pętlach | Więcej runtime’u jest Twoją odpowiedzialnością, chyba że używasz Managed Agents |
| vLLM | Własnoręczne serwowanie zgodne z OpenAI i zgodne z Anthropic | Wysłużone własnoręczne wnioskowanie | Prawdziwa infrastruktura i praca serwowania modeli |
| Ollama | Prosty lokalny runtime modeli i wektorów | Lokalny rozwój i małe własnoręczne stosy | Nie ta sama klasa systemu serwowania jak dostrojony rozproszony runtime |
| llama.cpp | Lekki lokalny serwer z trasami zgodnymi z dostawcą | Krawędź (edge), CPU-first, ograniczone środowiska | Robisz więcej ręcznego strojenia i dopasowania możliwości |
Notatki do tabeli: OpenAI dokumentuje Responses jako zaawansowany interfejs do stanowych odpowiedzi i wbudowanych narzędzi. Anthropic dokumentuje API Messages i kontrakt użycia narzędzi odrębnie od Managed Agents. vLLM ujawnia serwer zgodny z OpenAI plus wsparcie API Messages Anthropic. Ollama dokumentuje lokalne przepływy pracy wektorów i modeli. llama.cpp dokumentuje trasy czatu, odpowiedzi i wektorów zgodne z OpenAI, plus ukończenia czatu zgodne z Anthropic.
| Ograniczenie lub kompromis | Upodobienie do zarządzanego | Upodobienie do własnoręcznego | Praktyczne złagodzenie |
|---|---|---|---|
| Opóźnienie | Często lepsza pierwsza iteracja i mniej lokalnych zadań strojenia | Może wygrać, gdy model i dane są lokalizowane i utrzymane w ciepłej temperaturze | Używaj warstw routowania, gorących cache’y i mniejszych modeli pomocniczych |
| Koszt | Łatwy start, zmienny w skali tokenów | Lepsza amortyzacja przy stabilnym wykorzystaniu | Mierz rzeczywisty ruch przed optymalizowaniem na instynkt |
| Prywatność i rezydencja | Prostsze dla niewrażliwych danych | Silniejsza kontrola dla wrażliwych i regulowanych przepływów | Używaj granic hybrydowych i zatrzymuj tylko to, co musi się przenieść |
| Spójność | Hostowane narzędzia wciąż mają semantykę stopniowej widoczności | Własnoręczne rury pamięci również etapują i awansują dane | Definiuj zasady read-after-write jawno na warstwę |
| Skalowanie | Mniej bólu płaszczyzny sterowania | Lepsze dopasowanie do stabilnych, specjalistycznych obciążeń | Używaj partii (batching), kolejkowania i izolowanych najemców |
| Debugowalność | Łatwo przeoczyć nieprzejrzyste wnętrza dostawcy | Łatwo utonąć w samodzielnym skomplikowaniu | Śledź każde żądanie i oceniaj każdą trasę |
Ta macierz kompromisów to wniosek architektoniczny z oficjalnych dokumentów, a nie benchmark dostawcy. Wiersz spójności jest ważniejszy niż wiele wpisów blogowych przyznaje: Pinecone oddziela ścieżki zapisu i odczytu, Hermes zamraża pamięć w promptach początku sesji, a OpenClaw awansuje trwałą pamięć przez stopniowy przegląd. To oznacza, że „pamięć zaktualizowana” i „pamięć widoczna dla bieżącej odpowiedzi” to często różne prawdy.
Tryby awarii i złagodzenia
Większość asystentów nie zawodzi, ponieważ model bazowy jest „zły”. Zawodzą, ponieważ otaczający system kłamie modelowi, głodzi go właściwego kontekstu, pozwala narzędziom dryfować lub czyni debugowanie niemożliwym.
| Gdzie pęka | Typowy objaw | Zwyczajna przyczyna | Złagodzenie |
|---|---|---|---|
| Składanie promptu | Pewna, ale nietrafiona odpowiedź | Za dużo nieistotnego kontekstu, zły porządek | Budżetuj kontekst, przebudowuj wyniki, trzymaj kluczowe fakty na górze |
| Odpytywanie | Prawidłowy ton, błędne fakty | Złe kawałkowanie (chunking), przestarzały indeks, słabe filtry | Oceniaj odpytywanie osobno, dodawaj filtry metadanych i wyszukiwanie hybrydowe |
| Granica narzędzi | Błędne działanie lub zduplikowane działanie | Luźne schematy, ponowne próby bez idempotencji | Ciasne schematy, klucze idempotencji, bramy zatwierdzania |
| Routowanie | Dziko niespójne zachowanie na żądanie | Routowanie kosztów lub opóźnień bez kontroli jakości | Dodawaj przyklejone sesje i oceny na trasę |
| Pamięć | Przestarzałe lub zatrute wywoływanie | Nadgorliwe zapisy, słaby przegląd, wyciek między sesjami | Oddziel pamięć roboczą i trwałą, przeglądaj awanse |
| Obserwacja | Brak pomysłu, co się stało | Brakujące ślady lub brak granularności rozpiętości | Emituj korzenie i podrozpiętości dla odpytywania, modelu i wywołań narzędzi |
| Kontrola halucynacji | Prawdopodobne, ale nieuzasadnione twierdzenia | Słabe uzasadnienie lub brak przejścia walidacji | Walidacja dokumentów referencyjnych, kontrole spójności własnej, bramy oceny |
Baza dowodów dla tej tabeli jest szeroka, ale spójna. Dokumenty narzędzi Anthropic czynią jasnym, że użycie narzędzi to granica kontraktu. OpenAI Guardrails obejmuje wykrywanie halucynacji względem bazy wiedzy referencyjnej przez Wyszukiwanie Plików. SelfCheckGPT pokazuje, że spójność własna między próbkami może pomóc wykryć nieuzasadnione twierdzenia. Wyniki „Lost in the Middle” i wytyczne Anthropic dotyczące kontekstu obie wzmacniają tę samą lekcję operacyjną: więcej tokenów nie usuwa potrzeby kurotacji kontekstu.
Preferowany stos złagodzeń może być nudny i powtarzalny: śledź każde żądanie, wersjonuj prompty, oceniaj odpytywanie niezależnie, trzymaj narzędzia idempotentne i uruchamiaj oceny regresyjne przed zmianą tras lub polityki pamięci. Dokumenty i repo Evals OpenAI są wprost o tym dlaczego: bez ocen jest trudno i czasochłonnie zrozumieć, jak zmiany modelu lub promptu wpływają na Twój przypadek użycia. Dotyczy to tak samo ruterów i odpytywania, jak i promptów.
Więcej czytania
Jeśli chcesz zagłębić się głębiej, oto najużyteczniejsze źródła pierwotne, które warto mieć otwarte podczas projektowania lub przeglądania architektury asystenta.
-
OpenAI: Przegląd Responses, Wywoływanie Funkcji, Używanie Narzędzi, Odpytywanie, Wyszukiwanie Plików, Evals i MCP dla zdalnych serwerów narzędzi.
-
Anthropic: Przegląd API, Użycie Narzędzi, kontrakt użycia narzędzi, Zarządzane Agenty, Okna Kontekstu i konektor MCP.
-
Sam MCP: Przegląd Architektury i Specyfikacja są warte bezpośredniego przeczytania, ponieważ wyjaśniają hosty, klientów, serwery, narzędzia, prompty, zasoby, transporty i negocjację możliwości czysto. Dla praktycznego porównania MCP z protokołem Agent2Agent i kiedy system multi-agentowy potrzebuje obu warstw, zobacz A2A vs MCP: Czy agenci AI naprawdę potrzebują obu protokołów? a dla samych koncepcji A2A — Karty Agentów (Agent Cards), cykl życia zadań, wiadomości, części (parts) i artefaktów — zobacz Czym jest protokół A2A? Wyjaśniono Karty Agentów i Zadania.
-
Tła i proaktywni asystenci: warstwa narzędzi to tylko jedna część tego, jak asystenci działają. Dla tego, jak sprawić, aby asystent obserwował, decydował i działał samodzielnie — planistki (schedulers), pracownicy oparte na kolejkach, protokoły roszczeń, trwałe przepływy pracy i semantyczne pytanii (polling) — zobacz Agenci Pytający w Asystentach AI: 11 Wzorców Implementacji.
-
Autorytet decyzyjny: dla których decyzji model powinien decydować, rekomendować lub tylko informować — pięć ról decyzyjnych, routowanie oparte na pewnością do najmniejszego kompetentnego poziomu i bramy zatwierdzania rozmiaru do promienia rażenia (blast radius) — zobacz Decyzyjne LLM: Kiedy model powinien decydować — a kiedy nie powinien.
-
Protokół A2A i adopcja: gdy agenci są niezależnie wdrożeni i potrzebują współpracować przez granice własności, A2A staje się istotne. Dla praktycznego widoku na 2026, gdzie A2A faktycznie ma trakcję, pytań bezpieczeństwa, które podnosi, i ramy decyzyjnej dla tego, kiedy go adoptować, zobacz Protokół A2A Google w 2026: Adopcja, Hype i Rzeczywistość. Gdy ci agenci wymieniają długoterminowe zadania, a nie pojedyncze tury czatu, Strumieniowanie A2A i Asynchroniczne Zadania dla Długoterminowych Przepływów Agenta pokrywa projektowanie SSE, push i input_required na granicy protokołu.
-
Frameworki i routowanie: Przegląd LangChain, dokumenty rozszerzania kontekstu LlamaIndex, dokumenty routowania LiteLLM, dokumenty obserwowalności LangSmith.
-
Własnoręczne runtime’y i systemy asystentów: vLLM, serwer llama.cpp, wektory Ollama, dokumenty i repo OpenClaw, dokumenty i repo Hermes.
-
Magazynowanie i obserwowalność: Pinecone, Weaviate, pgvector, Milvus, OpenTelemetry, OpenLIT.
-
Artykuły badawcze: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Lost in the Middle i SelfCheckGPT.
