
Kanban w Hermes Agent do samodzielnego hostowania workflow LLM
Kontroluj obciążenie Hermes Kanban w autonomicznie hostowanym LLM.
Agent Hermes dostarcza tablicę w stylu Kanban oraz Hermes Gateway, które mogą przeciążyć Twoją samodzielnie hostowaną LLM, jeśli zbyt wiele zadań zostanie wysłanych jednocześnie.
Mogę stwierdzić, że w ten sposób możesz łatwo przeprowadzić atak DDoS na własną LLM.
Hermes Kanban to trwała tablica wielu profili oparta na ~/.hermes/kanban.db.
Każdy pas (lane) reprezentuje fazę pracy, a każda karta to zadanie, które może zostać objęte przez konkretny profil Hermes.
Domyślnie dispatcher może promować wiele zadań ready w jednym przebiegu. Jest to w porządku dla elastycznych API w chmurze, ale może przeciążyć mały samodzielnie hostowany klastr GPU.
Jeśli dopiero poznajesz ten stos technologiczny, zacznij od szerszego przewodnika po konfigurację i operacje Hermes oraz filaru Systemy AI dotyczącego otaczającej architektury.
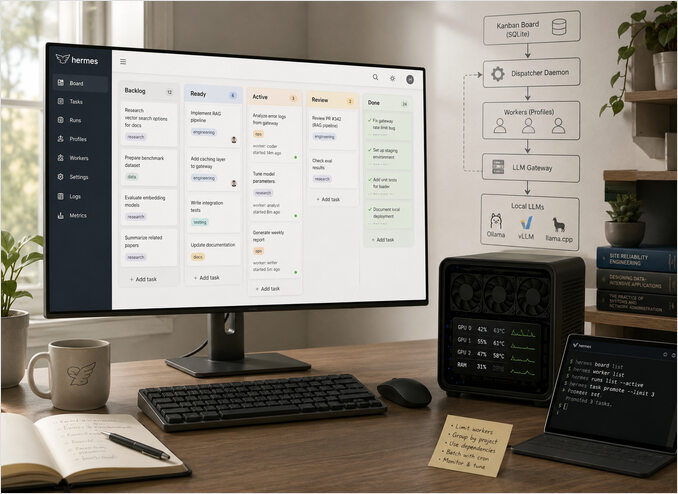
Ten post pokazuje, jak:
- Zrozumieć interakcję dysponowania w Hermes Kanban z Twoją bramką LLM.
- Kontrolować równoległość bezpiecznie dla ciężkich zadań.
- Grupować promowanie w partiach za pomocą cron, aby zadania w tle nie kolidowały z interaktywnym użytkowaniem.
- Monitorować i stroić system, aby GPU były zajęte, ale nie przeciążone.
Jak działają Hermes Kanban i dispatcher
Na wysokim poziomie system ma trzy warstwy:
- Tablica (Board) - trwały stan SQLite dla zadań, kolumn, relacji i historii.
- Pracownicy (Workers) - profile Hermes uruchamiane w izolowanych przestrzeniach roboczych do przetwarzania zadania.
- Dispatcher - długotrwały proces, który skanuje karty gotowe do wysłania i rozpoczyna przebiegi.
Zadania tworzone z CLI lub pulpitu zwykle zaczynają się od backlog lub ready. Poniższe podkomendy hermes kanban są zarysowane w ściągawce CLI Agent Hermes.
Dispatcher skanuje kwalifikujące się karty, przejmuje jedną atomowo i uruchamia przypisany profil z jego narzędziami i pamięcią.
Każdy pracownik następnie wywołuje Twoją bramkę LLM lub lokalny runtime (na przykład punkty końcowe zgodne z OpenAI oparte o Ollama, vLLM lub llama.cpp). Dla wyborów wdrożenia w tych runtime, użyj Hosting LLM w 2026: Porównanie lokalnej, samodzielnie hostowanej i chmurowej infrastruktury. Jeśli stroisz rozgałęzienie żądań w samym Ollama, dobrze pasuje to z Jak Ollama obsługuje równoległe żądania.
Jeśli dodasz wiele ciężkich zadań i nie ograniczysz promowania, Twoja bramka może zostać zalana równoległymi żądaniami.
Na hostu z pojedynczym GPU lub ograniczonym przez CPU, często oznacza to kolejkowanie, thrashing i przekroczenia limitu czasu, zamiast lepszej przepustowości.
Praktyczne ograniczenie dzisiaj
W obecnych wersjach Hermes, na które opiera się wiele zespołów, konfiguracja dyspozytora ujawnia tylko dwa klucze dysponowania Kanban i nie stosuje globalnego limitu aktywnych zadań z konfiguracji:
kanban:
  dispatch_in_gateway: false
  dispatch_interval_seconds: 10
Dla kontroli aktywnych zadań, polegaj na eksplicytnej częstotliwości wysyłania (hermes kanban dispatch --max ...) oraz modelowaniu zależności.
Znane pułapki:
- Nie uruchamiaj dysponowania wbudowanego w bramkę i
hermes kanban daemon --forcena tej samej tablicy, inaczej mogą wystąpić wyścigi po przyjęciu (claim races). - Jeśli bramka jest wyłączona, zadania
readynie są wysyłane i mogą wybuchnąć później, gdy usługa wróci. - Dłuższe interwały wysyłania mogą wydawać się nierówne, ponieważ przyjmowanie następuje w tickach.
- Zachowanie może się różnić w zależności od wersji, ponieważ problemy brzegowe z stanem przebiegu i ponownym przejęciem były łatane z czasem.
Szybka weryfikacja, gdy zachowanie wydaje się błędne:
# 1) potwierdź, że dokładnie jedna ścieżka dyspozytora jest aktywna
pgrep -af "hermes gateway start|hermes kanban daemon"

# 2) sprawdź spięte klucze dyspozytora Kanban
rg "dispatch_in_gateway|dispatch_interval_seconds" ~/.hermes/config.yaml

# 3) zbadać kształt kolejki
hermes kanban list --status ready
hermes kanban list --status running
Kluczowe idee:
- Konfiguracja dyspozytora spięta z
dispatch_in_gatewayidispatch_interval_seconds. dispatch --maxogranicza nowe uruchomienia w danym przebiegu, a nie całkowitą liczbę działających zadań.- Dla małych samodzielnie hostowanych klastrów, zaczynaj konserwatywnie i zwiększaj tylko po ustabilizowaniu się opóźnień.
Przy pierwszym wdrażaniu Hermes w pobliżu Twojej bramki LLM:
- Zostaw w konfiguracji tylko wspierane klucze dyspozytora Kanban.
- Obserwuj wykorzystanie GPU i CPU pod rzeczywistym naciskiem kolejki.
- Używaj Strategii 1 lub Strategii 2 dla deterministycznego tempa.
Wyniki badań i przyczyna źródłowa
hermes kanban dispatch nie odczytuje max_active_tasks z config.yaml.
W hermes_cli/kanban.py, komenda dispatch ujawnia --max jako limit CLI (domyślnie None) i przekazuje tylko args.max do kb.dispatch_once(...). Nie ma tu wyszukiwania konfiguracji max_active_tasks. Zobacz hermes_cli/kanban.py raw.
Następnie w kanban_db.dispatch_once, jedynym limitem jest max_spawn, z logiką równoważną:
if max_spawn is not None and spawned >= max_spawn:
    break
Brak jest sprawdzenia już działających zadań i brak odniesienia do max_active_tasks w tej ścieżce wysyłania. Zobacz hermes_cli/kanban_db.py raw.
Skuteczne zachowanie:
hermes kanban dispatch
bez limitu dla danego przebiegu (ograniczone rozmiarem kolejki ready).
hermes kanban dispatch --max 2
ogranicza tylko nowe uruchomienia w danym przebiegu, a nie całkowitą liczbę działających zadań.
Spięte pokrętła konfiguracji wokół wysyłania w bramce to kanban.dispatch_in_gateway i kanban.dispatch_interval_seconds.
Więc max_active_tasks jest ignorowane w tej ścieżce wysyłania, ponieważ nie jest tam zaimplementowane.
Strategia 1 - Kodowanie zależności dla ściśle sekwencyjnych przepływów
Niektóre przepływy pracy powinny działać ściśle jedno po drugim — na przykład:
- wieloetapowe potoki danych z współdzielonymi artefaktami pośrednimi
- migracje lub zmiany infrastruktury
- zadania batchowe zapisujące do tego samego magazynu obiektów lub bazy danych
Hermes Kanban wspiera zależności rodzic-dziecko między zadaniami, tak że karta dziecka staje się wysyłalna dopiero, gdy rodzic jest ukończony.
Możesz to zmodelować za pomocą małego skryptu pomocniczego wokół CLI Hermes:
#!/usr/bin/env bash

set -euo pipefail

parent_id="$(hermes kanban add \
  --title 'Ingest customer logs for April' \
  --profile 'etl-worker' \
  --column backlog)"

hermes kanban add \
  --title 'Generate April anomaly report' \
  --profile 'analytics-worker' \
  --column backlog \
  --parent "${parent_id}"

hermes kanban add \
  --title 'Publish April summary to dashboard' \
  --profile 'reporting-worker' \
  --column backlog \
  --parent "${parent_id}"
Z odpowiednią polityką tablicy i niskimi limitami dyspozytora najpierw działa tylko zadanie rodzica.
Gdy się zakończy, zadania dzieci stopniowo stają się gotowe, a dispatcher pobiera je po kolei, nigdy nie przekraczając Twoich limitów współbieżności.
Strategia 2 - Użyj Linux cron z limitem dysponowania świadomym działających zadań
Jeśli chcesz deterministycznego tempa, użyj cron hosta wraz z małym skryptem opakowującym.
Zamiast zawsze wywoływać dispatch --max 2, najpierw policz aktualnie działające zadania, a następnie wyślij tylko pozostałe sloty.
Utwórz hermes-kanban-dispatch-capped.sh:
#!/usr/bin/env bash
set -euo pipefail

MAX_PARALLEL="${MAX_PARALLEL:-2}"
BOARD="${BOARD:-}"

board_args=()
if [[ -n "$BOARD" ]]; then
  board_args=(--board "$BOARD")
fi

# albo tam, gdzie masz zainstalowany hermes
export PATH="/home/abc/.local/bin:$PATH"

running_out="$(hermes kanban "${board_args[@]}" list --status running)"

if [[ "$running_out" == *"(no matching tasks)"* ]]; then
  running_count=0
else
  running_count="$(printf '%s\n' "$running_out" | wc -l)"
fi

slots=$(( MAX_PARALLEL - running_count ))

if (( slots <= 0 )); then
  echo "Already at limit running=$running_count max=$MAX_PARALLEL dispatch skipped"
  exit 0
fi

echo "running=$running_count max=$MAX_PARALLEL slots=$slots dispatching up to $slots"

hermes kanban "${board_args[@]}" dispatch --max "$slots"
Spraw, aby był wykonalny:
chmod +x ./hermes-kanban-dispatch-capped.sh
Uruchom go za pomocą:
MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Dla konkretnej tablicy:
BOARD=my-board MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Zaplanuj raz na minutę z cron:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-capped.sh >> /var/log/hermes/kanban-cron.log 2>&1
Notatki operacyjne:
- Cron często ma minimalną
PATH, więc jeślihermesnie jest znaleziony, użyj jego pełnej ścieżki w skrypcie (na przykład/usr/local/bin/hermes). - Jeśli zapisujesz dziennik w
/var/log/hermes/..., najpierw utwórz ten katalog i upewnij się, że użytkownik cron ma dostęp do zapisu.
Przykład:
sudo mkdir -p /var/log/hermes
sudo chown "$USER":"$USER" /var/log/hermes
Utwórz lub edytuj wpisy cron za pomocą:
crontab -e
Następnie zweryfikuj za pomocą:
crontab -l
Częstotliwość sub-minutowa z jednym wpisem cron
Cron tyka raz na minutę, ale nadal możesz wysyłać częściej, uruchamiając krótką pętlę wewnątrz skryptu.
Przykład hermes-kanban-dispatch-subminute.sh:
#!/usr/bin/env bash
set -euo pipefail

LOCK_FILE="/tmp/hermes-kanban-dispatch.lock"
RUNS_PER_MINUTE="${RUNS_PER_MINUTE:-4}"    # 4 przebiegi => co 15 sekund
CAP_SCRIPT="${CAP_SCRIPT:-/opt/hermes/scripts/hermes-kanban-dispatch-capped.sh}"

exec 9>"$LOCK_FILE"
flock -n 9 || exit 0

sleep_seconds=$(( 60 / RUNS_PER_MINUTE ))

for ((i=1; i<=RUNS_PER_MINUTE; i++)); do
  "$CAP_SCRIPT"

  if (( i < RUNS_PER_MINUTE )); then
    sleep "$sleep_seconds"
  fi
done
Spraw, aby był wykonalny:
chmod +x ./hermes-kanban-dispatch-subminute.sh
Zaplanuj raz na minutę:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-subminute.sh >> /var/log/hermes/kanban-subminute.log 2>&1
Daje to efektywną częstotliwość sub-minutową, podczas gdy flock zapobiega nakładającym się przebiegom.
Dlaczego to działa:
list --status runningpodaje bieżące obciążenie działające.dispatch --max Nogranicza tylko nowe uruchomienia dla danego przebiegu.- Obliczanie
Njako pozostałych slotów utrzymuje całkowitą liczbę działających zadań blisko Twojego docelowego limitu.
Ważna uwaga: ten limit działa tylko dla wysyłek wykonanych przez ten skrypt.
Wyłącz dysponowanie wbudowane w bramkę, inaczej nadal może promować zadania niezależnie:
kanban:
  dispatch_in_gateway: false
Oficjalna dokumentacja opisuje obie możliwości komend i zaznacza domyślne wartości dysponowania w bramce w przewodniku po funkcjach Kanban: Dokumentacja Hermes Kanban.
Wewnętrzny Cron Hermes
Nie używaj go.
Czy naprawdę chcesz, aby Twoja LLM przetwarzała regularne prompty takie jak Execute in terminal the command /path/hermes-kanban-dispatch-capped.sh, szczególnie gdy jest zajęta wykonywaniem przydatnej pracy?
Monitorowanie i strojenie Hermes Kanban
Niezależnie od wybranej strategii, powinieneś monitorować:
- Metryki bramki LLM — szybkość żądań, opóźnienie, wskaźnik błędów, przepustowość tokenów.
- Zdrowie węzła — wykorzystanie GPU, użycie VRAM, obciążenie CPU i RAM.
- Metryki Hermes — ile zadań jest w backlogu, gotowych, aktywnych i ukończonych.
Dla baz metryk produkcyjnych i pulpity, zobacz Monitorowanie Inferencji LLM w produkcji z Prometheus i Grafana oraz szerszy Hub Wydajności LLM.
Zacznij od niskiej współbieżności, a następnie stopniowo podnoś limity, obserwując:
- rosnące opóźnienie przy stałej przepustowości
- wzrost błędów timeout lub limitu przepustowości
- długie ogony, gdzie niektóre zadania pozostają aktywne przez bardzo długi czas
W momencie, gdy zobaczysz te objawy, cofnij się do poprzedniej stabilnej konfiguracji i trzymaj ją jako domyślną.
Kiedy Kanban jest odpowiednim narzędziem
Hermes Kanban błyszczy, gdy masz:
- długoterminowe backlogi badawcze lub inżynierskie
- współpracę wielu agentów z nazwanymi profilami
- przepływy pracy, które muszą przetrwać restarty i ponowne uruchomienie hosta
- ludzi, którzy chcą pulpitu do triażu pracy
Jeśli potrzebujesz tylko jednego przebiegu, aby stworzyć kilku tymczasowych pomocników, wbudowane narzędzia do delegowania zadań są zwykle prostsze.
Gdy potrzebujesz historii, pulpitów i ścisłej kontroli nad tym, jak Twoi agenci uderzają w samodzielnie hostowane LLM, tablica Kanban wraz z dispatcherem jest odpowiednią podstawą.
Dzięki kilku modyfikacjom konfiguracji i opcjonalnym grupowaniu opartym na cron, możesz utrzymać Hermes Kanban responsywnym, chroniąc jednocześnie swoją bramkę i sprzęt.
Dla szerszego spojrzenia na to, jak pracownicy tła w stylu Hermes pasują do architektur produkcyjnych asystentów AI — w tym planistów, opolegania na kolejkach, protokołów przejmowania, trwałych przepływów pracy i semantycznej ewaluacji — zobacz Agentów Pollingowych w Asystentach AI: 11 Wzorców Implementacji. Gdy wiele nazwanych profili lub specjalistycznych agentów musi koordynować się poza prostym dysponowaniem zadań, Wzorce Orkiestracji Wielu Agentów pokazuje topologie koordynacji — gwiazda z centralnym węzłem, fan-out, rój — które stanowią podstawę większych ustawień wielu agentów na samodzielnie hostowanej infrastrukturze.
