
Ograniczanie LLM przy użyciu ustrukturyzowanych danych wyjściowych: Ollama, Qwen3 oraz Python lub Go
Kilka sposobów na uzyskanie strukturyzowanego wyjścia z Ollama
Wielkie modele językowe (LLM) są potężne, ale w środowisku produkcyjnym rzadko chcemy otrzymywać swobodne akapity. Zamiast tego oczekujemy przewidywalnych danych: atrybutów, faktów lub strukturyzowanych obiektów, które możemy podać jako dane wejściowe do aplikacji. Oto czym jest Strukturyzowany Output LLM.
Wymuszanie schematu zmniejsza częstotliwość występowania błędnych logitów prowadzących do nieważnego JSON, ale temperatura i kary (penalties) wciąż mają znaczenie dla „tyszczy" (stormów) ponownych prób; zobacz parametry inferencji agentycznej dla Qwen i Gemma w przypadku łączenia ograniczeń format z agentami.
Warstwa serwisowa nadal potrzebuje logiki analizy, normalizacji i walidacji—patrz Walidacja strukturyzowanego outputu LLM w Pythonie, która się sprawdza—ponieważ Ollama i klienci mogą nie zgadzać się co do dokładnych łańcuchów znaków, nawet gdy ustawiono format.
Niektórym czasu temu Ollama wprowadził obsługę strukturyzowanego outputu (ogłoszenie), co pozwoliło na ograniczanie odpowiedzi modelu tak, aby pasowały do schematu JSON. Otwiera to drogę do konsekwentnych pipeline’ów ekstrakcji danych dla zadań takich jak katalogowanie funkcji LLM, benchmarkowanie modeli lub automatyzacja integracji systemów.
W tym poście omówimy:
- Czym jest strukturyzowany output i dlaczego jest ważny
- Prosty sposób uzyskiwania strukturyzowanego outputu z LLM
- Jak działa nowa funkcja Ollama
- Przykłady ekstrakcji zdolności LLM:
Czym jest Strukturyzowany Output?
Zazwyczaj LLM-y generują swobodny tekst:
„Model X obsługuje rozumowanie z użyciem myślenia krok po kroku (chain-of-thought), ma okno kontekstu 200K tokenów i obsługuje języki angielski, chiński i hiszpański."
Jest to czytelne, ale trudne do sparsowania.
Zamiast tego, przy użyciu strukturyzowanego outputu prosimy o ścisły schemat:
{
  "name": "Model X",
  "supports_thinking": true,
  "max_context_tokens": 200000,
  "languages": ["English", "Chinese", "Spanish"]
}
Ten JSON jest łatwy do zweryfikowania, przechowywania w bazie danych lub podania do interfejsu użytkownika (UI).
Prosty sposób uzyskania strukturyzowanego outputu z LLM
LLM-y czasami rozumieją, czym jest schemat, i możemy poprosić LLM o zwrócenie outputu w JSON zgodnie z konkretnym schematem. Model Qwen3 od Alibaba jest zoptymalizowany pod kątem rozumowania i strukturyzowanych odpowiedzi. Możesz wprost polecić mu odpowiadanie w formacie JSON.
Przykład 1: Użycie Qwen3 z ollama w Pythonie, z żądaniem JSON ze schematem
import json
import ollama

prompt = """
You are a structured data extractor.
Return JSON only.
Text: "Elon Musk is 53 and lives in Austin."
Schema: { "name": string, "age": int, "city": string }
"""

response = ollama.chat(model="qwen3", messages=[{"role": "user", "content": prompt}])
output = response['message']['content']

# Parse JSON
try:
    data = json.loads(output)
    print(data)
except Exception as e:
    print("Error parsing JSON:", e)
Output:
{"name": "Elon Musk", "age": 53, "city": "Austin"}
Wymuszanie walidacji schematu za pomocą Pydantic
Aby uniknąć błędnie sformatowanych outputów, możesz zwalidować dane względem schematu Pydantic w Pythonie.
from pydantic import BaseModel

class Person(BaseModel):
    name: str
    age: int
    city: str

# Suppose 'output' is the JSON string from Qwen3
data = Person.model_validate_json(output)
print(data.name, data.age, data.city)
Pozwala to upewnić się, że output odpowiada oczekiwanej strukturze.
Strukturyzowany Output w Ollama
Ollama umożliwia teraz przekazanie schematu w parametrze format. Model jest następnie ograniczany tak, aby odpowiadał wyłącznie w JSON zgodnym ze schematem (dokumentacja).
W Pythonie zazwyczaj definiujesz swój schemat za pomocą Pydantic i pozwalasz Ollama na użycie go jako schematu JSON.
Przykład 2: Ekstrakcja metadanych funkcji LLM
Załóżmy, że masz fragment tekstu opisujący możliwości LLM:
„Qwen3 oferuje silne wsparcie wielojęzyczności (angielski, chiński, francuski, hiszpański, arabski). Pozwala na kroki rozumowania (chain-of-thought). Okno kontekstu wynosi 128K tokenów."
Chcesz otrzymać dane strukturyzowane:
from pydantic import BaseModel
from typing import List
from ollama import chat

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]

prompt = """
Analyze the following description and return the model’s features in JSON only.
Model description:
'Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
It allows reasoning steps (chain-of-thought).
The context window is 128K tokens.'
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=LLMFeatures.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Możliwy output:
{
  "name": "Qwen3",
  "supports_thinking": true,
  "max_context_tokens": 128000,
  "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
}
Przykład 3: Porównanie wielu modeli
Przekazuj opisy wielu modeli i ekstrahuj je do formy strukturyzowanej:
from typing import List

class ModelComparison(BaseModel):
    models: List[LLMFeatures]

prompt = """
Extract features of each model into JSON.

1. Llama 3.1 supports reasoning. Context window is 128K. Languages: English only.
2. GPT-4 Turbo supports reasoning. Context window is 128K. Languages: English, Japanese.
3. Qwen3 supports reasoning. Context window is 128K. Languages: English, Chinese, French, Spanish, Arabic.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=ModelComparison.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Output:
{
  "models": [
    {
      "name": "Llama 3.1",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English"]
    },
    {
      "name": "GPT-4 Turbo",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Japanese"]
    },
    {
      "name": "Qwen3",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
    }
  ]
}
Dzięki temu staje się trywialnym zadaniem benchmarkować, wizualizować lub filtrować modele według ich cech.
Przykład 4: Automatyczne wykrywanie brakujących danych
Możesz nawet dozwolić wartości null, gdy dane pole jest brakujące:
from typing import Optional

class FlexibleLLMFeatures(BaseModel):
    name: str
    supports_thinking: Optional[bool]
    max_context_tokens: Optional[int]
    languages: Optional[List[str]]
Pozwala to zachować ważność schematu nawet wtedy, gdy niektóre informacje są nieznane.
Zalety, Ograniczenia i Dobre Praktyki
Używanie strukturyzowanego outputu za pośrednictwem Ollama (lub dowolnego systemu go obsługującego) oferuje wiele zalet — ale ma również pewne ograniczenia.
Zalety
- Silniejsze gwarancje: Model jest proszony o dostosowanie się do schematu JSON, a nie do swobodnego tekstu.
- Łatwiejsze parsowanie: Możesz bezpośrednio użyć
json.loadslub zwalidować za pomocą Pydantic / Zod, zamiast korzystać z regex lub heurystyk. - Ewolucja oparta na schemacie: Możesz wersjonować swój schemat, dodawać pola (z wartościami domyślnymi) i utrzymywać kompatybilność wsteczną.
- Interoperacyjność: Systemy dół łańcucha (downstream) oczekują danych strukturyzowanych.
- Determinizm (lepszy przy niskiej temperaturze): Gdy temperatura jest niska (np. 0), model jest bardziej skłonny do sztywnego trzymywania się schematu. W dokumentacji Ollama zaleca się to.
Ograniczenia i Pułapki
- Niezgodność schematu: Model nadal może odbiegać—np. pominąć wymagane właściwość, zmienić kolejność kluczy lub dodać dodatkowe pola. Potrzebujesz walidacji.
- Złożone schematy: Bardzo głębokie lub rekurencyjne schematy JSON mogą wprowadzać model w błąd lub prowadzić do awarii.
- Niejednoznaczność w prompcie: Jeśli Twój prompt jest niejasny, model może błędnie zgadywać pola lub jednostki.
- Niespójność między modelami: Niektóre modele mogą lepiej lub gorzej respektować ograniczenia strukturyzowane.
- Limity tokenów: Sam schemat dodaje koszt tokenów do promptu lub wywołania API.
Dobre Praktyki i Wskazówki (na podstawie bloga Ollama + doświadczenia)
- Używaj Pydantic (Python) lub Zod (JavaScript) do definiowania schematów i automatycznego generowania schematów JSON. Unika to ręcznych błędów.
- Zawsze zawieraj instrukcje takie jak „odpowiadaj tylko w JSON” lub „nie włączaj komentarzy ani dodatkowego tekstu” w swoim prompcie.
- Używaj temperature = 0 (lub bardzo niskiej), aby zminimalizować losowość i zmaksymalizować zgodność ze schematem. Ollama zaleca determinizm.
- Waliduj i w razie potrzeby stosuj mechanizm zapasowy (np. ponowna próba lub czyszczenie danych), gdy parsowanie JSON lub walidacja schematu nie powiedzie się.
- Zacznij od prostszego schematu, a następnie stopniowo go rozszerzaj. Nie komplikuj nadmiernie na starcie.
- Włącz pomocne, ale ograniczone instrukcje błędów: np. jeśli model nie może wypełnić wymaganego pola, niech odpowiada
nullzamiast go pomijać (jeśli Twój schemat na to pozwala).
Przykład w Go 1: Ekstrakcja cech LLM
Oto proste program w Go, który prosi Qwen3 o strukturyzowany output dotyczący cech LLM.
package main

import (
	"context"
	"encoding/json"
	"fmt"
	"log"

	"github.com/ollama/ollama/api"
)

type LLMFeatures struct {
	Name             string   `json:"name"`
	SupportsThinking bool     `json:"supports_thinking"`
	MaxContextTokens int      `json:"max_context_tokens"`
	Languages        []string `json:"languages"`
}

func main() {
	client, err := api.ClientFromEnvironment()
	if err != nil {
		log.Fatal(err)
	}

	prompt := `
  Analyze the following description and return the model’s features in JSON only.
  Description:
  "Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
  It allows reasoning steps (chain-of-thought).
  The context window is 128K tokens."
  `

	// Define the JSON schema for structured output
	formatSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"name": map[string]string{
				"type": "string",
			},
			"supports_thinking": map[string]string{
				"type": "boolean",
			},
			"max_context_tokens": map[string]string{
				"type": "integer",
			},
			"languages": map[string]any{
				"type": "array",
				"items": map[string]string{
					"type": "string",
				},
			},
		},
		"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
	}

	// Convert schema to JSON
	formatJSON, err := json.Marshal(formatSchema)
	if err != nil {
		log.Fatal("Failed to marshal format schema:", err)
	}

	req := &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  formatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var features LLMFeatures
	var rawResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		rawResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(rawResponse), &features); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	fmt.Printf("Parsed struct: %+v\n", features)
}
Aby skompilować i uruchomić ten program w Go - zakładając, że mamy plik main.go w folderze ollama-struct,
Musimy wykonać wewnątrz tego folderu:
# initialise module
go mod init ollama-struct
# pull all the dependencise
go mod tidy
# build & execute
go build -o ollama-struct main.go
./ollama-struct
Przykładowy Output
Parsed struct: {Name:Qwen3 SupportsThinking:true MaxContextTokens:128000 Languages:[English Chinese French Spanish Arabic]}
Przykład w Go 2: Porównywanie wielu modeli
Możesz rozszerzyć to, aby ekstrahować listę modeli do porównania.
  type ModelComparison struct {
		Models []LLMFeatures `json:"models"`
	}

	prompt = `
	Extract features from the following model descriptions and return as JSON:

	1. PaLM 2: This model has limited reasoning capabilities and focuses on basic language understanding. It supports a context window of 8,000 tokens. It primarily supports English language only.
	2. LLaMA 2: This model has moderate reasoning abilities and can handle some logical tasks. It can process up to 4,000 tokens in its context. It supports English, Spanish, and Italian languages.
	3. Codex: This model has strong reasoning capabilities specifically for programming and code analysis. It has a context window of 16,000 tokens. It supports English, Python, JavaScript, and Java languages.

	Return a JSON object with a "models" array containing all models.
	`

	// Define the JSON schema for model comparison
	comparisonSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"models": map[string]any{
				"type": "array",
				"items": map[string]any{
					"type": "object",
					"properties": map[string]any{
						"name": map[string]string{
							"type": "string",
						},
						"supports_thinking": map[string]string{
							"type": "boolean",
						},
						"max_context_tokens": map[string]string{
							"type": "integer",
						},
						"languages": map[string]any{
							"type": "array",
							"items": map[string]string{
								"type": "string",
							},
						},
					},
					"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
				},
			},
		},
		"required": []string{"models"},
	}

	// Convert schema to JSON
	comparisonFormatJSON, err := json.Marshal(comparisonSchema)
	if err != nil {
		log.Fatal("Failed to marshal comparison schema:", err)
	}

	req = &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  comparisonFormatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var comp ModelComparison
	var comparisonResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		comparisonResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(comparisonResponse), &comp); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	for _, m := range comp.Models {
		fmt.Printf("%s: Context=%d, Languages=%v\n", m.Name, m.MaxContextTokens, m.Languages)
	}
Przykładowy Output
PaLM 2: Context=8000, Languages=[English]
LLaMA 2: Context=4000, Languages=[English Spanish Italian]
Codex: Context=16000, Languages=[English Python JavaScript Java]
Nawiasem mówiąc, qwen3:4b na tych przykładach działa dobrze, tak samo jak qwen3:8b.
Dobre Praktyki dla Deweloperów Go
- Ustaw temperaturę na 0, aby uzyskać maksymalną zgodność ze schematem.
- Waliduj za pomocą
json.Unmarshali stosuj mechanizm zapasowy, jeśli parsowanie się nie powiedzie. - Trzymaj schematy proste — głęboko zagnieżdżone lub rekurencyjne struktury JSON mogą powodować problemy.
- Pozwól na pola opcjonalne (użyj
omitemptyw tagach struktury Go), jeśli oczekujesz brakujących danych. - Dodaj ponowne próby (retries), jeśli model okazjonalnie emituje nieważny JSON.
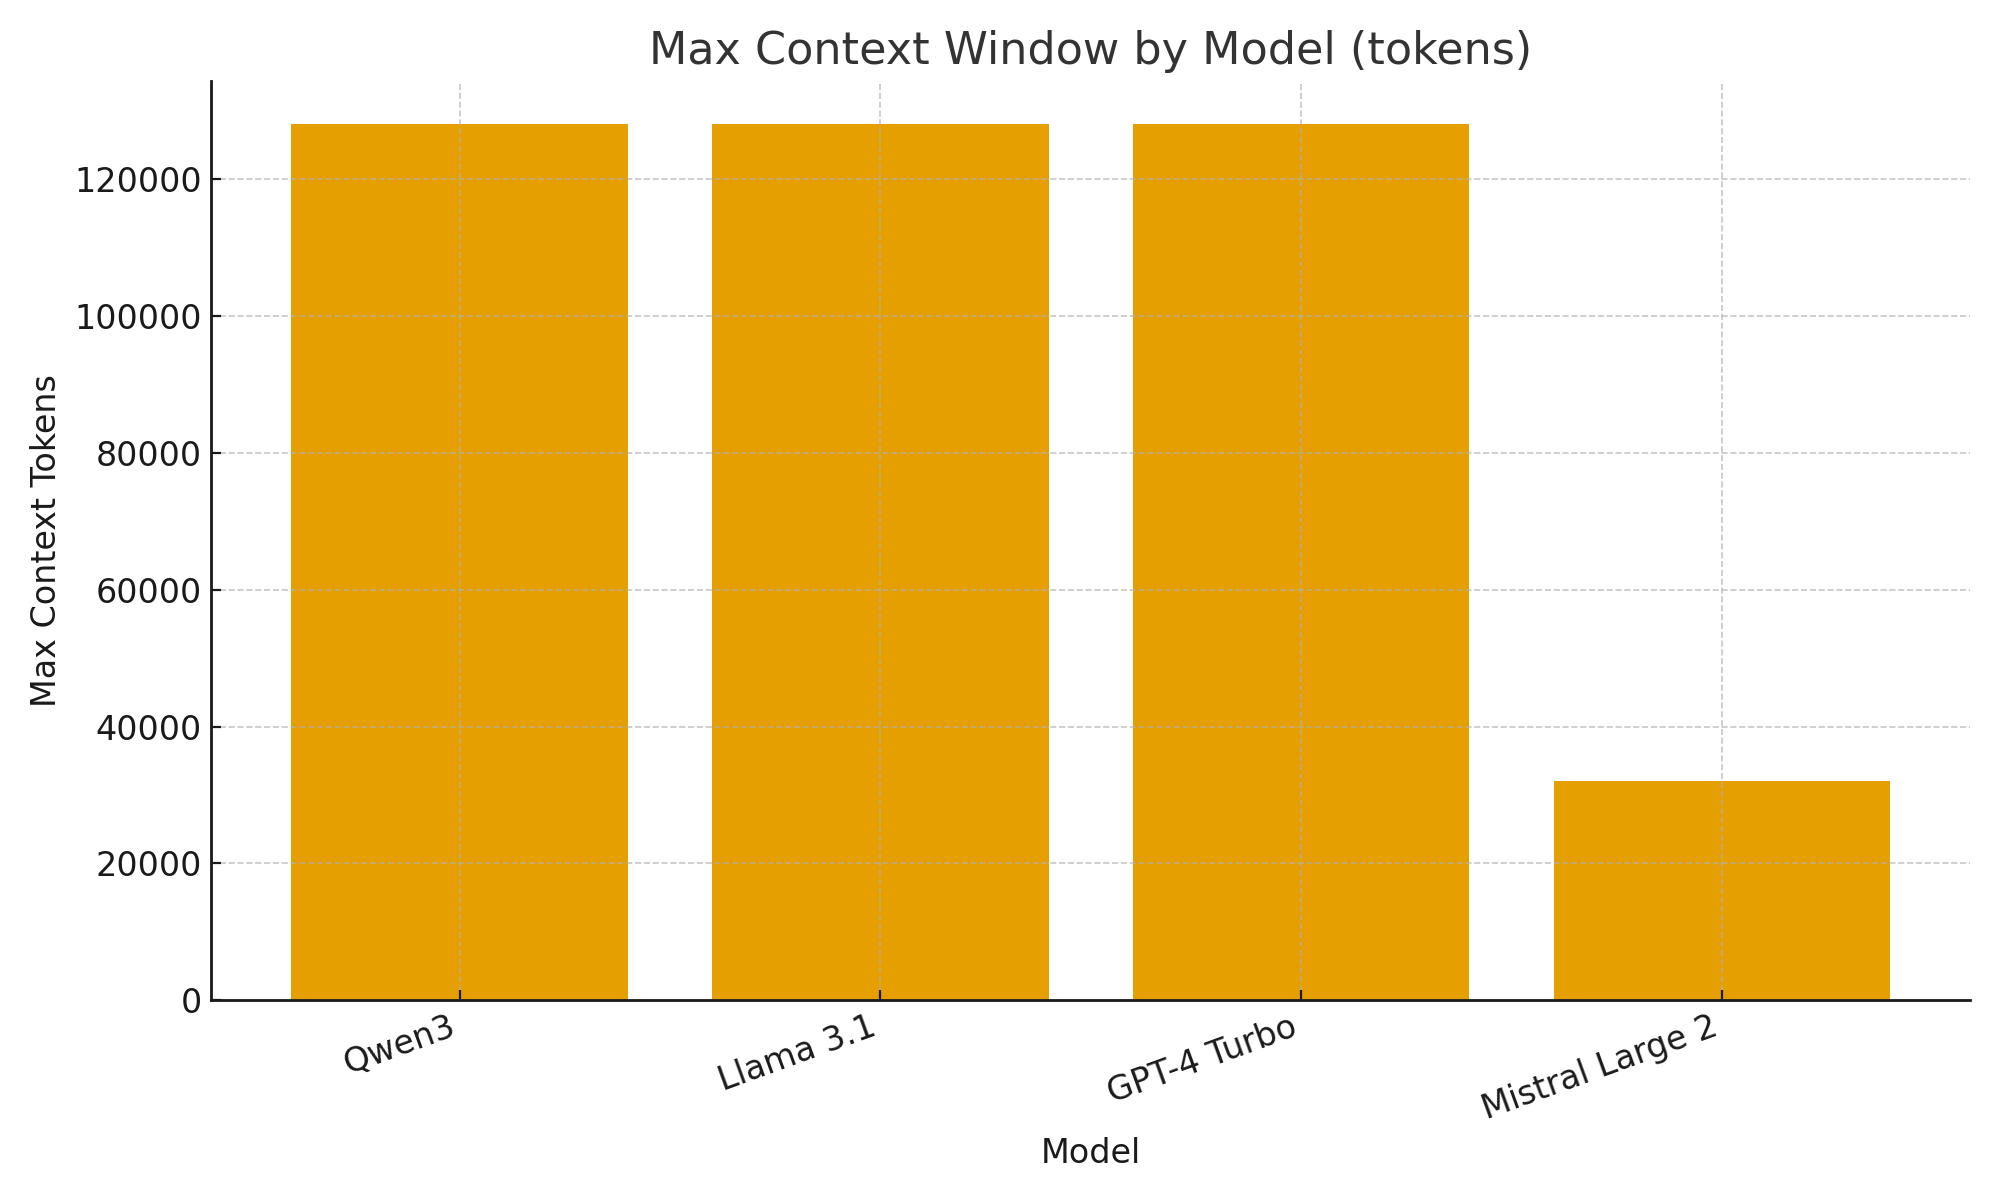
Pełny przykład - Rysowanie wykresu z cech LLM (Krok po kroku: od strukturyzowanego JSON do tabel porównawczych)
- Zdefiniuj schemat dla danych, których potrzebujesz
Użyj Pydantic, aby zarówno (a) wygenerować schemat JSON dla Ollama, jak i (b) zwalidować odpowiedź modelu.
from pydantic import BaseModel
from typing import List, Optional

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]
- Poproś Ollama, aby zwracał tylko JSON w tej formie
Przekazuj schemat w format= i obniżaj temperaturę dla determinizmu.
from ollama import chat

prompt = """
Extract features for each model. Return JSON only matching the schema.
1) Qwen3 supports chain-of-thought; 128K context; English, Chinese, French, Spanish, Arabic.
2) Llama 3.1 supports chain-of-thought; 128K context; English.
3) GPT-4 Turbo supports chain-of-thought; 128K context; English, Japanese.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format={"type": "array", "items": LLMFeatures.model_json_schema()},
    options={"temperature": 0}
)

raw_json = resp.message.content  # JSON list of LLMFeatures
- Zweryfikuj i znormalizuj
Zawsze waliduj przed użyciem w produkcji.
from pydantic import TypeAdapter

adapter = TypeAdapter(list[LLMFeatures])
models = adapter.validate_json(raw_json)  # -> list[LLMFeatures]
- Zbuduj tabelę porównawczą (pandas)
Przekształć zweryfikowane obiekty w DataFrame, który można sortować/filtrować i eksportować.
import pandas as pd

df = pd.DataFrame([m.model_dump() for m in models])
df["languages_count"] = df["languages"].apply(len)
df["languages"] = df["languages"].apply(lambda xs: ", ".join(xs))

# Reorder columns for readability
df = df[["name", "supports_thinking", "max_context_tokens", "languages_count", "languages"]]

# Save as CSV for further use
df.to_csv("llm_feature_comparison.csv", index=False)
- (Opcjonalnie) Szybkie wizualizacje
Proste wykresy pomagają szybko przeanalizować różnice między modelami.
import matplotlib.pyplot as plt

plt.figure()
plt.bar(df["name"], df["max_context_tokens"])
plt.title("Max Context Window by Model (tokens)")
plt.xlabel("Model")
plt.ylabel("Max Context Tokens")
plt.xticks(rotation=20, ha="right")
plt.tight_layout()
plt.savefig("max_context_window.png")
TL;DR
Dzięki nowej obsłudze strukturyzowanego outputu w Ollama, możesz traktować LLM-y nie tylko jako czatboty, ale jako silniki ekstrakcji danych.
Powyższe przykłady pokazały, jak automatycznie ekstrahować strukturyzowane metadane dotyczące cech LLM, takich jak wsparcie dla rozumowania, rozmiar okna kontekstu i obsługiwane języki — zadań, które inaczej wymagałyby kruchego parsowania.
Niezależnie od tego, czy budujesz katalog modeli LLM, dashboard do ewaluacji, czy asystenta badawczego z napędem AI, strukturyzowane outputy sprawiają, że integracja jest gładka, niezawodna i gotowa do produkcji.
