
Arquitetura do Assistente de IA: LLM, Memória, Ferramentas, Roteamento, Observabilidade
Como assistentes realmente sérios são construídos.
Um assistente de IA de produção não é “um LLM com um prompt”. É um sistema que aceita intenção, mantém estado, decide quando recuperar ou agir e expõe detalhes suficientes em tempo de execução para depurar falhas.
Essa visão em nível de sistema é o que o Cluster de Sistemas de IA explora quando assistentes vão além de uma única invocação de modelo.
A OpenAI descreve agentes como aplicações que planejam, chamam ferramentas, colaboram e mantêm estado suficiente para trabalho em múltiplas etapas, enquanto a Anthropic enquadra o mesmo problema como uma estrutura de gerenciamento que pode executar arquivos, comandos, acesso à web e código com segurança.
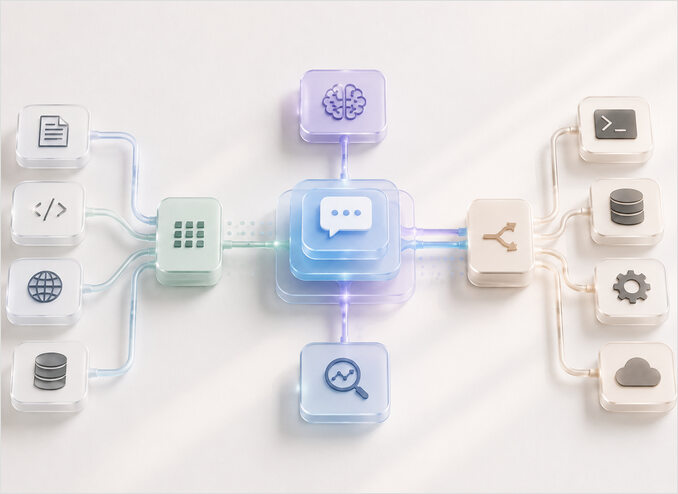
A arquitetura mais limpa divide responsabilidades em cinco camadas: LLM, Memória, Ferramentas, Roteamento e Observabilidade. Essa divisão corresponde às capacidades expostas pelas APIs principais de provedores, pela MCP, por tempos de execução auto-hospedados como vLLM e llama.cpp e por sistemas de assistentes reais como OpenClaw e Hermes.
A memória deve ser tratada como mais do que “contexto mais longo”. Sistemas de recuperação transformam conhecimento externo em memória não paramétrica explícita — o mesmo espaço de projeto coberto em profundidade pela Geração Aumentada por Recuperação (RAG) — e tanto as orientações de contexto da Anthropic quanto o paper “Lost in the Middle” avisam que simplesmente empacotar mais tokens no contexto não garante recuperação confiável.
O uso de ferramentas é um limite de contrato, não mágica. A OpenAI function calling, o Anthropic tool use e a MCP se baseiam todos no mesmo padrão: o modelo emite uma request estruturada, algum tempo de execução o executa e o resultado flui de volta para a conversa. Se esse limite for descuidado, o assistente se torna descuidado.
Meu viés é simples: comece chato. Um orquestrador, um caminho de memória durável, um trace por request e uma política explícita para execução de ferramentas. Gráficos multi-agente são úteis, mas apenas após você conseguir explicar seus casos de falha de agente único sem adivinhar.
O que é um sistema de assistente de IA
Uma definição prática é esta: um sistema de assistente de IA é um tempo de execução que transforma a intenção do usuário em uma resposta ou ação combinando uma interface de modelo, montagem de contexto, execução de ferramentas, gerenciamento de estado e telemetria. É por isso que os documentos úteis não são apenas cartões de modelo. Os documentos úteis são referências de API, contratos de ferramentas, guias de recuperação, documentos de roteamento e documentos de rastreamento. A API de Respostas da OpenAI expõe interações com estado, ferramentas embutidas e function calling. A API Claude da Anthropic expõe acesso direto a Mensagens bem como Agentes Gerenciados. O OpenClaw e o Hermes vão um passo além e mostram o que acontece quando você coloca essas capacidades atrás de gateways persistentes, canais, sessões e memória.
Em outras palavras, um sistema de assistente tem um contrato mais amplo do que uma completion de chat. Um bom contrato interno se parece com algo assim:
AssistantRequest  = intenção do usuário + identidade + sessão + anexos + política
AssistantResponse = resposta + ações + citações + mudanças de estado + id de trace
Esse contrato importa porque todo desacordo de produção eventualmente se reduz a uma dessas perguntas: qual contexto estava visível, qual ferramenta executou, qual modelo respondeu, qual memória foi lida ou escrita e onde o trace diz que o sistema gastou tempo. A OpenTelemetry define traces como o caminho de uma request através de uma aplicação, que é exatamente a abstração que assistentes sérios precisam. A LangSmith e a OpenLIT então especializam essa ideia para LLMs, ferramentas, bancos vetoriais e fluxos de trabalho de agentes.
Componentes e interfaces principais
A divisão de componentes abaixo é a que eu acho mais durável. É também a divisão que melhor se alinha com as APIs oficiais e os tempos de execução open-source que as pessoas realmente operam.
| Camada | Responsabilidade principal | Interface típica | Tecnologias de exemplo |
|---|---|---|---|
| Camada de LLM | Raciocinar, gerar, decidir, emitir chamadas estruturadas | API de Respostas, API de Mensagens, endpoints compatíveis com OpenAI ou Anthropic | OpenAI, Anthropic, vLLM, llama.cpp, Ollama |
| Camada de Memória | Manter estado de sessão, notas duráveis e conhecimento pesquisável | embeddings, busca vetorial, ferramentas de leitura/escrita de memória, APIs de recuperação | Embeddings e bancos vetoriais da OpenAI, Pinecone, Weaviate, pgvector, Milvus, memória Hermes, memória OpenClaw |
| Camada de Ferramentas | Ler dados e executar ações fora do modelo | Ferramentas com esquema JSON, ferramentas MCP, busca de arquivos e web, ferramentas nativas de tempo de execução | Function calling da OpenAI, uso de ferramentas da Anthropic, MCP, ferramentas LangChain, ferramentas de query LlamaIndex |
| Camada de Roteamento | Escolher modelo, backend, política e caminho do tenant | Aliases de modelo, grupos de failover, verificações de saúde, orçamentos, ligações de canal | LiteLLM, roteamento multi-agente OpenClaw, resolução de tempo de execução de provedores Hermes |
| Observabilidade | Explicar o que aconteceu e por quê | Traces, spans, logs, métricas, execuções de avaliação | OpenTelemetry, LangSmith, OpenLIT |
A tabela acima é derivada das interfaces oficiais de provedores, MCP, documentos de bancos de dados vetoriais e documentos de tempo de execução para vLLM, llama.cpp, OpenClaw e Hermes.
A Camada de LLM deve fazer bem três coisas: consumir um contexto de trabalho atual, emitir uma resposta final ou uma request de ação estruturada e retornar metadados suficientes para suportar retries e rastreamento. A API de Respostas da OpenAI é explicitamente projetada para interações com estado mais ferramentas embutidas e function calling. A API de Mensagens da Anthropic expõe o mesmo loop principal através de blocos tool_use e retornos tool_result, enquanto Agentes Gerenciados lhe dá uma estrutura hospedada se você não quiser construir o loop você mesmo. Tempos de execução auto-hospedados como vLLM e llama.cpp importam porque eles preservam interfaces familiares no estilo do provedor enquanto deixam você colocar inferência dentro do seu próprio ambiente.
A Camada de Memória deve ser mentalmente dividida em três buckets: memória de trabalho, memória simbólica durável e memória semântica pesquisável. Os embeddings da OpenAI retornam vetores que podem ser indexados e pesquisados; a Recuperação e Busca de Arquivo da OpenAI então adicionam busca semântica e por palavra-chave por cima de bancos vetoriais. Pinecone, Weaviate, pgvector e Milvus representam quatro formas de armazenamento comuns: totalmente gerenciado, vetor-nativo open-source, nativo de Postgres e banco vetorial distribuído. Hermes e OpenClaw adicionam um lembrete útil de que nem toda memória pertence a um banco vetorial: notas baseadas em arquivo, promoções revisadas e instantâneos escopados de sessão são frequentemente o design mais honesto. Sistemas de Memória em Assistentes de IA mapeia o modelo entre frameworks; Sistema de Memória do Agente Hermes desdobra memória central limitada e instantâneos de sessão congelados em um produto.
A Camada de Ferramentas é onde um assistente deixa de ser um resumidor e começa a ser software. O function calling da OpenAI trata ferramentas como funcionalidade definida por esquema que o modelo pode decidir invocar. A Anthropic diz a mesma coisa mais explicitamente: o uso de ferramentas é um contrato entre sua aplicação e o modelo, e o modelo nunca executa nada por sua conta. A MCP generaliza esse contrato em um protocolo cliente-servidor onde hosts se conectam a um ou mais servidores que expõem ferramentas, prompts e recursos — o mesmo limite descrito passo a passo em Servidor MCP em Go. LangChain e LlamaIndex se encaixam confortavelmente aqui como bibliotecas de orquestração: LangChain foca em uma arquitetura de agente pré-construída e integrações, enquanto LlamaIndex foca em acesso a dados aumentado por contexto, motores de query e fluxos de trabalho.
A Camada de Roteamento existe porque “qual modelo?” nunca é a única pergunta. Você também precisa de “qual caminho de provedor, qual tenant, qual orçamento, qual classe de latência e qual failover?”. LiteLLM é útil porque seus documentos oficiais são refrescantemente concretos: escolha ponderada, menos ocupado, baseado em latência, roteamento baseado em custo e failovers limitados são todos padrões de primeira classe. OpenClaw estende o roteamento para cima para isolamento de canal e agente, enquanto Hermes o estende para baixo para slots de modelo para trabalho principal e auxiliar como sumarização, compressão de contexto e roteamento de ferramentas MCP. Esse é o modelo mental certo: o roteador escolhe mais do que um modelo, escolhe uma pista de execução.
A Camada de Observabilidade é o que impede a arquitetura de se tornar folclore. A OpenTelemetry lhe dá a abstração de trace. A LangSmith lhe dá visibilidade de ponta a ponta sobre etapas de aplicação de LLM e suporta formas de implantação em nuvem, híbridas e auto-hospedadas. A OpenLIT lhe dá observabilidade de IA nativa em OpenTelemetry com opções de instrumentação de zero-código e manual, incluindo suporte para LLMs, frameworks de agente, bancos de dados vetoriais e GPUs. Para métricas de produção, traces e padrões de SLO através de fluxos de trabalho de inferência e agente, veja Observabilidade para Sistemas de LLM. Se seu assistente não tem trace por request, span por chamada de modelo e histórico de eventos para execução de ferramentas, você realmente não tem uma arquitetura ainda. Você tem vibes.
Capturar, enriquecer, responder
A sequência que continua aparecendo em sistemas reais é capturar -> enriquecer -> responder -> registrar. Frameworks diferentes o embrulham de formas diferentes, mas o fluxo é estável o suficiente para ser tratado como a espinha dorsal.
A etapa de captura é geralmente mais importante do que parece. OpenClaw e Hermes colocam ambos um gateway persistente à frente do assistente porque o ingress não é apenas entrada de texto. Inclui metadados de canal, identidades, autorização, limites de sessão, mensagens diretas, grupos, ticks de cron e semânticas de entrega. Se você pular essa camada e depender de uma abstração de widget de chat bruto, eventualmente você vai prendê-lo de volta como middleware ad hoc de qualquer forma.
A etapa de enriquecimento é onde sistemas maduros se separam de demos de brinquedo. A Recuperação e Busca de Arquivo da OpenAI tornam a recuperação explícita através de bancos vetoriais e chamadas de busca. LlamaIndex formaliza o mesmo padrão através de conectores de dados, índices, motores de query e fluxos de trabalho. Hermes vai mais longe ao dividir o patrimônio de modelos em slots principais e auxiliares, descarregando trabalho como compressão, sumarização e roteamento para modelos menores ou mais especializados. Esse é um padrão de design que vale a pena roubar: não gaste seus tokens de modelo mais caros em coreografia.
A etapa de resposta não é “gerar texto”. É “fechar o loop atual”. Se o modelo pode responder diretamente, ele faz. Se precisa de uma ferramenta, ele emite uma request estruturada. O contrato de uso de ferramentas da Anthropic e o guia de function calling da OpenAI tornam isso explícito. O motivo disso importar arquiteturalmente é que as saídas agora incluem tanto linguagem quanto fluxo de controle. Seu objeto de resposta é parcialmente prosa e parcialmente plano de tempo de execução.
A etapa de registro é onde as semânticas de consistência aparecem. A Pinecone separa caminhos de escrita e leitura e processa escritas após confirmação durável. A memória do Hermes é injetada como um instantâneo congelado por sessão para que possa preservar desempenho de cache de prefixo, o que significa que novas escritas não aparecem automaticamente no prompt da sessão atual. O sistema de Dreaming do OpenClaw apenas promove candidatos revisados e fundamentados para MEMORY.md, e é opcional em vez de sempre ligado. A lição prática é que a memória raramente é verdadeiramente leitura-apos-escrita em todas as camadas. Você precisa projetar para visibilidade em estágios.
OpenClaw e Hermes como sistemas de referência
OpenClaw e Hermes são casos de referência úteis porque não são apenas wrappers ao redor de uma API de provedor. Ambos apresentam um assistente como um sistema de longa duração com gateways, sessões, ferramentas, memória e múltiplos backends de modelo.
| Preocupação arquitetural | Mapeamento OpenClaw | Mapeamento Hermes |
|---|---|---|
| Ingress e superfícies | Gateway auto-hospedado conectando aplicativos de chat e superfícies de canal | Gateway de mensagens de fundo único conectando muitas plataformas externas |
| Orquestração | Plano de controle centrado em gateway para canais e interações de IA | Loop AIAgent manipulando montagem de prompt, seleção de provedor, despacho de ferramentas, retries e failover |
| Roteamento | Roteamento multi-agente liga tráfego de entrada a agentes isolados com workspaces e sessões separadas | Slots de modelo principais e auxiliares separam raciocínio central de compressão, sumarização, aprovações e roteamento MCP |
| Memória | Memória baseada em arquivo mais memória ativa opcional e promoção de Dreaming em segundo plano | MEMORY.md e USER.md injetados como instantâneo de sessão congelado, mais provedores de memória externos |
| Ferramentas e extensão | Ferramentas embutidas, ferramentas de sessão, plugins de provedor, endpoints personalizados e auto-hospedados | 40+ ferramentas, cliente MCP embutido, toolsets, skills e plugins de provedores de memória |
Este mapeamento está fundamentado nos documentos e repositórios oficiais do OpenClaw e do Hermes. O OpenClaw documenta uma arquitetura de gateway, roteamento multi-agente, suporte a provedores personalizados e auto-hospedados incluindo vLLM e Ollama, memória ativa opcional e promoção baseada em Dreaming. O Hermes documenta um gateway de mensagens, um loop central AIAgent, slots de modelo principais e auxiliares, memória embutida e integração MCP nativa.
Minha leitura um pouco opinada é que ambos os sistemas fazem o mesmo argumento arquitetural em acentos diferentes. O OpenClaw é fortemente gateway-first. O Hermes é fortemente agent-loop-first. Mas ambos rejeitam a ideia rasa de que um assistente é apenas “prompt mais modelo”. Eles modelam canais, identidades, semânticas de memória, superfícies de ferramentas e heterogeneidade de backend como preocupações de primeira classe. Isso é exatamente o que uma arquitetura de produção deve fazer.
Uma pilha híbrida prática inspirada em ambos os sistemas se parece com isso:
edge:
  gateway: hermes ou openclaw

routing:
  proxy: litellm
  policy: ciente de latência e orçamento
  tenancy: escopado por sessão e canal

llm:
  primary: respostas openai ou mensagens anthropic
  local_fallback: vllm
  local_dev: ollama ou llama.cpp

memory:
  session: sqlite ou postgres
  semantic: pgvector ou weaviate
  embeddings: embeddings openai ou embeddings ollama

tools:
  contract: ferramentas json schema mais mcp
  examples: filesystem, browser, busca web, APIs internas

observability:
  traces: opentelemetry
  ai_dashboards: openlit ou langsmith
  evals: evals openai mais conjuntos de regressão específicos do app
Essa pilha é um padrão de implantação raciocinado em vez de um blueprint prescrito por um fornecedor. Funciona porque as interfaces oficiais se alinham: OpenAI e Anthropic expõem APIs orientadas a ferramentas, vLLM e llama.cpp emulam endpoints no estilo do provedor, Ollama lida com modelos e embeddings locais, MCP padroniza ferramentas externas, LiteLLM lida com roteamento e failover, e plataformas compatíveis com OpenTelemetry podem rastrear todo o caminho.
Padrões, tabelas e compensações
Há alguns padrões de assistente repetíveis que valem a pena nomear. Um assistente gerenciado mantém a maior parte do tempo de execução dentro das APIs do provedor. Um assistente com recuperação em primeiro lugar trata memória e busca como o principal diferenciador. Um assistente com ferramentas em primeiro lugar se comporta mais como um operador do que um chatbot. Um assistente de gateway prioriza acesso sempre ativo através de superfícies de mensagem. Uma malha de especialistas decompõe o trabalho em múltiplos agentes ou rotas. Documentos oficiais através da OpenAI, Anthropic, LlamaIndex, LiteLLM, OpenClaw e Hermes suportam versões desses padrões, mesmo que os nomeiem de forma diferente.
| Padrão | Otimiza para | Melhor caso de uso | Custo oculto |
|---|---|---|---|
| Assistente gerenciado | Velocidade de entrega | Copilots internos e bots de suporte | Lock-in do provedor e menos controle sobre detalhes de tempo de execução |
| Assistente com recuperação em primeiro lugar | Respostas fundamentadas sobre dados próprios | Docs, suporte, trabalho de conhecimento | A qualidade da recuperação se torna o produto real |
| Assistente com ferramentas em primeiro lugar | Ação sobre conversa | Fluxos de trabalho de ops, extrações de dados, automações | Efeitos colaterais, retries e aprovações se tornam preocupações centrais |
| Assistente de gateway | Acesso ubíquo | Assistentes pessoais e de equipe através de superfícies de chat | Complexidade de identidade, sessão e segurança |
| Malha de especialistas | Divisão de trabalho | Fluxos de trabalho complexos com fronteiras reais de propriedade | Depuração, orquestração e design de avaliação mais difíceis |
O padrão de malha de especialistas cresce para uma disciplina de engenharia distinta à medida que a contagem de agentes aumenta. Para os seis padrões canônicos de coordenação — orquestrador-trabalhador, pipeline sequencial, fan-out, hierárquico, enxame e malha — com modos de falha específicos e um framework de decisão de produção, veja Padrões de Orquestração Multi-Agente.
Esta tabela de padrões é uma síntese dos documentos de provedores, documentos de frameworks e sistemas de referência, em vez de uma afirmação de qualquer fornecedor único.
| Forma de opção | Componentes típicos | Força | Fraqueza |
|---|---|---|---|
| Gerenciado | Respostas OpenAI ou Agentes Gerenciados Anthropic, busca de arquivo hospedada ou bancos vetoriais | Caminho mais rápido, menos peças móveis, ferramentas hospedadas | Menor controle sobre caminho de dados e semânticas de tempo de execução |
| Híbrido | API de provedor mais roteador e banco vetorial auto-hospedado | Bom equilíbrio de velocidade e controle | Mais contratos para manter |
| Auto-hospedado | vLLM ou llama.cpp ou Ollama, MCP, banco vetorial auto-hospedado, OTel | Forte privacidade e controle de implantação | Maior fardo de ops, sobrecarga de hardware e ajuste |
Notas da tabela: A Busca de Arquivo hospedada da OpenAI é uma ferramenta gerenciada, a Anthropic oferece uma estrutura gerenciada, a Pinecone é um serviço vetorial gerenciado, enquanto vLLM, llama.cpp, Ollama, pgvector, Weaviate, Milvus, LangSmith auto-hospedado e OpenLIT suportam operação auto-gerenciada ou híbrida em vários graus.
| Banco vetorial | Forma | Por que as equipes escolhem | Ponto de atenção |
|---|---|---|---|
| Pinecone | Serviço vetorial gerenciado | Simplicidade operacional forte e arquitetura gerenciada escalável | Dependência externa e economia de serviço gerenciado |
| Weaviate | Banco de dados vetorial open-source | Vetores mais índices invertidos e escolhas de índice flexíveis | Mais ajuste de cluster do que um caminho somente hospedado |
| pgvector | Extensão do Postgres | Manter vetores com dados relacionais e pilha SQL existente | Não é o melhor ajuste para todos os trabalhos de ANN em alta escala |
| Milvus | Banco de dados vetorial distribuído | Escala projetada e ecossistema ao redor da Zilliz Cloud gerenciada | Outro data store especializado para operar |
Notas da tabela: A Pinecone documenta um plano de controle gerenciado e planos de dados regionais. A Weaviate documenta índices vetoriais e invertidos com múltiplos tipos de índice vetorial. O pgvector adiciona busca de vizinho mais próximo exato e aproximado ao Postgres. A Milvus se posiciona como um banco de dados vetorial open-source de alto desempenho e escalável, com a Zilliz Cloud como a opção gerenciada.
| Opção de LLM | Estilo de interface | Melhor em | Ponto de atenção |
|---|---|---|---|
| Respostas OpenAI | Respostas com estado mais ferramentas embutidas | Início rápido, ferramentas hospedadas, loops estruturados | Você herda abstrações específicas da plataforma |
| Mensagens Anthropic | Acesso direto ao modelo com contrato de uso de ferramentas explícito | Limites claros de ferramentas e bom controle em loops customizados | Mais tempo de execução é sua responsabilidade a menos que use Agentes Gerenciados |
| vLLM | Servindo auto-hospedado compatível com OpenAI e Anthropic | Inferência auto-hospedada de alto throughput | Trabalho real de infraestrutura e servindo de modelo |
| Ollama | Tempo de execução local simples de modelo e embedding | Desenvolvimento local e pilhas auto-hospedadas pequenas | Não é a mesma classe de sistema de servindo do que um tempo de execução distribuído ajustado |
| llama.cpp | Servidor local leve com rotas compatíveis com provedor | Borda, CPU-first, ambientes restritos | Você faz mais ajuste manual e correspondência de capacidade |
Notas da tabela: A OpenAI documenta Respostas como sua interface avançada para respostas com estado e ferramentas embutidas. A Anthropic documenta a API de Mensagens e o contrato de uso de ferramentas separadamente dos Agentes Gerenciados. O vLLM expõe um servidor compatível com OpenAI mais suporte à API de Mensagens da Anthropic. O Ollama documenta fluxos de trabalho locais de embedding e modelo. O llama.cpp documenta rotas de chat, respostas e embeddings compatíveis com OpenAI, mais completions de chat compatíveis com Anthropic.
| Restrição ou compensação | Viés para gerenciado | Viés para auto-hospedado | Mitigação prática |
|---|---|---|---|
| Latência | Geralmente melhor primeira iteração e menos tarefas locais de ajuste | Pode vencer quando modelo e dados são colocados e mantidos quentes | Use camadas de roteamento, caches quentes e modelos auxiliares menores |
| Custo | Fácil de começar, variável em escala de token | Melhor amortização em utilização estável | Meça o tráfego real antes de otimizar por instinto |
| Privacidade e residência | Mais simples para dados não sensíveis | Controle mais forte para fluxos sensíveis e regulados | Use limites híbridos e mantenha apenas o que deve se mover |
| Consistência | Ferramentas hospedadas ainda têm semânticas de visibilidade em estágios | Pipelines de memória auto-hospedados também estágiam e promovem dados | Defina regras de leitura-apos-escrita explicitamente por camada |
| Escalabilidade | Menos dor de plano de controle | Melhor adaptação para cargas de trabalho estáveis e especializadas | Use loteamento, fila e tenants isolados |
| Depurabilidade | Fácil de perder internos opacos do provedor | Fácil de afundar em complexidade auto-feita | Rastreie cada request e avalie cada rota |
Esta matriz de compensações é uma inferência arquitetural dos documentos oficiais, não um benchmark de fornecedor. A linha de consistência importa mais do que muitos posts de blog admitem: A Pinecone separa caminhos de escrita e leitura, o Hermes congela a memória em prompts de início de sessão e o OpenClaw promove memória durável através de revisão em estágios. Isso significa que “memória atualizada” e “memória visível para a resposta atual” são frequentemente verdades diferentes.
Modos de falha e mitigações
A maioria dos assistentes não falha porque o modelo base é “ruim”. Eles falham porque o sistema ao redor mente para o modelo, o priva do contexto certo, deixa ferramentas derivarem ou torna a depuração impossível.
| Onde quebra | Sintoma típico | Causa usual | Mitigação |
|---|---|---|---|
| Montagem de prompt | Resposta confiante mas fora do alvo | Muito contexto irrelevante, ordenação pobre | Orçamente o contexto, reordene, mantenha fatos-chave perto do topo |
| Recuperação | Tom correto, fatos errados | Chunking ruim, índice obsoleto, filtros fracos | Avalie a recuperação separadamente, adicione filtros de metadados e busca híbrida |
| Limite de ferramenta | Ação errada ou ação duplicada | Esquemas frouxos, retries sem idempotência | Esquemas apertados, chaves de idempotência, portões de aprovação |
| Roteamento | Comportamento inconsistentemente selvagem por request | Roteamento de custo ou latência sem controles de qualidade | Adicione sessões pegajosas e avaliações por rota |
| Memória | Recuperação obsoleta ou envenenada | Escritas demasiado ávidas, revisão fraca, vazamento entre sessões | Separe memória de trabalho e durável, revise promoções |
| Observabilidade | Nenhuma ideia do que aconteceu | Traces ausentes ou sem granularidade de span | Emita spans raiz e sub para recuperação, modelo e chamadas de ferramenta |
| Controle de alucinação | Alegações plausíveis mas não suportadas | Fundamentação fraca ou nenhuma passagem de validação | Validação de docs de referência, verificações de auto-consistência, portões de avaliação |
A base de evidência para esta tabela é ampla mas consistente. Os documentos de ferramentas da Anthropic deixam claro que o uso de ferramentas é um limite de contrato. A OpenAI Guardrails inclui detecção de alucinação contra uma base de conhecimento de referência através da Busca de Arquivo. O SelfCheckGPT mostra que a auto-consistência entre amostras pode ajudar a detectar alegações não suportadas. Os resultados de “Lost in the Middle” e as orientações de contexto da Anthropic reforçam ambos a mesma lição operacional: mais tokens não removem a necessidade de curadoria de contexto.
A pilha de mitigação preferida poderia ser chata e repetitiva: rastrear cada request, versionar prompts, avaliar a recuperação independentemente, manter ferramentas idempotentes e executar avaliações de regressão antes de mudar rotas ou política de memória. Os documentos e repositório de Evals da OpenAI são diretos sobre por quê: sem avaliações, é difícil e demorado entender como mudanças de modelo ou prompt afetam seu caso de uso. Isso se aplica tanto a roteadores e recuperação quanto a prompts.
Leitura adicional
Se você quiser ir mais fundo, aqui estão as fontes primárias mais úteis para manter abertas ao projetar ou revisar uma arquitetura de assistente.
-
OpenAI: Visão Geral de Respostas, Function Calling, Usando Ferramentas, Recuperação, Busca de Arquivo, Evals e MCP para servidores de ferramentas remotos.
-
Anthropic: Visão Geral da API, Uso de Ferramentas, o contrato de uso de ferramentas, Agentes Gerenciados, Janelas de Contexto e o conector MCP.
-
A MCP em si: a Visão Geral da Arquitetura e a Especificação valem a pena ler diretamente, porque explicam hosts, clientes, servidores, ferramentas, prompts, recursos, transportes e negociação de capacidade com clareza. Para uma comparação prática da MCP com o protocolo Agent2Agent e quando um sistema multi-agente precisa de ambas as camadas, veja A2A vs MCP: Agentes de IA realmente precisam de ambos os protocolos? e para os conceitos da A2A em si — Agent Cards, ciclo de vida de tarefa, mensagens, partes e artefatos — veja O que é o Protocolo A2A? Agent Cards e Tarefas Explicados.
-
Assistentes de fundo e proativos: a camada de ferramentas é apenas uma parte de como assistentes agem. Para como fazer um assistente observar, decidir e agir por conta própria — agendadores, trabalhadores baseados em fila, protocolos de claim, fluxos de trabalho duráveis e polling semântico — veja Agentes de Polling em Assistentes de IA: 11 Padrões de Implementação.
-
Autoridade de decisão: para quais decisões um modelo deve tomar, recomendar ou apenas informar — os cinco papéis de decisão, roteamento baseado em confiança para a menor camada competente e portões de aprovação dimensionados pelo raio de explosão — veja LLMs de Decisão: Quando um Modelo Deve Decidir — e Quando Não Deve.
-
Protocolo A2A e adoção: uma vez que agentes são implantados independentemente e precisam colaborar através de fronteiras de propriedade, a A2A se torna relevante. Para uma visão prática de 2026 de onde a A2A realmente tem tração, as perguntas de segurança que levanta e um framework de decisão para quando adotá-la, veja Protocolo A2A do Google em 2026: Adoção, Hype e Realidade. Quando esses agentes trocam tarefas de longa duração em vez de turnos únicos de chat, Streaming A2A e Tarefas Assíncronas para Fluxos de Trabalho de Agentes de Longa Duração cobre SSE, push e design de input_required no limite do protocolo.
-
Frameworks e roteamento: Visão Geral do LangChain, documentos de aumento de contexto do LlamaIndex, documentos de roteamento do LiteLLM, documentos de observabilidade do LangSmith.
-
Tempos de execução auto-hospedados e sistemas de assistente: vLLM, servidor llama.cpp, embeddings Ollama, documentos e repositório do OpenClaw, documentos e repositório do Hermes.
-
Armazenamento e observabilidade: Pinecone, Weaviate, pgvector, Milvus, OpenTelemetry, OpenLIT.
-
Papers de pesquisa: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Lost in the Middle e SelfCheckGPT.
