
Kanban в Hermes Agent для самохостинговых LLM-воркфлоу
Управляйте нагрузкой Hermes Kanban на вашем собственном LLM.
Hermes Agent поставляется с доской в стиле Kanban и Hermes Gateway, который может перегрузить вашу самохостинговую LLM, если одновременно будет поставлено слишком много задач.
Могу сказать, что таким образом вы легко можете «задохнуть» (DDoS) собственную LLM.
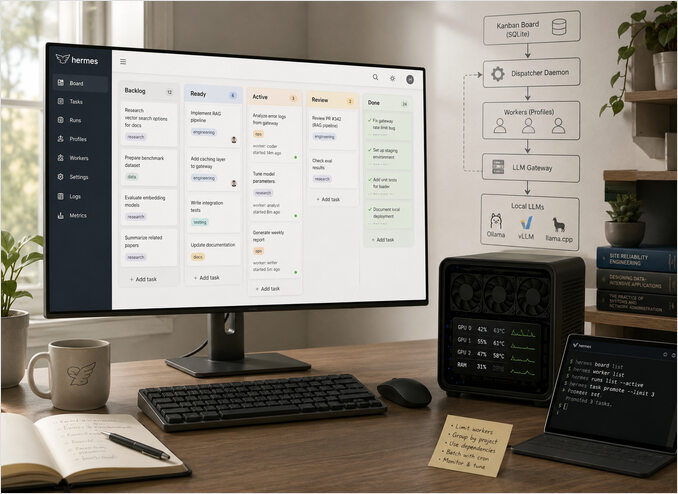
Hermes Kanban — это устойчивая многопрофильная доска, основанная на ~/.hermes/kanban.db.
Каждая дорожка представляет собой этап работы, а каждая карточка — задача, которую может забрать конкретный профиль Hermes.
По умолчанию диспетчер может продвигать множество задач со статусом ready за один проход. Для эластичных облачных API это нормально, но небольшой самохостинговый GPU-кластер может оказаться перегружен.
Если вы только знакомитесь с этим стеком, начните с более обширного Руководства по настройке и эксплуатации Hermes и Раздела о системах ИИ, чтобы понять общую архитектуру.
В этой статье показано, как:
- Понять, как диспетчеризация в Hermes Kanban взаимодействует с вашим LLM-гейтвеем.
- Контролировать параллелизм безопасно для ресурсоемких задач.
- Группировать продвижение задач с помощью cron, чтобы фоновые задания не конфликтовали с интерактивным использованием.
- Мониторить и настраивать систему, чтобы GPU были загружены, но без перегрузок.
Как работают Hermes Kanban и диспетчер
На высоком уровне система состоит из трех слоев:
- Доска — устойчивое SQLite-состояние для задач, колонок, связей и истории.
- Воркеры — профили Hermes, запущенные в изолированных рабочих пространствах для обработки задач.
- Диспетчер — долгоживущий процесс, который сканирует доступные для диспетчеризации карточки и запускает исполняемые среды.
Задачи, созданные из CLI или дашборда, обычно начинают со статусов backlog или ready. Субкоманды hermes kanban, используемые ниже, описаны в Шпаргалке по CLI Hermes Agent.
Диспетчер сканирует подходящие карточки, атомарно забирает одну и запускает назначенный профиль с его инструментами и памятью.
Затем каждый воркер обращается к вашему LLM-гейтвею или локальному рантайму (например, к OpenAI-совместимым эндпоинтам, поддерживаемым Ollama, vLLM или llama.cpp). Для выбора вариантов развертывания между этими рантаймами используйте Размещение LLM в 2026 году: сравнение локального, самохостингового и облачного размещения. Если вы настраиваете разветвление запросов непосредственно в Ollama, этот материал хорошо сочетается с Как Ollama обрабатывает параллельные запросы.
Если вы добавите много ресурсоемких задач и не ограничите количество продвижений, ваш гейтвей может быть наводнен одновременными запросами. На хосте с одним GPU или с ограничением по CPU это часто означает очереди, «трейшинг» и таймауты вместо роста производительности.
Практическое ограничение на сегодня
В текущих сборках Hermes, которые используют многие команды, конфигурация диспетчера раскрывает только два ключа диспетчеризации Kanban и не применяет глобальный лимит активных задач из конфигурации:
kanban:
  dispatch_in_gateway: false
  dispatch_interval_seconds: 10
Для управления активными задачами полагайтесь на явный ритм диспетчеризации (hermes kanban dispatch --max ...) плюс моделирование зависимостей.
Известные подводные камни:
- Не запускайте встроенную в gateway диспетчеризацию и
hermes kanban daemon --forceпротив одной и той же доски, иначе могут возникнуть гонки при захвате задач. - Если gateway выключен, задачи со статусом
readyне диспетчеризуются и могут создать всплеск нагрузки позже, когда сервис вернется. - Более длинные интервалы диспетчеризации ощущаются неравномерно, потому что захват задач происходит по тактам.
- Поведение может варьироваться между версиями, так как граничные случаи состояния выполнения и повторного захвата были исправлены со временем.
Быстрая проверка, если поведение кажется неправильным:
# 1) Убедитесь, что активен именно один путь диспетчеризации
pgrep -af "hermes gateway start|hermes kanban daemon"

# 2) Проверьте настроенные ключи диспетчера Kanban
rg "dispatch_in_gateway|dispatch_interval_seconds" ~/.hermes/config.yaml

# 3) Осмотрите форму очереди
hermes kanban list --status ready
hermes kanban list --status running
Ключевые идеи:
- Конфигурация диспетчера связывает
dispatch_in_gatewayиdispatch_interval_seconds. dispatch --maxограничивает количество новых запусков в данном проходе, а не общее количество запущенных задач.- Для небольших самохостинговых кластеров начинайте консервативно и увеличивайте лимиты только после того, как задержка станет стабильной.
При первоначальном развертывании Hermes рядом с вашим LLM-гейтвеем:
- Оставляйте в конфигурации только поддерживаемые ключи диспетчера Kanban.
- Наблюдайте за загрузкой GPU и CPU под реальной нагрузкой очереди.
- Используйте стратегию 1 или стратегию 2 для детерминированного темпа.
Результаты расследования и первопричина
Команда hermes kanban dispatch не читает config.yaml для параметра max_active_tasks.
В файле hermes_cli/kanban.py команда диспетчеризации предоставляет --max как CLI-лимит (по умолчанию None) и передает только args.max в kb.dispatch_once(...). В этом пути нет обращения к конфигурации max_active_tasks. См. исходный код hermes_cli/kanban.py.
Затем в kanban_db.dispatch_once единственным лимитом является max_spawn, с логикой, эквивалентной:
if max_spawn is not None and spawned >= max_spawn:
    break
Там нет проверки уже запущенных задач и нет ссылки на max_active_tasks в этом пути диспетчеризации. См. исходный код hermes_cli/kanban_db.py.
Эффективное поведение:
hermes kanban dispatch
неограниченно для данного прохода (ограничено размером очереди ready).
hermes kanban dispatch --max 2
ограничивает только новые запуски в данном проходе, а не общее количество запущенных задач.
Настроенные параметры конфигурации вокруг диспетчеризации gateway — это kanban.dispatch_in_gateway и kanban.dispatch_interval_seconds.
Таким образом, max_active_tasks игнорируется в этом пути диспетчеризации, так как там не реализован.
Стратегия 1 — Кодирование зависимостей для строго последовательных потоков
Некоторые рабочие процессы должны выполняться строго один за другим — например:
- многошаговые пайплайны данных с общими промежуточными артефактами
- миграции или изменения инфраструктуры
- пакетные задания, которые пишут в один и тот же объектное хранилище или базу данных
Hermes Kanban поддерживает родительско-дочерние зависимости между задачами, так что дочерняя карточка становится доступной для диспетчеризации только после завершения родительской.
Вы можете смоделировать это с помощью небольшого вспомогательного скрипта вокруг Hermes CLI:
#!/usr/bin/env bash

set -euo pipefail

parent_id="$(hermes kanban add \
  --title 'Ingest customer logs for April' \
  --profile 'etl-worker' \
  --column backlog)"

hermes kanban add \
  --title 'Generate April anomaly report' \
  --profile 'analytics-worker' \
  --column backlog \
  --parent "${parent_id}"

hermes kanban add \
  --title 'Publish April summary to dashboard' \
  --profile 'reporting-worker' \
  --column backlog \
  --parent "${parent_id}"
При правильной политике доски и низких лимитах диспетчера сначала выполняется только родительская задача. После её завершения дочерние задачи постепенно становятся готовыми, и диспетчер забирает их по одной, не превышая ваших лимитов параллелизма.
Стратегия 2 — Использование Linux cron с лимитом диспетчеризации с учетом запущенных задач
Если вы хотите детерминированного темпа, используйте cron на хосте плюс небольшой обертывающий скрипт.
Вместо того, чтобы всегда вызывать dispatch --max 2, сначала подсчитайте текущее количество запущенных задач, а затем диспетчеризируйте только оставшиеся слоты.
Создайте hermes-kanban-dispatch-capped.sh:
#!/usr/bin/env bash
set -euo pipefail

MAX_PARALLEL="${MAX_PARALLEL:-2}"
BOARD="${BOARD:-}"

board_args=()
if [[ -n "$BOARD" ]]; then
  board_args=(--board "$BOARD")
fi

# или там, где установлен ваш hermes
export PATH="/home/abc/.local/bin:$PATH"

running_out="$(hermes kanban "${board_args[@]}" list --status running)"

if [[ "$running_out" == *"(no matching tasks)"* ]]; then
  running_count=0
else
  running_count="$(printf '%s\n' "$running_out" | wc -l)"
fi

slots=$(( MAX_PARALLEL - running_count ))

if (( slots <= 0 )); then
  echo "Already at limit running=$running_count max=$MAX_PARALLEL dispatch skipped"
  exit 0
fi

echo "running=$running_count max=$MAX_PARALLEL slots=$slots dispatching up to $slots"

hermes kanban "${board_args[@]}" dispatch --max "$slots"
Сделайте его исполняемым:
chmod +x ./hermes-kanban-dispatch-capped.sh
Запустите его с:
MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Для конкретной доски:
BOARD=my-board MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Запланируйте его один раз в минуту с помощью cron:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-capped.sh >> /var/log/hermes/kanban-cron.log 2>&1
Операционные заметки:
- Cron часто имеет минимальный
PATH, поэтому еслиhermesне найден, используйте его полный путь внутри скрипта (например/usr/local/bin/hermes). - Если вы пишете логи в
/var/log/hermes/..., сначала создайте этот каталог и убедитесь, что пользователь cron имеет права на запись.
Пример:
sudo mkdir -p /var/log/hermes
sudo chown "$USER":"$USER" /var/log/hermes
Создайте или отредактируйте записи cron с помощью:
crontab -e
Затем проверьте с:
crontab -l
Частота менее минуты с одной записью cron
Cron тикает один раз в минуту, но вы все равно можете диспетчеризировать чаще, запустив короткий цикл внутри скрипта.
Пример hermes-kanban-dispatch-subminute.sh:
#!/usr/bin/env bash
set -euo pipefail

LOCK_FILE="/tmp/hermes-kanban-dispatch.lock"
RUNS_PER_MINUTE="${RUNS_PER_MINUTE:-4}"    # 4 запуска => каждые 15 секунд
CAP_SCRIPT="${CAP_SCRIPT:-/opt/hermes/scripts/hermes-kanban-dispatch-capped.sh}"

exec 9>"$LOCK_FILE"
flock -n 9 || exit 0

sleep_seconds=$(( 60 / RUNS_PER_MINUTE ))

for ((i=1; i<=RUNS_PER_MINUTE; i++)); do
  "$CAP_SCRIPT"

  if (( i < RUNS_PER_MINUTE )); then
    sleep "$sleep_seconds"
  fi
done
Сделайте его исполняемым:
chmod +x ./hermes-kanban-dispatch-subminute.sh
Запланируйте его один раз в минуту:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-subminute.sh >> /var/log/hermes/kanban-subminute.log 2>&1
Это дает эффективную частоту менее минуты, пока flock предотвращает пересекающиеся запуска.
Почему это работает:
list --status runningдает текущую нагрузку запущенных задач.dispatch --max Nограничивает только новые запуски для данного прохода.- Вычисление
Nкак оставшихся слотов держит общее количество запущенных задач вблизи вашего целевого лимита.
Важное предупреждение: этот лимит работает только для диспетчеризации, выполненной через этот скрипт. Отключите встроенную в gateway диспетчеризацию, иначе она все равно может продвигать задачи независимо:
kanban:
  dispatch_in_gateway: false
Официальная документация описывает возможности обеих команд и отмечает значения по умолчанию для диспетчеризации gateway в руководстве по функциональности Kanban: Документация Hermes Kanban.
Внутренний Cron Hermes
Не используйте его.
Вы действительно хотите, чтобы ваша LLM обрабатывала регулярные промпты вроде Execute in terminal the command /path/hermes-kanban-dispatch-capped.sh, особенно когда она занята полезной работой?
Мониторинг и настройка Hermes Kanban
Какой бы стратегию вы ни выбрали, вы должны мониторить:
- Метрики LLM-гейтвея — частота запросов, задержка, уровень ошибок, пропускная способность токенов.
- Здоровье узла — утилизация GPU, использование VRAM, загрузка CPU и RAM.
- Метрики Hermes — сколько задач в backlog, ready, active и done.
Для базовых метрик и дашбордов для продакшена см. Мониторинг LLM-инференса в продакшене с Prometheus и Grafana и более широкий Центр производительности LLM.
Начинайте с низкой параллельности, затем постепенно повышайте лимиты, наблюдая за:
- ростом задержки при постоянной пропускной способности
- увеличением ошибок таймаута или лимитов частоты
- длинными хвостами, где некоторые задачи остаются активными очень долгое время
Как только вы увидите эти симптомы, откатитесь к предыдущей стабильной конфигурации и оставьте её своей основной.
Когда Kanban — правильный инструмент
Hermes Kanban блестит, когда у вас есть:
- долгоживущие исследовательские или инженерные бэклоги
- многоагентное сотрудничество с именованными профилями
- рабочие процессы, которые должны переживать перезапуски и перезагрузки хоста
- люди, которые хотят дашборд для триажи работы
Если вам нужен только один запуск для создания нескольких временных помощников, встроенные инструменты делегирования задач обычно проще. Как только вам нужна история, дашборды и строгий контроль над тем, как ваши агенты обращаются к самохостинговым LLM, доска Kanban плюс диспетчер — правильная основа.
Несколькими настройками конфигурации и опциональной пакетной обработкой на основе cron вы можете сохранять Hermes Kanban отзывчивым, защищая свой гейтвей и оборудование.
Для более широкого взгляда на то, как фоновые воркеры в стиле Hermes вписываются в архитектуры продакшен ИИ-ассистентов — включая планировщики, опрос на основе очередей, протоколы захвата, устойчивые рабочие процессы и семантическую оценку — см. Опрос агентов в ИИ-ассистентах: 11 паттернов реализации. Когда нескольким именованным профилям или специализированным агентам нужно координироваться за пределами простой диспетчеризации задач, Паттерны оркестрации мультиагентных систем описывает топологии координации — хаб-спoke, fan-out, рой — которые лежат в основе крупных мультиагентных установок на самохостинговой инфраструктуре.
