Ollama

Ретроспективная память для агента Hermes: локальная память с использованием локальных LLM

Ретроспективная память для агента Hermes: локальная память с использованием локальных LLM

Персистентная память Hermes на вашем собственном оборудовании.

Самостоятельный ИИ-агент нуждается не только в большом окне контекста. Ему необходим механизм сохранения полезных фактов, извлечения принятых ранее решений и пересмотра своих знаний по мере эволюции проектов.
Сравнение SEO-плагинов для WordPress: от Yoast до Local AI

Сравнение SEO-плагинов для WordPress: от Yoast до Local AI

Плагины SEO для WordPress: от Yoast к локальному ИИ

Плагины SEO для WordPress добавляют метаданные, карты сайта, схему и AI-слой поверх ядра WordPress, и в 2026 году этот слой включает плагины, выполняющие инференс на вашем собственном оборудовании.

Самостоятельно хостируемые SEO-инструменты и платформы: руководство по open source

Самостоятельно хостируемые SEO-инструменты и платформы: руководство по open source

Открытый код для SEO за пределами плагинов WordPress

Самообслуживаемый SEO теперь охватывает пауки, дашборды Search Console, трекеры позиций, MCP-серверы и локальный ИИ. В этом руководстве сравниваются основные платформы с открытым исходным кодом и то, какие функции работают без платных SEO API.

Самохостинговые системы глубокого исследования: сравнение 12 инструментов

Самохостинговые системы глубокого исследования: сравнение 12 инструментов

Самостоятельно размещаемые агенты, способные к исследованиям за пределами поиска

Deep Research стал самостоятельной категорией программного обеспечения, а не просто моделью, связанной с поисковой строкой. Эта статья сравнивает двенадцать систем для самостоятельного развёртывания (self-hosted) и архитектуры исследований, лежащих в их основе.

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

«Когда llama-server превосходит Ollama»

Ollama и llama.cpp часто сравнивают, будто бы это конкурирующие движки вывода. Настоящий выбор — между управляемым сервисом моделей и набором инструментов, которым вы управляете напрямую.

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

Выберите правильный AMD-бэкенд для каждого движка

ROCm и Vulkan обе ускоряют работу GPU AMD для локального размещения LLM, но они не взаимозаменяемы. Правильный выбор зависит от движка, графического процессора и характера нагрузки.

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

Почему контекст 128K не работает на 16 ГБ

Модель может заявлять о поддержке контекстного окна в 128K, но проваливаться уже на 40K токенах на видеокарте с 16 ГБ. Архитектурный потолок никогда не обещал, что веса, KV-кэш, вычислительные буферы и системный композитор смогут одновременно уместиться на вашем устройстве.

Гравитация данных: реальная стоимость API-first ИИ

Гравитация данных: реальная стоимость API-first ИИ

«Почему ваш AI-стек становится всё более «липким» каждый месяц»

Каждый вызов API кажется простой транзакцией - пока их накопится достаточно много, и ваши данные для дообучения, системы оценки и схемы инструментов не начнут формироваться вокруг одного вендора, после чего смена провайдера перестанет быть простой сменой маршрутизации.

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Когда переходить с Ollama на vLLM

Ollama — один из самых простых способов запуска локальной языковой модели, но удобство может скрывать момент, когда локальный эксперимент превращается в общий сервис инференса, требующий лучшего планирования и наблюдаемости.

Быстрый старт с Vane (Perplexica 2.0) с использованием Ollama и llama.cpp

Быстрый старт с Vane (Perplexica 2.0) с использованием Ollama и llama.cpp

Самохостинговый ИИ-поиск с локальными LLM

Vane — один из наиболее прагматичных проектов в сегменте «AI-поиск со ссылками на источники»: самохостингуемый движок ответов, который сочетает живой веб-поиск с локальными или облачными LLM, сохраняя при этом полный контроль над всем стеком за вами.

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Доступ к Ollama удаленно без открытых публичных портов

Ollama чувствует себя наиболее комфортно, когда с ним обращаются как с локальным демоном: CLI и ваши приложения взаимодействуют с локальным HTTP-интерфейсом (loopback), а остальная сеть даже не знает о его существовании.

Ollama в Docker Compose с поддержкой GPU и постоянным хранением моделей

Ollama в Docker Compose с поддержкой GPU и постоянным хранением моделей

Сервер Ollama с приоритетом композиции, поддержкой GPU и сохранением данных.

Ollama отлично работает на «голом железе». Всё становится ещё интереснее, когда вы начинаете относиться к нему как к сервису: стабильный эндпоинт, закреплённые версии, постоянное хранилище данных и GPU, который либо доступен, либо нет.

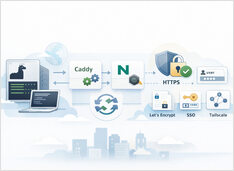
Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

HTTPS для Ollama без нарушения потоковой передачи ответов.

Запуск Ollama через обратный прокси — самый простой способ обеспечить поддержку HTTPS, опциональный контроль доступа и предсказуемое поведение потоковой передачи данных.

Векторные представления текста для RAG и поиска — Python, Ollama, совместимые с API OpenAI

Векторные представления текста для RAG и поиска — Python, Ollama, совместимые с API OpenAI

Встраивания для RAG — Python, Ollama, API OpenAI.

Если вы работаете с генерацией с расширением поиска (RAG), этот раздел объясняет векторные представления текста (эмбеддинги) простым языком: что это такое, как они работают в поиске и извлечении данных, и как вызывать два распространенных локальных режима из Python с помощью Ollama или OpenAI-совместимого HTTP API (так как многие серверы на базе llama.cpp поддерживают такой интерфейс).