API

Ограничение конкурентности в Go: errgroup, пулы воркеров и backpressure

Ограничение конкурентности в Go: errgroup, пулы воркеров и backpressure

Не просто отменяйте работу, а ограничивайте количество задач в обработке.

Безграничный fan-out — это режим отказа по умолчанию в конкурентной среде Go: каждое выражение go добавляет ещё одну задачу в работу, без ограничения по количеству и без ответственного владельца. В этой статье речь о том, как задать и то, и другое.
Веб-фреймворки для Go в 2026 году: сравнение net/http, chi, Gin, Echo и Fiber

Веб-фреймворки для Go в 2026 году: сравнение net/http, chi, Gin, Echo и Fiber

Пять стеков Go HTTP, одна тестовая установка, реальные цифры.

Пакет Go поставляется с HTTP-сервером, готовым к производственной эксплуатации, в своей стандартной библиотеке, а начиная с Go 1.22 встроенный маршрутизатор самостоятельно обрабатывает сопоставление методов и параметры пути. Вопрос о выборе фреймворка не исчез, но сузился.

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

«Когда llama-server превосходит Ollama»

Ollama и llama.cpp часто сравнивают, будто бы это конкурирующие движки вывода. Настоящий выбор — между управляемым сервисом моделей и набором инструментов, которым вы управляете напрямую.

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Когда переходить с Ollama на vLLM

Ollama — один из самых простых способов запуска локальной языковой модели, но удобство может скрывать момент, когда локальный эксперимент превращается в общий сервис инференса, требующий лучшего планирования и наблюдаемости.

Безопасность агентов A2A и MCP: идентификация, делегирование и журналы аудита

Безопасность агентов A2A и MCP: идентификация, делегирование и журналы аудита

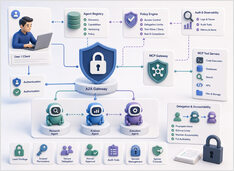
Безопасность протокола определяет, кто может действовать, а не модель.

Инъекция промптов привлекает основное внимание в области безопасности систем на базе больших языковых моделей (LLM), и это заслужено, но это не вся проблема, когда агенты начинают вызывать инструменты и делегировать работу другим агентам.

A2A-стриминг и асинхронные задачи для длительных агентных рабочих процессов

A2A-стриминг и асинхронные задачи для длительных агентных рабочих процессов

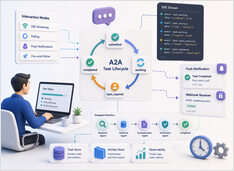
Долгоживущие A2A-задачи продолжают существовать после завершения чат-сессий.

Большинство демонстраций AI-агентов по-прежнему ведут себя как чат-завершения с дополнительными шагами: вы отправляете промпт, ждете несколько секунд и получаете ответ в одном сообщении.

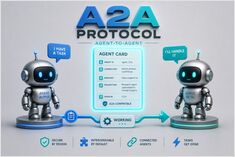
Что такое протокол A2A? Разбираем Agent Cards и Tasks

Что такое протокол A2A? Разбираем Agent Cards и Tasks

A2A превращает агентов в равноправных участников сети.

Протокол A2A (Agent-to-Agent Protocol), аббревиатура от Agent2Agent Protocol, представляет собой открытый стандарт для взаимодействия между независимыми системами ИИ-агентов.

Идемпотентность в распределенных системах, которая действительно работает

Идемпотентность в распределенных системах, которая действительно работает

Избегайте дублирования побочных эффектов

Идемпотентность в распределённых системах — это свойство, которое спасает вас, когда сеть врёт, очередь повторяет отправку, клиент паникует, а оператор нажимает «повтор». В продакшен-системах дублированная доставка — это норма. Дублирование побочных эффектов — это ошибка.

Быстрый старт с Vane (Perplexica 2.0) с использованием Ollama и llama.cpp

Быстрый старт с Vane (Perplexica 2.0) с использованием Ollama и llama.cpp

Самохостинговый ИИ-поиск с локальными LLM

Vane — один из наиболее прагматичных проектов в сегменте «AI-поиск со ссылками на источники»: самохостингуемый движок ответов, который сочетает живой веб-поиск с локальными или облачными LLM, сохраняя при этом полный контроль над всем стеком за вами.

Обзор Opencode: честные результаты, риски биллинга и когда это того стоит

Обзор Opencode: честные результаты, риски биллинга и когда это того стоит

Что происходит на самом деле при запуске Ultrawork.

Oh My Opencode обещает «виртуальную команду AI-разработчиков» — Сизиф координирует специалистов, задачи выполняются параллельно, а волшебное ключевое слово ultrawork активирует всё это.

Быстрый старт с llama.cpp: CLI и сервер

Быстрый старт с llama.cpp: CLI и сервер

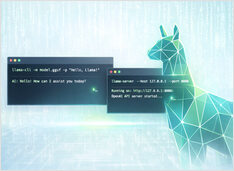
Запуск моделей GGUF в CLI и сервере

llama.cpp — это движок инференса на C/C++ для моделей в формате GGUF: llama-cli для интерактивного чата, llama-completion для скриптованных промптов и llama-server для HTTP API, совместимого с OpenAI.

Airtable для разработчиков и DevOps — тарифные планы, API, вебхуки и примеры на Go/Python

Airtable для разработчиков и DevOps — тарифные планы, API, вебхуки и примеры на Go/Python

Airtable — ограничения бесплатного плана, API, вебхуки, Go и Python.

Airtable лучше всего рассматривать как платформу для создания приложений с низким уровнем кода, построенную вокруг совместного “базоподобного” интерфейса таблиц - отличное решение для быстрого создания операционных инструментов (внутренние трекеры, легковесные CRM, контентные конвейеры, очереди оценки ИИ), где неразработчикам нужен дружелюбный интерфейс, а разработчикам - API для автоматизации и интеграции.