Llm

Qwen 4 уже близко: что подтверждено и что это значит для локального ИИ

Qwen 4 уже близко: что подтверждено и что это значит для локального ИИ

Qwen 4: подтверждённые факты, лестница 27B, локальное соответствие.

Alibaba подтвердила на конференции Apsara, что Qwen 4 находится в процессе обучения, без указания конкретных дат, хотя сигналы от сообщества указывают на запуск в течение нескольких недель, а не месяцев.
Иерархия контекста: система уровней знаний для ИИ-агентов

Иерархия контекста: система уровней знаний для ИИ-агентов

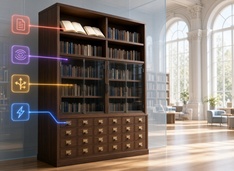
Пятиуровневая иерархия знаний для памяти агента.

Агент с одним плоским файлом памяти не забывает вещи; он не может перестать помнить то, о чём его не просили. Решение — это иерархический контекст, где каждый слой знаний входит через собственный триггер.

Популярные open-source проекты в области ИИ на GitHub в октябре 2026 года

Популярные open-source проекты в области ИИ на GitHub в октябре 2026 года

Открытый исходный код ИИ, сгруппированный по задачам

Ежемесячная страница трендов GitHub работает для конкретного языка, потому что фильтр по языку уже определяет набор проектов. С открытым ИИ вопрос ставится иначе: работа охватывает пять языков, и полезным критерием отбора является функция, которую выполняет репозиторий.

Ретроспективная память для агента Hermes: локальная память с использованием локальных LLM

Ретроспективная память для агента Hermes: локальная память с использованием локальных LLM

Персистентная память Hermes на вашем собственном оборудовании.

Самостоятельный ИИ-агент нуждается не только в большом окне контекста. Ему необходим механизм сохранения полезных фактов, извлечения принятых ранее решений и пересмотра своих знаний по мере эволюции проектов.

gstack: стек искусственного интеллекта для разработки ПО

gstack: стек искусственного интеллекта для разработки ПО

«Софтверная фабрика, созданная на основе навыков агентов»

ИИ-агенты для программирования уже способны писать функции, модифицировать репозитории, запускать тесты и создавать pull request’ы. Более сложная задача — заставить агента следовать повторяемому инженерному процессу до, во время и после написания кода.

Самохостинговые системы глубокого исследования: сравнение 12 инструментов

Самохостинговые системы глубокого исследования: сравнение 12 инструментов

Самостоятельно размещаемые агенты, способные к исследованиям за пределами поиска

Deep Research стал самостоятельной категорией программного обеспечения, а не просто моделью, связанной с поисковой строкой. Эта статья сравнивает двенадцать систем для самостоятельного развёртывания (self-hosted) и архитектуры исследований, лежащих в их основе.

Эффективный фронтенд открытых моделей: поиск оптимального баланса в 2026 году

Эффективный фронтенд открытых моделей: поиск оптимального баланса в 2026 году

«Оптимальный размер открытых LLM в 2026 году: около 30 млрд параметров».

В сентябре 2026 года эффективная граница открытых моделей находится в диапазоне от 25 до 34 миллиардов параметров: агентская работа уровня, близкого к передовому, на одном GPU с 24 ГБ памяти, за малую долю стоимости оборудования класса 70B.

Мнемозина для агента Гермеса: быстрое начало работы с локальной памятью

Мнемозина для агента Гермеса: быстрое начало работы с локальной памятью

Локальная память Hermes с контролируемой записью.

Mnemosyne — это локальный провайдер памяти для Hermes Agent, хранящий рабочую память, структурированные факты, временные данные и эпизодическую историю в локальной базе SQLite — без хостинг-сервисов, без обязательных сетевых вызовов и с необычно гранулярным контролем над записью.

Самовосстанавливающиеся циклы памяти в ИИ-агентах: причины и решения

Самовосстанавливающиеся циклы памяти в ИИ-агентах: причины и решения

«Когда запомненные выводы становятся новым доказательством»

Персистентная память превращает агента из инструмента, которому каждый раз приходится объяснять контекст, в систему, способную нести этот контекст вперёд. Однако она открывает режим отказа, которого избегают безсостояние чаты: интерпретация может стать памятью, извлекаться как факт и обосновывать более сильную версию самой себя.

OpenSpec: Отклонённые предложения — конвенция о памяти решений

OpenSpec: Отклонённые предложения — конвенция о памяти решений

Нет состояния отклонения. Вот обходной путь.

Агент, который полгода назад предложил и внедрил «перенос персистентности в общую библиотеку», с удовольствием предложит то же самое в следующем квартале, если только что-то долговечное не сообщит ему, что эта идея уже была исследована и отклонена — а в OpenSpec сегодня нет встроенного состояния для этого.

OpenSpec: быстрая установка, рабочий процесс и частые ошибки

OpenSpec: быстрая установка, рабочий процесс и частые ошибки

Спецификации в виде дельт, а не 40-страничный PRD.

OpenSpec — это бесплатный инструмент командной строки с открытым исходным кодом от Fission AI, который позволяет вам и вашему ИИ-агенту по разработке кода согласовать изменения в формате простого Markdown до начала написания кода, без жесткой фазовой структуры, характерной для более тяжелых спецификационных фреймворков.

Как безопасно выполнить миграцию с OpenClaw на Hermes Agent

Как безопасно выполнить миграцию с OpenClaw на Hermes Agent

Безопасный перевод, выходящий за рамки однострочного импорта

Миграция ИИ-ассистента — это не то же самое, что копирование конфигурации приложения. Сложная часть заключается в сохранении идентичности, памяти, поведения инструментов, запланированных задач и доступа к сообщениям без возникновения ситуации, когда два шлюза (gateway) работают как один и тот же бот.

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

«Когда llama-server превосходит Ollama»

Ollama и llama.cpp часто сравнивают, будто бы это конкурирующие движки вывода. Настоящий выбор — между управляемым сервисом моделей и набором инструментов, которым вы управляете напрямую.

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

Выберите правильный AMD-бэкенд для каждого движка

ROCm и Vulkan обе ускоряют работу GPU AMD для локального размещения LLM, но они не взаимозаменяемы. Правильный выбор зависит от движка, графического процессора и характера нагрузки.

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

Почему контекст 128K не работает на 16 ГБ

Модель может заявлять о поддержке контекстного окна в 128K, но проваливаться уже на 40K токенах на видеокарте с 16 ГБ. Архитектурный потолок никогда не обещал, что веса, KV-кэш, вычислительные буферы и системный композитор смогут одновременно уместиться на вашем устройстве.