
Оптимизация затрат в системах LLM: куда реально уходят деньги
Тратьте токены там, где это действительно важно.
Стоимость LLM растёт линейно в зависимости от объёма использования. Система, обрабатывающая 10 000 запросов в день по цене 0,01 долл. за запрос, обходится в 100 долл. ежедневно — 365 долл. в год. В масштабах предприятия это превышает 10 000 долл.
Оптимизация расходов — это не про экономию любой ценой. Это про то, чтобы тратить токены там, где это действительно важно.
Каждый потраченный впустую токен — это токен, который можно было бы потратить на более качественный ответ.
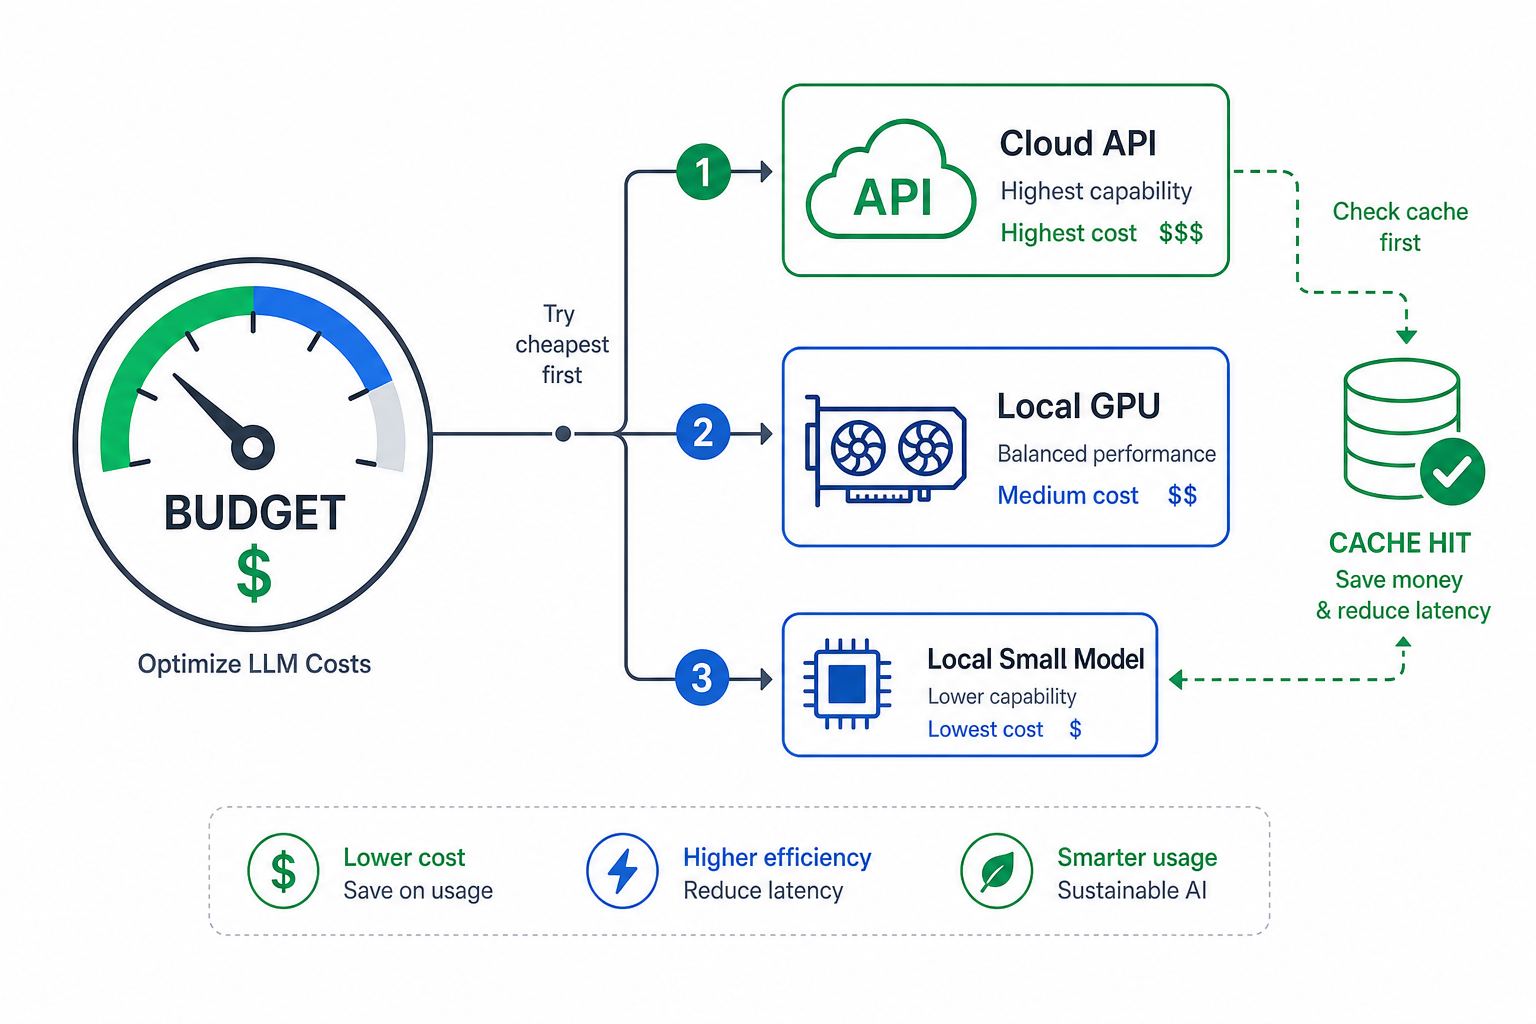
Бюджетирование токенов
Самый простой способ контролировать расходы — установить лимиты. На сессию, на задачу или на день.
Стратегия 1: Бюджет на сессию
Бюджеты на сессию просты в реализации:
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
Стратегия 2: Бюджет на задачу
Бюджеты на задачу полезнее. Разным задачам требуется разное количество контекста:
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
Стратегия 3: Адаптивные бюджеты
Адаптивные бюджеты подстраиваются под фактическое использование. Если задачи классификации постоянно используют 80 токенов, переставайте выделять 100:
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
Экспоненциальное скользящее среднее (с весом 0.9) означает, что недавнее использование учитывается сильнее, чем история. Настройте вес в зависимости от волатильности ваших нагрузок.
API против локального инференса
Локальный инференс дешевле при больших масштабах. Точка безубыточности зависит от вашего оборудования и тарифов API.
| Модель | API ($/M токенов) | Стоимость локально/час | Точка безубыточности |
|---|---|---|---|
| GPT-4o | $2.50 / $10.00 | — | Н/Д |
| Claude Sonnet 4 | $3.00 / $15.00 | — | Н/Д |
| Qwen2.5-72B | $0.50 / $2.00 | ~$0.50 | ~4 часа/день |
| qwen3-32b | $0.30 / $1.20 | ~$0.20 | ~2 часа/день |
| qwen3-8b | $0.10 / $0.40 | ~$0.05 | ~1 час/день |
Расчеты по оборудованию:
| Оборудование | Первоначальные затраты | Ежемесячное электричество | Точка безубыточности по сравнению с API |
|---|---|---|---|
| RTX 3090 (б/у) | $600 | $15 | ~4 месяца |
| RTX 4090 | $1,500 | $20 | ~6 месяцев |
| RTX 5080 | $1,000 | $18 | ~5 месяцев |
| DGX Spark | $2,000 | $30 | ~8 месяцев |
При умеренном использовании — час или больше в день — локальный инференс окупается. При высоких нагрузках экономия становится значительной. Подвох заключается в первоначальных капитальных затратах. RTX 5080 стоит 1 000 долл. Счет за API можно приостановить. Оборудование — нельзя.
Данные расчеты точки безубыточности предполагают, что вы свободны в выборе, что часто является большим неизвестным, чем стоимость самого оборудования. Если ваши данные для дообучения, системы оценки и схемы инструментов уже построены вокруг API одного провайдера, реальной стоимостью миграции станет инженерное время, необходимое для разрыва этой зависимости, а не цена GPU. Data Gravity: The Real Cost of API-First AI рассматривает этот механизм лок-ина и предоставляет чек-лист для оценки, насколько глубоко вы уже в нем погружены, прежде чем вы будете проводить эти расчеты.
Стратегии отката (Fallback)
Когда ваша предпочтительная модель слишком дорога или слишком медленная, используйте более дешевую альтернативу. Ключевое — знать, когда качество является «достаточно хорошим».
Стратегия 1: Откат на основе качества
Откат на основе качества пробует модели, пока результат не достигнет порога:
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
Проблема заключается в самой оценке. Как измерить качество, не вызывая другую модель? Некоторые системы используют небольшой классификатор. Другие используют эвристические проверки — длину, структуру, наличие ключевых слов. Ни один из этих подходов не идеален.
Стратегия 2: Откат на основе задержки
Откат на основе задержки проще. Направляйте запрос к самой быстрой модели, которая соответствует вашему временному бюджету:
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
Кэширование
Кэширование — это самая недооцененная оптимизация затрат. Одинаковые промпты происходят чаще, чем вы думаете — запросы на классификацию, вопросы в стиле FAQ, повторяющиеся вызовы инструментов.
Стратегия 1: Кэширование промптов
Точное кэширование промптов просто:
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
Стратегия 2: Семантическое кэширование
Семантическое кэширование полезнее. Оно ловит промпты, которые различаются, но означают одно и то же:
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
Порог имеет значение. 0.95 — агрессивный — совпадают только очень похожие промпты. 0.85 — более снисходительный, но есть риск вернуть неправильные ответы. Измеряйте ваш уровень промахов (miss rate) и настраивайте значение.
Кэширование ответов для распространенных запросов тоже стоит того. Если пользователи снова и снова спрашивают «какая погода» или «который час», кэшируйте паттерн, а не только точный промпт:
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
Это не сложно, но это работает. Распространенные запросы распространены неспроста.
Когда оптимизация помогает
Оптимизация важна, когда вы обрабатываете большие объемы, запускаете смешанные нагрузки или платите за API-услуги, которые накапливаются.
Она не важна, когда вы прототипируете, используете одну модель или обрабатываете малые объемы. Сложность бюджетирования, откатов и кэширования не оправдана для системы, которая делает 100 запросов в день.
Сначала заставьте базовый процесс работать. Добавьте оптимизацию, когда придут счета.
Компромиссы
| Стратегия | Стоимость | Качество | Сложность |
|---|---|---|---|
| Без оптимизации | Самая высокая | Последовательное | Самая низкая |
| Бюджетирование токенов | Умеренная | Переменное | Средняя |
| Модели отката | Низкая-Средняя | Переменное | Средняя |
| Кэширование | Самая низкая | Высокое (для попаданий в кэш) | Средняя |
| Гибридная | Оптимизированная | Оптимизированная | Самая высокая |
Продакшн-системы обычно используют гибридный подход. Бюджет на сессию, откат по качеству или задержке, кэширование того, что можно. Сложность реальна, но и экономия тоже.
Связанные статьи
- Data Gravity: The Real Cost of API-First AI — почему расчеты точки безубыточности выше — лишь половина решения о self-hosting
- The Efficient Frontier of Open Models in 2026 — экономика размера модели за точкой безубыточности: модель 27B на одном арендованном 4090 против текущих цен токенов Sonnet
- Model Routing Strategies — маршрутизация на основе возможностей, стоимости и задержки
- LLM Guardrails in Practice — валидация ввода, фильтрация вывода, безопасность
- Multi-Model System Design — архитектура для нескольких моделей
- LLM Architecture — столп проектирования систем: маршрутизация, стоимость, защитные ограждения и оркестрация
