
Специализированные АСИКи для LLM и чипы для инференса (почему они важны)
Специализированные интегральные схемы (ASIC) и кастомные чипы повышают скорость и эффективность работы LLM при инференсе.
Будущее ИИ заключается не только в более умных моделях. Оно также связано с кремнием, который соответствует тому, как эти модели фактически обслуживаются. Специализированное оборудование для инференса LLM движется по пути, напоминающему эволюцию майнинга биткоинов от GPU к цельным ASIC-устройствам, хотя ограничения здесь жёстче, поскольку модели и схемы точности продолжают развиваться.
Более подробная информация о пропускной способности, задержках, VRAM и бенчмарках для разных сред выполнения и оборудования доступна в статье Производительность LLM: Бенчмарки, Узкие места и Оптимизация.
 Электрическое воображение — Текст в изображение Flux.
Почему LLM выигрывают от оборудования для инференса
Большие языковые модели изменили ИИ навсегда, но каждый плавный ответ зависит от огромных, предсказуемых потоков матричных вычислений и трафика памяти. По мере роста расходов на инференс — часто превосходящих затраты на обучение на протяжении жизненного цикла модели — чипы, оптимизированные для обслуживания, а не для любых возможных задач, становятся экономически обоснованными.
Аналогия с майнингом биткоинов неидеальна, но поучительна. И то, и другое — повторяющиеся, хорошо ограниченные задачи, где отказ от неиспользуемой универсальности на кристалле может обеспечить значительный прирост пропускной способности и джоулей на полезную операцию.
Что история майнинга биткоинов говорит об инференс-ASIC
Майнинг биткоинов прошёл через четыре поколения:
| Эра | Оборудование | Ключевое преимущество | Ограничение |
|---|---|---|---|
| 2015–2020 | GPU (CUDA, ROCm) | Гибкость | Высокое энергопотребление, ограничение по памяти |
| 2021–2023 | TPU, NPU | Крупнозернистая специализация | Всё ещё ориентированы на обучение |
| 2024–2025 | Трансформерные ASIC | Настроены для низкородового инференса | Ограниченная универсальность |
ИИ следует по похожему пути. Каждый переход улучшал производительность и энергоэффективность на порядки.
Однако, в отличие от биткоин-ASIC (которые вычисляют только SHA-256), инференс-ASIC требуют определённой гибкости. Модели эволюционируют, архитектуры меняются, схемы точности улучшаются. Секрет заключается в специализации достаточной степени — жёстко зашитых основных паттернах при сохранении адаптивности на краях.
Чем инференс LLM отличается от обучения (и что используют чипы)
Нагрузки инференса) выявляют паттерны, которые специализированное оборудование может использовать:
- Доминирование низкой точности — 8-битные, 4-битные, а также тернарная или двоичная арифметика хорошо подходят для инференса
- Память является узким местом — Перемещение весов и KV-кэшей потребляет значительно больше энергии, чем вычисления
- Задержка важнее пропускной способности — Пользователи ожидают токены менее чем за 200 мс
- Массивная параллельность запросов — Тысячи одновременных запросов инференса на один чип
- Предсказуемые паттерны — Слои трансформера высоко структурированы и могут быть жёстко запрограммированы
- Возможности разреженности — Модели всё чаще используют обрезание и методы MoE (Mixture-of-Experts)
Целевой инференс-чип может жёстко записать эти допущения, чтобы достичь на 10–50% лучшей производительности на ватт по сравнению с универсальными GPU.
Кто создаёт кремний, оптимизированный для LLM
Рынок инференс-ASIC охватывает действующих игроков, проекты в масштабе пластин и стартапы, ставящие на кремний, форменный под трансформеры:
| Компания | Чип / Платформа | Специализация |
|---|---|---|
| Groq | LPU (Language Processing Unit) | Детерминированная пропускная способность для LLM |
| Etched AI | Sohu ASIC | Жёстко зашитый движок трансформера |
| Tenstorrent | Grayskull / Blackhole | Универсальный ML с высокопроизводительной сетью |
| Taalas | HC1 (продукт Llama 3.1 8B) / HC2 roadmap | Специфичный для модели «жёсткий» кремний; объединяет память и вычисления |
| OpenAI × Broadcom | Custom Inference Chip | Предположительно запуск в 2026 году |
| Intel | Crescent Island | Только инференс GPU Xe3P с 160GB HBM |
| Cerebras | Wafer-Scale Engine (WSE-3) | Массивная полоса пропускания памяти на кристалле |
Большая часть этого уже эксплуатируется в производственных центрах обработки данных, а не в презентациях. Более мелкие команды, такие как d-Matrix, Rain AI, Mythic и Tenet, также разрабатывают архитектуры, настраиваемые на низкородовой инференс и структурированную разреженность.
Taalas HC1, Chat Jimmy и сверхбыстрое обслуживание малых моделей
Taalas — свежий пример школы «специализируй почти всё». Компания утверждает, что граница между памятью и вычислениями (DRAM вне кристалла против SRAM на кристалле) доминирует над стоимостью, энергопотреблением и инженерной сложностью для инференса, и что кремний на модель — то, что они называют Hardcore Models — может сузить эту границу, если развёртывание готово зафиксировать веса и граф.
Их первый серийный продукт, HC1, жёстко записывает вариант Llama 3.1 8B. Этот выбор прагматичен: модель достаточно мала для быстрого запуска, открыта документация и она всё ещё полезна для многих задач автоматизации, классификации и черновиков, где глубина рассуждения менее важна, чем задержка и стоимость. Taalas сообщает о порядка 16k–17k декодированных токенов в секунду на пользователя для этой конфигурации (методология вендора и сравнения приведены в их обзоре), наряду с заявлениями о значительных выгодах в капитальных затратах и энергопотреблении по сравнению с традиционными стеками GPU для того же класса моделей. Компоненты первого поколения используют агрессивное смешанное низкородовое хранение; компания описывает переход к стандартным 4-битным плавающим форматам в HC2 для восстановления запаса по качеству.
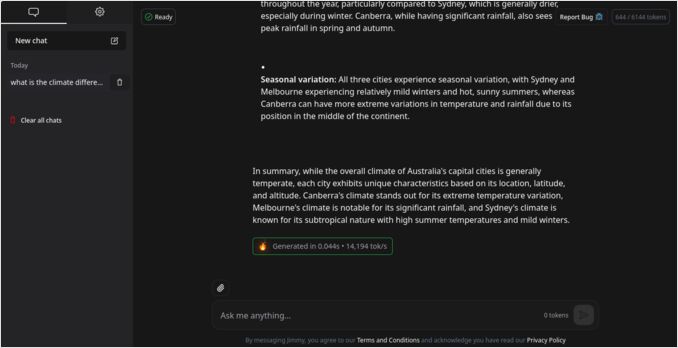
Для разработчиков, желающих ощутить, что означает этот класс пропускной способности на практике, Taalas предлагает бесплатный чат-бот, Chat Jimmy, и предоставляет доступ к API через заявку на их сайте. Это явно доказательство концепции — а не фронтир-ассистент, — но оно иллюстрирует реальную аудиторию, которая может предпочесть скромную модель со «скоростью человеческого мышления» более крупной модели, которая ощущается медленной или дорогой.
Архитектура ASIC для инференса трансформера
Как выглядит оптимизированный для трансформера чип изнутри?
+--------------------------------------+
|         Host Interface               |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  On-chip Interconnect (mesh/ring)    |
+--------------------------------------+
|  Compute Tiles / Cores               |
|   — Dense matrix multiply units      |
|   — Low-precision (int8/int4) ALUs   |
|   — Dequant / Activation units       |
+--------------------------------------+
|  On-chip SRAM & KV cache buffers     |
|   — Hot weights, fused caches        |
+--------------------------------------+
|  Quantization / Dequant Pipelines    |
+--------------------------------------+
|  Scheduler / Controller              |
|   — Static graph execution engine    |
+--------------------------------------+
|  Off-chip DRAM / HBM Interface       |
+--------------------------------------+
Ключевые архитектурные особенности включают:
- Ядра вычислений — Единицы плотного матричного умножения, оптимизированные для операций int8, int4 и тернарных
- On-chip SRAM — Большие буферы хранят горячие веса и KV-кэши, минимизируя дорогостоящие обращения к DRAM
- Потоковые соединения — Топология меш (mesh) обеспечивает эффективное масштабирование на несколько чипов
- Движки квантования — Квантование/декодование в реальном времени между слоями
- Компиляторный стек — Превращает графы PyTorch/ONNX непосредственно в микроспецифичные операции чипа
- Жёстко зашитые ядра внимания — Исключает накладные расходы управления потоком для softmax и других операций
Философия дизайна напоминает биткоин-ASIC: каждый транзистор служит конкретной нагрузке. Нет потраченного зря кремния на функции, не нужные инференсу.
Бенчмарки GPU против ASIC для инференса LLM
Представительные публичные цифры показывают, как специализированное оборудование для инференса может отрываться от универсальных стеков GPU на тех же семействах моделей (всегда проверяйте методологию и предположения о батчинге для своих нагрузок):
| Модель | Оборудование | Пропускная способность (токены/с) | Время до первого токена | Множитель производительности |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1.7с | Базовый (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0.22с | В 3–18 раз быстрее |
| Llama-3.3-70B | Groq LPU | ~276 | ~0.2с | Стабильно 3× |
| Gemma-7B | Groq LPU | 814 | <0.1с | В 5–15 раз быстрее |
| Llama-3.1-8B | Taalas HC1 (вендор) | ~16k–17k декод. т/с/польз | — | Отдельная ось (фикс. 8B граф, не 70B) |
Источники: Groq.com, ArtificialAnalysis.ai, NVIDIA Developer Blog; цифры Taalas HC1 из продуктового поста компании.
Строки, фокусирующиеся на Groq, показывают значительные приросты пропускной способности и времени до первого токена по сравнению с высокопроизводительной базовой линией GPU на больших моделях. Строка Taalas не является другим множителем по отношению к тем 70B строкам; она иллюстрирует, насколько далеко можно продвинуть декодирование на пользователя, когда модель и граф зафиксированы в кремнии, ценой гибкости.
Компромиссы при специализации инференс-кремния
Специализация приносит производительность, но возвращает продуктовые и инженерные риски:
-
Гибкость против эффективности. Полностью фиксированный ASIC с легкостью проходит через сегодняшние модели трансформеров, но может испытывать трудности с завтрашними архитектурами. Что произойдёт, когда механизмы внимания эволюционируют или появятся новые семейства моделей? Это не гипотетика — модели пространственного состояния, диффузионные языковые модели и JEPA мир-модели уже бросают вызов доминированию трансформеров со стороны моделей; см. что последует за LLM для того, куда эти архитектуры могут поместить жёстко зашитый трансформерный кремний.
-
Квантование и точность. Более низкая точность экономит огромные объемы энергии, но управление деградацией точности требует совершенных схем квантования. Не все модели изящно квантуются до 4 бит или ниже.
-
Программная экосистема. Оборудование без надёжных компиляторов, ядер и фреймворков бесполезно. NVIDIA по-прежнему доминирует в основном благодаря зрелой экосистеме CUDA. Новые производители чипов должны heavily инвестировать в программное обеспечение.
-
Стоимость и риск. Вывод чипа на тестирование стоит десятки миллионов долларов и занимает 12–24 месяца. Для стартапов это огромная ставка на архитектурные допущения, которые могут не состояться.
Тем не менее, в гипермасштабе даже 2× выигрыш в эффективности переводится в миллиарды экономии. Для провайдеров облаков выполняющих миллионы запросов инференса в секунду, кастомный кремний становится всё более неотъемлемым.
Список желаемых спецификаций для чипа инференса LLM
| Функция | Идеальная спецификация |
|---|---|
| Техпроцесс | Узел 3–5 нм |
| On-chip SRAM | 100 МБ+ плотно связанных |
| Точность | Нативная поддержка int8 / int4 / тернарной |
| Пропускная способность | 500+ токенов/сек (модель 70B) |
| Задержка | <100 мс время до первого токена |
| Соединения | Низкозадержная меш или оптические линии |
| Компилятор | Тулчейн PyTorch/ONNX → микрокод |
| Энергия | <0.3 джоулей на токен |
Взгляд в будущее (2026–2030)
Ожидается, что ландшафт оборудования для инференса стратифицируется в три грубых слоя:
-
Чипы для обучения. Высокопроизводительные GPU, такие как NVIDIA B200 и AMD Instinct MI400, будут продолжать доминировать в обучении благодаря своей гибкости FP16/FP8 и массивной полосе пропускания памяти.
-
Инференс-ASIC. Жёстко зашитые низкопроизводительные ускорители трансформеров будут обрабатывать производственное обслуживание в гипермасштабе, оптимизированное под стоимость и эффективность.
-
Крайние NPU. Маленькие, сверхэффективные чипы привнесут квантованные LLM в смартфоны, транспорт, устройства IoT и роботов, обеспечивая на устройстве интеллектуальность без зависимости от облака.
Помимо самого оборудования, мы увидим:
- Гибридные кластеры — GPU для гибкого обучения, ASIC (или пластинно-масштабные инференс-движки) для эффективного обслуживания
- Инференс как услуга — Гиперскейлеры смешивают ускорители первой стороны (AWS Inferentia, Google TPU и другие) с GPU
- Коси-дизайн аппаратного и программного обеспечения — Модели, сформированные для блочной разреженности, маршрутизации MoE и слоёв, удобных для квантования
- Кремний на модель или на семейство — Компании вроде Taalas ставят на то, что некоторые развёртывания пожертвуют архитектурной гибкостью ради экстремальной стоимости и задержки на известном графе
- Открытые API инференса — Давление на сохранение переносимости интерфейсов обслуживания, даже когда кремний не переносим
Финальные мысли
«ASIC-изация» инференса ИИ) уже идёт. Подобно тому, как майнинг биткоинов эволюционировал от CPU до специализированного кремния, развёртывание ИИ следует по тому же пути.
Следующая революция в ИИ не будет о больших моделях — она будет о лучших чипах. Оборудование, оптимизированное под специфические паттерны инференса трансформера, определит, кто сможет экономично разворачивать ИИ в масштабе.
Подобно тому, как майнеры биткоинов оптимизировали каждый потраченный ватт, оборудование для инференса выжмет последний FLOP на джоуль. Когда это произойдёт, настоящее прорывное событие будет не в алгоритмах — оно будет в кремнии, который их выполняет.
Будущее ИИ выгравировано в кремнии, транзистор за транзистором.
Для дополнительных бенчмарков, выбора оборудования и настройки производительности смотрите наш хаб Производительность LLM: Бенчмарки, Узкие места и Оптимизация.
Полезные ссылки
- Официальные бенчмарки Groq
- Taalas — Путь к всеобщему ИИ (HC1, дорожная карта, философия)
- Chat Jimmy — демо Llama 3.1 8B от Taalas
- Форма запроса доступа к API Taalas
- Artificial Analysis - Таблица лидеров производительности LLM
- Технический бюллетень NVIDIA H100
- Etched AI - Анонс трансформерного ASIC
- Cerebras Wafer-Scale Engine
- Цены на NVidia RTX 5080 и RTX 5090 в Австралии — октябрь 2025
- Производительность LLM и линии PCIe: ключевые аспекты
- Тест скорости Больших Языковых Моделей
- Сравнение пригодности GPU NVidia для ИИ
- Хорош ли Quadro RTX 5880 Ada 48GB?
