
Arquitectura del asistente de IA: LLM, memoria, herramientas, enrutamiento, observabilidad
Cómo se construyen realmente los asistentes serios.
Un asistente de IA de producción no es “un LLM con un prompt”. Es un sistema que acepta la intención, mantiene el estado, decide cuándo recuperar o actuar, y expone suficiente detalle de tiempo de ejecución para depurar fallos.
Esa visión a nivel de sistema es lo que explora el cluster de Sistemas de IA cuando los asistentes trascienden una única invocación de modelo.
OpenAI describe a los agentes como aplicaciones que planifican, llaman a herramientas, colaboran y mantienen suficiente estado para trabajos multietapa, mientras que Anthropic enmarca el mismo problema como un arnés gestionado que puede ejecutar archivos, comandos, acceso a la web y código de forma segura.
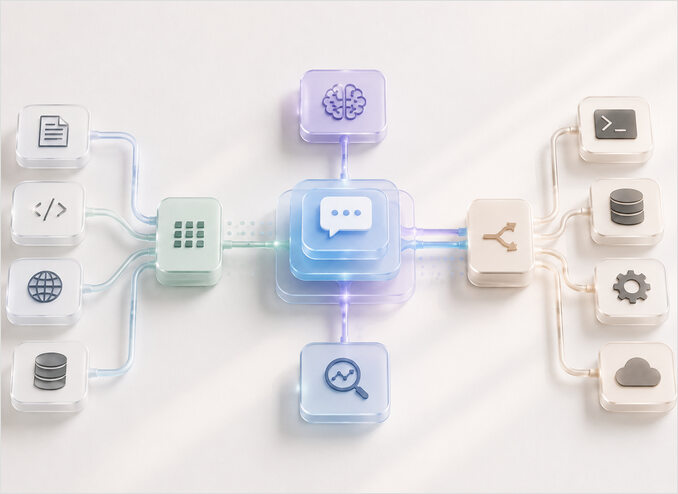
La arquitectura más limpia divide las responsabilidades en cinco capas: LLM, Memoria, Herramientas, Enrutamiento y Observabilidad. Esa división coincide con las capacidades expuestas por las APIs de proveedores principales, por MCP, por tiempos de ejecución autoalojados como vLLM y llama.cpp, y por sistemas de asistentes reales como OpenClaw y Hermes.
La memoria debe tratarse como más que “contexto más largo”. Los sistemas de recuperación convierten el conocimiento externo en memoria no paramétrica explícita, el mismo espacio de diseño cubierto en profundidad por la [Generación Aumentada por Recuperación (RAG)](https://www.glukhov.org/es/rag/ “Tutorial paso a paso de RAG: construye sistemas de generación aumentada por recuperación con bases de datos vectoriales, búsqueda híbrida, reranking y búsqueda web. Arquitectura, implementación y mejores prácticas de producción.”} — y tanto la guía de contexto de Anthropic como el papel “Lost in the Middle” advierten que simplemente meter más tokens en el contexto no garantiza una recuperación fiable.
El uso de herramientas es un límite de contrato, no magia. La invocación de funciones de OpenAI, el uso de herramientas de Anthropic y MCP se basan todos en el mismo patrón: el modelo emite una solicitud estructurada, algún tiempo de ejecución la ejecuta y el resultado fluye de vuelta a la conversación. Si ese límite es perezoso, el asistente se vuelve perezoso.
Mi sesgo es simple: empezar aburrido. Un orquestador, un camino de memoria duradera, una traza por solicitud y una política explícita para la ejecución de herramientas. Los gráficos multiagente son útiles, pero solo después de que puedas explicar los casos de fallo de tu agente único sin adivinar.
Qué es un sistema de asistente de IA
Una definición práctica es esta: un sistema de asistente de IA es un tiempo de ejecución que convierte la intención del usuario en una respuesta o acción combinando una interfaz de modelo, ensamblado de contexto, ejecución de herramientas, gestión de estado y telemetría. Por eso, los documentos útiles no son solo fichas de modelo. Los documentos útiles son referencias de API, contratos de herramientas, guías de recuperación, documentación de enrutamiento y documentación de trazas. La API de Respuestas de OpenAI expone interacciones con estado, herramientas integradas e invocación de funciones. La API de Claude de Anthropic expone acceso directo a Mensajes así como Agentes Gestionados. OpenClaw y Hermes van un paso más allá y muestran qué sucede cuando se colocan esas capacidades detrás de pasarelas persistentes, canales, sesiones y memoria.
En otras palabras, un sistema de asistente tiene un contrato más amplio que una completación de chat. Un buen contrato interno se ve algo así:
SolicitudAsistente  = intención del usuario + identidad + sesión + adjuntos + política
RespuestaAsistente  = respuesta + acciones + citas + cambios de estado + id de traza
Ese contrato importa porque cada desacuerdo de producción se reduce eventualmente a una de estas preguntas: ¿qué contexto era visible, qué herramienta se ejecutó, qué modelo respondió, qué memoria se leyó o escribió y dónde dice la traza que el sistema gastó tiempo? OpenTelemetry define las trazas como el camino de una solicitud a través de una aplicación, que es exactamente la abstracción que necesitan los asistentes serios. LangSmith y OpenLIT luego especializan esa idea para LLMs, herramientas, almacenes vectoriales y flujos de trabajo de agentes.
Componentes principales e interfaces
La división de componentes siguiente es la que considero más duradera. También es la división que mejor se alinea con las APIs oficiales y los tiempos de ejecución de código abierto que la gente realmente opera.
| Capa | Responsabilidad principal | Interfaz típica | Tecnologías de ejemplo |
|---|---|---|---|
| Capa LLM | Razonar, generar, decidir, emitir llamadas estructuradas | API de Respuestas, API de Mensajes, puntos finales compatibles con OpenAI o compatibles con Anthropic | OpenAI, Anthropic, vLLM, llama.cpp, Ollama |
| Capa de Memoria | Mantener estado de sesión, notas duraderas y conocimiento buscable | incrustaciones (embeddings), búsqueda vectorial, herramientas de lectura/escritura de memoria, APIs de recuperación | Incrustaciones y almacenes vectoriales de OpenAI, Pinecone, Weaviate, pgvector, Milvus, memoria de Hermes, memoria de OpenClaw |
| Capa de Herramientas | Leer datos y realizar acciones fuera del modelo | Herramientas de esquema JSON, herramientas MCP, búsqueda de archivos y web, herramientas nativas de tiempo de ejecución | Invocación de funciones de OpenAI, uso de herramientas de Anthropic, MCP, herramientas de LangChain, herramientas de consulta de LlamaIndex |
| Capa de Enrutamiento | Elegir modelo, backend, política y camino de inquilino (tenant) | Alias de modelos, grupos de conmutación por error, comprobaciones de salud, presupuestos, vinculaciones de canal | LiteLLM, enrutamiento multiagente de OpenClaw, resolución de tiempo de ejecución de proveedor de Hermes |
| Observabilidad | Explicar qué sucedió y por qué | Trazas, spans, registros, métricas, ejecuciones de evaluación | OpenTelemetry, LangSmith, OpenLIT |
La tabla anterior se deriva de las interfaces oficiales de los proveedores, MCP, la documentación de bases de datos vectoriales y la documentación de tiempo de ejecución de vLLM, llama.cpp, OpenClaw y Hermes.
La capa LLM debería hacer tres cosas bien: consumir un contexto de trabajo actual, emitir ya sea una respuesta final o una solicitud de acción estructurada, y devolver suficiente metadatos para apoyar reintentos y trazas. La API de Respuestas de OpenAI está diseñada explícitamente para interacciones con estado más herramientas integradas e invocación de funciones. La API de Mensajes de Anthropic expone el mismo bucle central a través de bloques tool_use y devoluciones tool_result, mientras que Agentes Gestionados te da un arnés alojado si no quieres construir el bucle tú mismo. Los tiempos de ejecución autoalojados como vLLM y llama.cpp importan porque preservan interfaces de estilo proveedor familiares mientras te permiten colocar la inferencia dentro de tu propio entorno.
La capa de Memoria debería dividirse mentalmente en tres cubos: memoria de trabajo, memoria simbólica duradera y memoria semántica buscable. Las incrustaciones de OpenAI devienen vectores que pueden indexarse y buscarse; la Recuperación de OpenAI y la Búsqueda de Archivos luego superponen búsqueda semántica y por palabras clave sobre almacenes vectoriales. Pinecone, Weaviate, pgvector y Milvus representan cuatro formas de almacenamiento comunes: totalmente gestionado, vectorial nativo de código abierto, nativo de Postgres y base de datos vectorial distribuida. Hermes y OpenClaw añaden un recordatorio útil de que no toda la memoria pertenece a un almacén vectorial: las notas basadas en archivos, las promociones revisadas y las instantáneas acotadas a la sesión suelen ser el diseño más honesto. Sistemas de Memoria en Asistentes de IA mapea el modelo entre marcos; el Sistema de Memoria del Agente Hermes desgrana la memoria central acotada y las instantáneas de sesión congeladas en un solo producto.
La capa de Herramientas es donde un asistente deja de ser un resumidor y comienza a ser software. La invocación de funciones de OpenAI trata las herramientas como funcionalidad definida por esquema que el modelo puede decidir invocar. Anthropic dice lo mismo de forma más explícita: el uso de herramientas es un contrato entre tu aplicación y el modelo, y el modelo nunca ejecuta nada por su cuenta. MCP generaliza ese contrato en un protocolo cliente-servidor donde los anfitriones se conectan a uno o más servidores que exponen herramientas, prompts y recursos, el mismo límite descrito paso a paso en Servidor MCP en Go. LangChain y LlamaIndex encajan cómodamente aquí como librerías de orquestación: LangChain se enfoca en una arquitectura de agentes preconstruida e integraciones, mientras que LlamaIndex se enfoca en el acceso a datos aumentado por contexto, motores de consulta y flujos de trabajo.
La capa de Enrutamiento existe porque “¿qué modelo?” nunca es la única pregunta. También necesitas “¿qué camino de proveedor, qué inquilino, qué presupuesto, qué clase de latencia y qué conmutación por error?”. LiteLLM es útil porque su documentación oficial es refrescantemente concreta: la selección ponderada, la menos ocupada, la basada en latencia, la basada en coste y las conmutaciones por error acotadas son todos patrones de primera clase. OpenClaw extiende el enrutamiento hacia arriba hacia el aislamiento de canal y agente, mientras que Hermes lo extiende hacia abajo hacia ranuras de modelo para trabajo principal y auxiliar como resumido, compresión de contexto y enrutamiento de herramientas MCP. Ese es el modelo mental correcto: el enrutador elige más que un modelo, elige un carril de ejecución.
La capa de Observabilidad es lo que impide que la arquitectura se convierta en folclore. OpenTelemetry te da la abstracción de traza. LangSmith te da visibilidad de extremo a extremo sobre pasos de aplicaciones LLM y soporta formas de despliegue en la nube, híbridas y autoalojadas. OpenLIT te da observabilidad de IA nativa de OpenTelemetry con opciones de instrumentación de cero código y manual, incluyendo soporte para LLMs, marcos de agentes, bases de datos vectoriales y GPUs. Para métricas de producción, trazas y patrones de SLO a través de flujos de trabajo de inferencia y agentes, ver Observabilidad para Sistemas LLM. Si tu asistente no tiene una traza por solicitud, un span por llamada de modelo y un historial de eventos para la ejecución de herramientas, realmente no tienes una arquitectura aún. Tienes vibraciones.
Capturar, enriquecer, responder
La secuencia que sigue apareciendo en sistemas reales es capturar -> enriquecer -> responder -> registrar. Distintos marcos lo envuelven de manera diferente, pero el flujo es lo suficientemente estable como para tratarlo como la columna vertebral.
El paso de captura suele ser más importante de lo que parece. Tanto OpenClaw como Hermes ponen una pasarela persistente delante del asistente porque el ingreso no es solo entrada de texto. Incluye metadatos de canal, identidades, autorización, límites de sesión, mensajes directos, grupos, ticks de cron y semánticas de entrega. Si omites esa capa y te apoyas en una abstracción de widget de chat crudo, eventualmente la volverás a instalar como middleware ad hoc de todos modos.
El paso de enriquecimiento es donde los sistemas maduros divergen de las demos de juguete. La Recuperación y Búsqueda de Archivos de OpenAI hacen la recuperación explícita a través de almacenes vectoriales y llamadas de búsqueda. LlamaIndex formaliza el mismo patrón a través de conectores de datos, índices, motores de consulta y flujos de trabajo. Hermes va más allá al dividir el patrimonio de modelos en ranuras principales y auxiliares, delegando trabajos como compresión, resumido y enrutamiento a modelos más pequeños o especializados. Ese es un patrón de diseño que vale la pena robar: no gastes tus tokens de modelo más caros en tareas rutinarias.
El paso de responder no es “generar texto”. Es “cerrar el bucle actual”. Si el modelo puede responder directamente, lo hace. Si necesita una herramienta, emite una solicitud estructurada. El contrato de uso de herramientas de Anthropic y la guía de invocación de funciones de OpenAI hacen esto explícito. La razón por la que esto importa arquitectónicamente es que las salidas ahora incluyen tanto lenguaje como flujo de control. Tu objeto de respuesta es en parte prosa y en parte plan de tiempo de ejecución.
El paso de registro es donde aparecen las semánticas de consistencia. Pinecone separa los caminos de escritura y lectura y procesa las escrituras después del reconocimiento duradero. La memoria de Hermes se inyecta como una instantánea congelada por sesión para poder preservar el rendimiento de la caché de prefijo, lo que significa que las nuevas escrituras no aparecen automáticamente en el prompt de la sesión actual. El sistema Dreaming de OpenClaw solo promueve candidatos revisados y fundamentados a MEMORY.md, y es opcional en lugar de siempre activo. La lección práctica es que la memoria rara vez es realmente de lectura-después-de-escritura en todas las capas. Necesitas diseñar para visibilidad escalonada.
OpenClaw y Hermes como sistemas de referencia
OpenClaw y Hermes son casos de referencia útiles porque no son solo envoltorios alrededor de una API de proveedor. Ambos presentan un asistente como un sistema de larga duración con pasarelas, sesiones, herramientas, memoria y múltiples backends de modelo.
| Preocupación arquitectónica | Mapeo de OpenClaw | Mapeo de Hermes |
|---|---|---|
| Ingreso y superficies | Pasarela autoalojada que conecta aplicaciones de chat y superficies de canal | Pasarela de mensajería de fondo única que conecta muchas plataformas externas |
| Orquestación | Plano de control centrado en la pasarela para canales e interacciones de IA | Bucle AIAgent que maneja ensamblado de prompt, selección de proveedor, despacho de herramientas, reintentos y conmutación por error |
| Enrutamiento | El enrutamiento multiagente vincula el tráfico entrante a agentes aislados con espacios de trabajo y sesiones separadas | Las ranuras de modelo principal y auxiliar dividen el razonamiento central de la compresión, el resumido, las aprobaciones y el enrutamiento MCP |
| Memoria | Memoria basada en archivos más memoria activa opcional y promoción de Dreaming en segundo plano | MEMORY.md y USER.md inyectados como una instantánea de sesión congelada, más proveedores de memoria externos |
| Herramientas y extensión | Herramientas integradas, herramientas de sesión, plugins de proveedor, puntos finales personalizados y autoalojados | 40+ herramientas, cliente MCP integrado, conjuntos de herramientas, habilidades y plugins de proveedor de memoria |
Este mapeo se basa en la documentación y repositorios oficiales de OpenClaw y Hermes. OpenClaw documenta una arquitectura de pasarela, enrutamiento multiagente, soporte para proveedores personalizados y autoalojados incluyendo vLLM y Ollama, memoria activa opcional y promoción basada en Dreaming. Hermes documenta una pasarela de mensajería, un bucle central AIAgent, ranuras de modelo principal y auxiliar, memoria integrada e integración MCP nativa.
Mi lectura ligeramente opinada es que ambos sistemas hacen el mismo argumento arquitectónico en acentos diferentes. OpenClaw es fuertemente primero-pasarela. Hermes es fuertemente primero-bucle-de-agente. Pero ambos rechazan la idea superficial de que un asistente es solo “prompt más modelo”. Modelan canales, identidades, semánticas de memoria, superficies de herramientas y heterogeneidad de backend como preocupaciones de primera clase. Eso es exactamente lo que una arquitectura de producción debería hacer.
Una pila híbrida práctica inspirada por ambos sistemas se ve así:
edge:
  gateway: hermes o openclaw

routing:
  proxy: litellm
  policy: consciente de latencia y presupuesto
  tenancy: acotado a sesión y canal

llm:
  primary: respuestas de openai o mensajes de anthropic
  local_fallback: vllm
  local_dev: ollama o llama.cpp

memory:
  session: sqlite o postgres
  semantic: pgvector o weaviate
  embeddings: incrustaciones de openai o incrustaciones de ollama

tools:
  contract: herramientas de esquema json más mcp
  examples: sistema de archivos, navegador, búsqueda web, APIs internas

observability:
  traces: opentelemetry
  ai_dashboards: openlit o langsmith
  evals: evals de openai más conjuntos de regresión específicos de la aplicación
Esa pila es un patrón de despliegue razonado más que un plano prescrito por un vendor. Funciona porque las interfaces oficiales se alinean: OpenAI y Anthropic exponen APIs orientadas a herramientas, vLLM y llama.cpp emulan puntos finales de estilo proveedor, Ollama maneja modelos e incrustaciones locales, MCP estandariza herramientas externas, LiteLLM maneja enrutamiento y conmutación por error, y las plataformas compatibles con OpenTelemetry pueden trazar todo el camino.
Patrones, tablas y compensaciones
Hay unos pocos patrones de asistente repetibles que vale la pena nombrar. Un asistente gestionado mantiene la mayor parte del tiempo de ejecución dentro de las APIs del proveedor. Un asistente primero-recuperación trata la memoria y la búsqueda como el principal diferenciador. Un asistente primero-herramientas se comporta más como un operador que como un chatbot. Un asistente de pasarela prioriza el acceso siempre activo a través de superficies de mensajería. Una malla de especialistas descompone el trabajo en múltiples agentes o rutas. La documentación oficial de OpenAI, Anthropic, LlamaIndex, LiteLLM, OpenClaw y Hermes apoya todas las versiones de estos patrones, incluso si los nombran de manera diferente.
| Patrón | Para qué optimiza | Mejor caso de uso | Coste oculto |
|---|---|---|---|
| Asistente gestionado | Velocidad de entrega | Copilotos internos y bots de soporte | Bloqueo del proveedor y menos control sobre los detalles del tiempo de ejecución |
| Asistente primero-recuperación | Respuestas fundamentadas sobre datos propios | Documentación, soporte, trabajo de conocimiento | La calidad de la recuperación se convierte en el producto real |
| Asistente primero-herramientas | Acción sobre conversación | Flujos de trabajo de operaciones, extracciones de datos, automatizaciones | Los efectos secundarios, reintentos y aprobaciones se convierten en preocupaciones centrales |
| Asistente de pasarela | Acceso ubicuo | Asistentes personales y de equipo a través de superficies de chat | Complejidad de identidad, sesión y seguridad |
| Malla de especialistas | División del trabajo | Flujos de trabajo complejos con límites de propiedad reales | Depuración, orquestación y diseño de evaluación más difíciles |
El patrón de malla de especialistas crece hasta una disciplina de ingeniería distinta a medida que aumenta el número de agentes. Para los seis patrones de coordinación canónicos — orquestador-trabajador, secuencia pipeline, fan-out, jerárquico, enjambre y malla — con modos de fallo específicos y un marco de decisión de producción, ver Patrones de Orquestación Multiagente.
Esta tabla de patrones es una síntesis de la documentación de proveedores, marcos y sistemas de referencia, más que un reclamo de un solo vendor.
| Forma de opción | Componentes típicos | Fortaleza | Debilidad |
|---|---|---|---|
| Gestionado | Respuestas de OpenAI o Agentes Gestionados de Anthropic, búsqueda de archivos alojada o almacenes vectoriales | Camino más rápido, menos piezas móviles, herramientas alojadas | Menor control sobre el camino de datos y la semántica del tiempo de ejecución |
| Híbrido | API del proveedor más enrutador autoalojado y almacén vectorial | Buen equilibrio entre velocidad y control | Más contratos para mantener |
| Autoalojado | vLLM o llama.cpp o Ollama, MCP, BD vectorial autoalojada, OTel | Fuerte control de privacidad y despliegue | Mayor carga de operaciones, sobrecarga de hardware y ajuste |
Notas de la tabla: la Búsqueda de Archivos alojada de OpenAI es una herramienta gestionada, Anthropic ofrece un arnés gestionado, Pinecone es un servicio vectorial gestionado, mientras que vLLM, llama.cpp, Ollama, pgvector, Weaviate, Milvus, LangSmith autoalojado y OpenLIT soportan operación autogestionada o híbrida en diversos grados.
| Almacén vectorial | Forma | Por qué los equipos lo eligen | Precaución |
|---|---|---|---|
| Pinecone | Servicio vectorial gestionado | Sencillez operativa fuerte y arquitectura gestionada escalable | Dependencia externa y economía de servicio gestionado |
| Weaviate | Base de datos vectorial de código abierto | Vectores más índices invertidos y elecciones de índice flexibles | Más ajuste de clúster que un camino solo alojado |
| pgvector | Extensión de Postgres | Mantener vectores con datos relacionales y pila SQL existente | No es la mejor opción para cada carga de trabajo ANN de gran escala |
| Milvus | Base de datos vectorial distribuida | Escala de propósito construida y ecosistema alrededor de Zilliz Cloud gestionado | Otra base de datos de especialidad para operar |
Notas de la tabla: Pinecone documenta un plano de control gestionado y planos de datos regionales. Weaviate documenta índices vectoriales e invertidos con múltiples tipos de índice vectorial. pgvector añade búsqueda de vecino más cercano exacta y aproximada a Postgres. Milvus se posiciona como una base de datos vectorial de alto rendimiento, escalable y de código abierto, con Zilliz Cloud como la opción gestionada.
| Opción LLM | Estilo de interfaz | Mejor en | Precaución |
|---|---|---|---|
| Respuestas de OpenAI | Respuestas con estado más herramientas integradas | Inicio rápido, herramientas alojadas, bucles estructurados | Heredas abstracciones específicas de la plataforma |
| Mensajes de Anthropic | Acceso directo al modelo con contrato de uso de herramientas explícito | Límites de herramientas claros y buen control en bucles personalizados | Más tiempo de ejecución es tu responsabilidad a menos que uses Agentes Gestionados |
| vLLM | Servidor autoalojado compatible con OpenAI y compatible con Anthropic | Inferencia autoalojada de alto rendimiento | Trabajo real de infraestructura y servicio de modelos |
| Ollama | Tiempo de ejecución simple de modelo e incrustación local | Desarrollo local y pilas autoalojadas pequeñas | No es la misma clase de sistema de servicio que un tiempo de ejecución distribuido ajustado |
| llama.cpp | Servidor local ligero con rutas compatibles con proveedor | Borde, primero-CPU, entornos restringidos | Haces más ajuste manual y coincidencia de capacidades |
Notas de la tabla: OpenAI documenta Respuestas como su interfaz avanzada para respuestas con estado y herramientas integradas. Anthropic documenta la API de Mensajes y el contrato de uso de herramientas por separado de los Agentes Gestionados. vLLM expone un servidor compatible con OpenAI más soporte de la API de Mensajes de Anthropic. Ollama documenta flujos de trabajo de incrustación y modelo locales. llama.cpp documenta rutas de chat, respuestas e incrustaciones compatibles con OpenAI, más finalizaciones de chat compatibles con Anthropic.
| Restricción o compensación | Sesgo hacia gestionado | Sesgo hacia autoalojado | Mitigación práctica |
|---|---|---|---|
| Latencia | A menudo mejor primera iteración y menos tareas de ajuste local | Puede ganar cuando el modelo y los datos están colocados juntos y mantienen calientes | Usar capas de enrutamiento, cachés calientes y modelos auxiliares más pequeños |
| Coste | Fácil de empezar, variable a escala de token | Mejor amortización a utilización constante | Medir tráfico real antes de optimizar por instinto |
| Privacidad y residencia | Más simple para datos no sensibles | Control más fuerte para flujos sensibles y regulados | Usar límites híbridos y mantener solo lo que debe moverse |
| Consistencia | Las herramientas alojadas aún tienen semánticas de visibilidad escalonada | Las tuberías de memoria autoalojadas también escalonan y promueven datos | Definir reglas de lectura-después-de-escritura explícitamente por capa |
| Escalado | Menos dolor de plano de control | Mejor adaptación para cargas de trabajo estables y especializadas | Usar loteo, cola y inquilinos aislados |
| Depurabilidad | Fácil de perderse en internos opacos del proveedor | Fácil de ahogarse en complejidad auto-hecha | Trazar cada solicitud y evaluar cada ruta |
Esta matriz de compensaciones es una inferencia arquitectónica de la documentación oficial, no un benchmark de vendor. La fila de consistencia importa más de lo que muchos artículos de blog admiten: Pinecone separa los caminos de escritura y lectura, Hermes congela la memoria en prompts de inicio de sesión, y OpenClaw promueve la memoria duradera a través de revisión escalonada. Eso significa que “memoria actualizada” y “memoria visible para la respuesta actual” suelen ser verdades diferentes.
Modos de fallo y mitigaciones
La mayoría de los asistentes no fallan porque el modelo base sea “malo”. Fallan porque el sistema circundante miente al modelo, lo deja sin el contexto adecuado, deja que las herramientas se desvíen o hace la depuración imposible.
| Dónde se rompe | Síntoma típico | Causa habitual | Mitigación |
|---|---|---|---|
| Ensamblado de prompt | Respuesta segura pero fuera de objetivo | Demasiado contexto irrelevante, ordenamiento pobre | Presupuestar contexto, rerank, mantener hechos clave cerca de la parte superior |
| Recuperación | Tono correcto, hechos erróneos | Fragmentado malo, índice obsoleto, filtros débiles | Evaluar la recuperación por separado, añadir filtros de metadatos y búsqueda híbrida |
| Límite de herramienta | Acción errónea o acción duplicada | Esquemas flojos, reintentos sin idempotencia | Esquemas ajustados, claves de idempotencia, puertas de aprobación |
| Enrutamiento | Comportamiento salvajemente inconsistente por solicitud | Enrutamiento por coste o latencia sin controles de calidad | Añadir sesiones pegajosas y evaluaciones por ruta |
| Memoria | Recuperación obsoleta o envenenada | Escrituras demasiado ansiosas, revisión débil, fuga entre sesiones | Separar memoria de trabajo y duradera, revisar promociones |
| Observabilidad | Ninguna idea de qué sucedió | Trazas faltantes o sin granularidad de span | Emitir spans raíz y subspans para recuperación, modelo y llamadas de herramientas |
| Control de alucinación | Reclamos plausibles pero sin soporte | Fundamentación débil o sin paso de validación | Validación contra documento de referencia, comprobaciones de autoconsistencia, puertas de evaluación |
La base de evidencia para esta tabla es amplia pero consistente. Los documentos de herramientas de Anthropic dejan claro que el uso de herramientas es un límite de contrato. Las Barreras de OpenAI incluyen detección de alucinaciones contra una base de conocimiento de referencia a través de Búsqueda de Archivos. SelfCheckGPT muestra que la autoconsistencia entre muestras puede ayudar a detectar reclamos sin soporte. Los resultados de “Lost in the Middle” y la guía de contexto de Anthropic refuerzan ambos la misma lección operativa: más tokens no eliminan la necesidad de curaduría de contexto.
La pila de mitigación preferida podría ser aburrida y repetitiva: trazar cada solicitud, versionar prompts, evaluar la recuperación independientemente, mantener las herramientas idempotentes y ejecutar evaluaciones de regresión antes de cambiar rutas o política de memoria. Los documentos y repositorio de Evals de OpenAI son francos sobre por qué: sin evaluaciones, es difícil y consume mucho tiempo entender cómo los cambios de modelo o prompt afectan tu caso de uso. Eso aplica tanto a enrutadores y recuperación como a prompts.
Más lecturas
Si quieres ir más a fondo, estas son las fuentes primarias más útiles para mantener abiertas mientras diseñas o revisas una arquitectura de asistente.
-
OpenAI: Resumen de Respuestas, Invocación de Funciones, Uso de Herramientas, Recuperación, Búsqueda de Archivos, Evals y MCP para servidores remotos de herramientas.
-
Anthropic: Resumen de API, Uso de Herramientas, el contrato de uso de herramientas, Agentes Gestionados, Ventanas de Contexto y el conector MCP.
-
El propio MCP: el Resumen de Arquitectura y la Especificación valen la pena ser leídos directamente, porque explican limpiamente anfitriones, clientes, servidores, herramientas, prompts, recursos, transportes y negociación de capacidades. Para una comparación práctica de MCP con el protocolo Agent2Agent y cuándo un sistema multiagente necesita ambas capas, ver A2A vs MCP: ¿Los Agentes de IA Realmente Necesitan Ambos Protocolos? y para los conceptos mismos de A2A — Tarjetas de Agente, ciclo de vida de tareas, mensajes, partes y artefactos — ver ¿Qué es el Protocolo A2A? Tarjetas de Agente y Tareas Explicadas.
-
Asistentes de fondo y proactivos: la capa de herramientas es solo una parte de cómo actúan los asistentes. Para cómo hacer que un asistente observe, decida y actúe por su cuenta — programadores, trabajadores basados en cola, protocolos de reclamo, flujos de trabajo duraderos y encuestas semánticas — ver Agentes de Encuesta en Asistentes de IA: 11 Patrones de Implementación.
-
Autoridad de decisión: para qué decisiones debería tomar, recomendar o solo informar un modelo — los cinco roles de decisión, enrutamiento basado en confianza hacia la capa más pequeña competente y puertas de aprobación dimensionadas por radio de explosión — ver LLMs de Decisión: Cuando un Modelo Debería Decidir — y Cuando No.
-
Protocolo A2A y adopción: una vez que los agentes están desplegados independientemente y necesitan colaborar a través de límites de propiedad, A2A se vuelve relevante. Para una vista práctica de 2026 de dónde A2A realmente tiene tracción, las preguntas de seguridad que plantea y un marco de decisión para cuándo adoptarlo, ver Protocolo Google A2A en 2026: Adopción, Hype y Realidad. Cuando esos agentes intercambian tareas de larga duración en lugar de giros de chat únicos, Transmisión y Tareas Asíncronas A2A para Flujos de Trabajo de Agente de Larga Duración cubre el diseño de SSE, empuje y input_required en el límite del protocolo.
-
Marcos y enrutamiento: Resumen de LangChain, documentos de aumento de contexto de LlamaIndex, documentos de enrutamiento de LiteLLM, documentos de observabilidad de LangSmith.
-
Tiempos de ejecución autoalojados y sistemas de asistente: vLLM, servidor llama.cpp, incrustaciones de Ollama, documentos y repositorio de OpenClaw, documentos y repositorio de Hermes.
-
Almacenamiento y observabilidad: Pinecone, Weaviate, pgvector, Milvus, OpenTelemetry, OpenLIT.
-
Papeles de investigación: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Lost in the Middle y SelfCheckGPT.
