Nvidia

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

Por qué el contexto de 128K falla con 16 GB

Un modelo puede publicitar una ventana de contexto de 128K y aun así fallar en 40K tokens en una GPU de 16 GB. El límite de la arquitectura nunca prometió que los pesos, la caché KV, los búferes de cálculo y el compositor del escritorio cabrían en tu tarjeta al mismo tiempo.
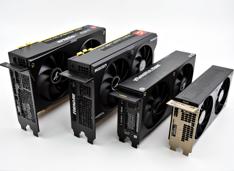
GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

Comparativa de GPUs de IA entre tres proveedores

El panorama del hardware para IA ha cambiado significativamente en 2026, con NVIDIA, AMD e Intel compitiendo por los desarrolladores que necesitan GPUs capaces de ejecutar modelos de lenguaje grandes (LLM) locales y cargas de trabajo de inferencia de IA.

Ollama en Docker Compose con GPU y almacenamiento persistente de modelos

Ollama en Docker Compose con GPU y almacenamiento persistente de modelos

Servidor Ollama con prioridad en composición, GPU y persistencia.

Ollama funciona muy bien en hardware físico (bare metal). Se vuelve aún más interesante cuando lo tratas como un servicio: un punto de conexión estable, versiones fijas, almacenamiento persistente y una GPU que está disponible o no lo está.

Infraestructura de IA en hardware de consumo

Infraestructura de IA en hardware de consumo

Despliegue de IA empresarial en hardware económico con modelos abiertos

La democratización de la IA está aquí. Con modelos de lenguaje de gran tamaño (LLM) de código abierto como Llama, Mistral y Qwen rivalizando ahora con los modelos propietarios, los equipos pueden construir una infraestructura de IA utilizando hardware de consumo, reduciendo drásticamente los costos mientras mantienen el control total sobre la privacidad de los datos y el despliegue.