Privacy

Gravedad de los datos: el verdadero coste de la IA API-first

Gravedad de los datos: el verdadero coste de la IA API-first

Por qué su stack de IA se vuelve más dependiente cada mes.

Cada llamada a la API parece una transacción sencilla, hasta que se acumulan lo suficiente como para que tus datos de ajuste fino, tus entornos de evaluación y tus esquemas de herramientas se adapten a un solo proveedor, momento en el cual cambiar deja de ser un ajuste de enrutamiento.
Inicio rápido de Vane (Perplexica 2.0) con Ollama y llama.cpp

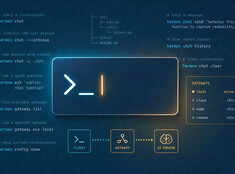
Inicio rápido de Vane (Perplexica 2.0) con Ollama y llama.cpp

Búsqueda de IA autoalojada con LLM locales

Vane es una de las entradas más pragmáticas en el espacio de “búsqueda de IA con citas”: un motor de respuestas autoalojado que combina la recuperación web en vivo con LLM locales o en la nube, manteniendo toda la pila bajo tu control.

Ollama vs. vLLM vs. LM Studio: la mejor forma de ejecutar LLMs localmente en 2026.

Ollama vs. vLLM vs. LM Studio: la mejor forma de ejecutar LLMs localmente en 2026.

Compare las mejores herramientas de alojamiento local de LLM en 2026. Madurez de la API, soporte de hardware, tool calling y casos de uso reales.

Ejecutar LLMs localmente es ahora práctico para desarrolladores, startups e incluso equipos de empresa. Pero elegir la herramienta adecuada — Ollama, vLLM, LM Studio, LocalAI u otras — depende de tus objetivos:

Infraestructura de IA en hardware de consumo

Infraestructura de IA en hardware de consumo

Despliegue de IA empresarial en hardware económico con modelos abiertos

La democratización de la IA está aquí. Con modelos de lenguaje de gran tamaño (LLM) de código abierto como Llama, Mistral y Qwen rivalizando ahora con los modelos propietarios, los equipos pueden construir una infraestructura de IA utilizando hardware de consumo, reduciendo drásticamente los costos mientras mantienen el control total sobre la privacidad de los datos y el despliegue.