AI Coding

Habilidades de agentes vs servidores MCP: marco de decisión

Habilidades de agentes vs servidores MCP: marco de decisión

¿Habilidad, servidor MCP o ambos?

Las habilidades de agentes y los servidores MCP suelen presentarse como formas competidoras de extender un agente de IA. Esa interpretación es incorrecta: una habilidad enseña al agente cómo trabajar, mientras que un servidor MCP le otorga acceso controlado a capacidades en vivo.
Subagentes de Claude Code: configuración, configuración y cuándo usarlos

Subagentes de Claude Code: configuración, configuración y cuándo usarlos

Delega el trabajo ruidoso y mantén tu contexto limpio.

La mayoría de las sesiones de Claude Code se vuelven lentas y desordenadas por la misma razón: cada búsqueda exploratoria con grep, cada volcado de registros y cada “déjame revisar un archivo más” permanece en la conversación principal para siempre.

Mantener especificaciones, pruebas y código sincronizados en el desarrollo de IA

Mantener especificaciones, pruebas y código sincronizados en el desarrollo de IA

Evita que los agentes de IA se desvíen de las especificaciones, las pruebas y el código.

Los agentes de codificación con IA implementan características rápidamente, pero las especificaciones, las pruebas y el código se desvían silenciosamente entre sí. Esta guía cubre un modelo de trazabilidad, el mapeo de especificación a prueba y de especificación a código, y las verificaciones de integración continua (CI) que detectan la desviación antes de una fusión.

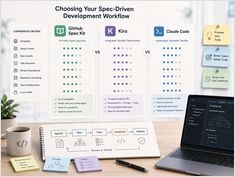
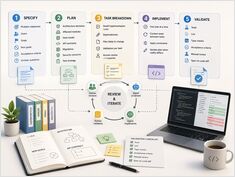
GitHub Spec Kit frente a Kiro frente a los flujos de trabajo SDD de Claude Code

GitHub Spec Kit frente a Kiro frente a los flujos de trabajo SDD de Claude Code

Profundidad del proceso frente a portabilidad, no la mejor herramienta.

Los desarrolladores que comparan configuraciones de Desarrollo Guiado por Especificaciones (SDD) en 2026 generalmente no están preguntando qué modelo es el más inteligente. Están preguntando qué flujo de trabajo mantendrá alineado a un agente de IA sin soterrarlos en ceremonias.

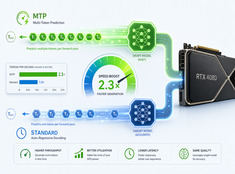
Decodificación especulativa: inferencia de LLM 20-50 % más rápida

Decodificación especulativa: inferencia de LLM 20-50 % más rápida

Inferencia más rápida de LLM sin pérdida de calidad: una guía práctica

Un modelo de 70B genera un token por pasada hacia adelante (forward pass), y cada pasada recarga los pesos desde la VRAM, calcula la atención a través del contexto y sincroniza la memoria. Entre tokens, la GPU se queda inactiva mientras espera a que se resuelvan las dependencias secuenciales.

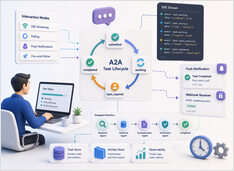
Patrones de Orquestación Multiagente: Una Guía Práctica

Patrones de Orquestación Multiagente: Una Guía Práctica

El 40 % de los pilotos de agentes múltiples fracasan. Aquí te explicamos cómo elegir el patrón de orquestación adecuado y evitar los que fallan.

Los sistemas de IA de agente único alcanzaron su punto máximo en 2025: le dábamos a un LLM un prompt, algunas herramientas y un objetivo, y funcionaba razonablemente bien en tareas acotadas.

Registros de Decisiones para el Desarrollo de Software Impulsado por IA

Registros de Decisiones para el Desarrollo de Software Impulsado por IA

Mantén la intención cerca del código.

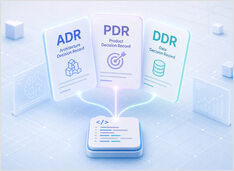
Los registros de decisiones son la capa de memoria faltante en el desarrollo de software asistido por IA. Capturan no solo qué se construyó, sino por qué; y esa distinción se vuelve crítica cuando las herramientas de IA están escribiendo su código.