
Decodificación especulativa: inferencia de LLM 20-50 % más rápida
Inferencia más rápida de LLM sin pérdida de calidad: una guía práctica
Un modelo de 70B genera un token por pasada hacia adelante (forward pass), y cada pasada recarga los pesos desde la VRAM, calcula la atención a través del contexto y sincroniza la memoria. Entre tokens, la GPU se queda inactiva mientras espera a que se resuelvan las dependencias secuenciales.
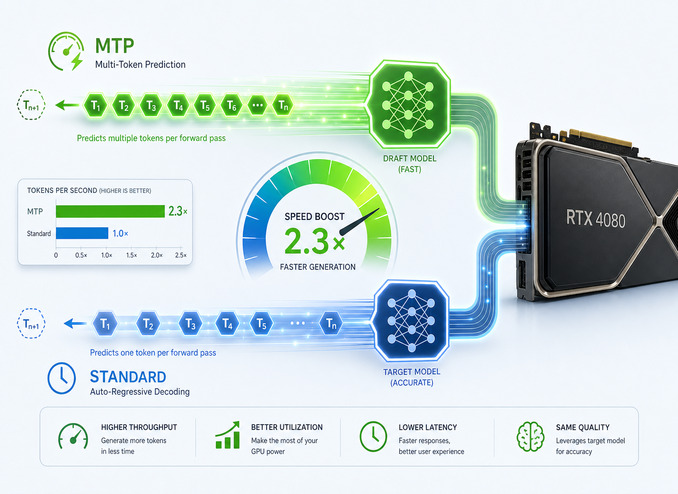
En una H100, un modelo de 70B produce un token cada 30-50 ms. La GPU tiene suficiente capacidad de cómputo para procesar varios tokens en paralelo, pero la dependencia secuencial lo impide: cada token depende del anterior, y la tubería se detiene.
La decodificación especulativa rompe ese cuello de botella al permitirte generar múltiples tokens en el tiempo que normalmente tardarías en generar uno, sin cambiar la distribución de salida. Los tokens que obtienes son estadísticamente idénticos a los que obtendríais con la decodificación autorregresiva estándar; la única diferencia es lo rápido que los obtienes.
Esta guía cubre la mecánica, las variantes disponibles en 2026, los compromisos de tasa de aceptación y la configuración práctica en llama.cpp, vLLM, SGLang y TensorRT-LLM.
Cómo funciona la decodificación autorregresiva (y por qué es lenta)
Antes de poder entender la decodificación especulativa, necesitas entender la restricción autorregresiva que esta rodea. La generación autorregresiva estándar procesa tokens de forma secuencial:
- Ejecuta una pasada hacia adelante a través del modelo con el contexto actual.
- Muestrea el siguiente token de la distribución de salida.
- Añade el token al contexto.
- Repite.
Cada paso requiere una pasada hacia adelante completa: cargar los pesos desde la VRAM, calcular la atención en todo el contexto y producir un único token. Para un modelo con 70B de parámetros, esto toma aproximadamente 30-50 ms por token en una H100. La GPU tiene capacidad de cómputo sobrante; podría procesar más trabajo en paralelo; pero la dependencia secuencial lo impide.
La brecha entre cómputo y VRAM
Las GPUs modernas tienen más FLOPs de los que necesitan para la generación de un solo token, por lo que el verdadero cuello de botella es el ancho de banda de la memoria: los pesos deben transmitirse desde la VRAM a las unidades de cálculo para cada pasada hacia adelante. Al generar un token a la vez, la GPU pasa la mayor parte de su tiempo esperando transferencias de memoria en lugar de realizar cálculos útiles.
La decodificación especulativa aborda esto dándole a la GPU más trabajo por transferencia de memoria. En lugar de un token por pasada hacia adelante, genera K tokens por pasada, amortizando el costo de memoria entre múltiples salidas.
El mecanismo de borrador-verificación
La decodificación especulativa funciona en ciclos repetitivos de borrador-verificación. Un mecanismo de borrador rápido propone K tokens candidatos (desde un modelo de borrador pequeño, una búsqueda de n-gramas o una cabeza de predicción unida al modelo objetivo), y el modelo objetivo verifica todos los K en una sola pasada hacia adelante. La fase de borrador es barata, típicamente el 5-20% del tiempo de la pasada hacia adelante del modelo objetivo, mientras que la comparación verifica cada token borrador contra lo que el objetivo habría generado, aceptando el prefijo coincidente más largo y remuestreando desde el primer rechazo.
Verificar K tokens cuesta aproximadamente lo mismo que generar uno de forma autorregresiva, por lo que, cuando el borrador es correcto, obtienes K tokens al precio de un solo paso de verificación.
Un ejemplo concreto
Supongamos que el modelo de borrador propone 5 tokens: ["I", " like", " cooking", " and", " traveling"]. El modelo objetivo los verifica en una sola pasada hacia adelante:
| Token | Borrador | ¿El objetivo está de acuerdo? |
|---|---|---|
| 1 | “I” | ✓ |
| 2 | " like" | ✓ |
| 3 | " cooking" | ✗ (el objetivo diría " playing") |
| 4 | " and" | — (no evaluado) |
| 5 | " traveling" | — (no evaluado) |
El objetivo acepta los tokens 1 y 2, luego genera " playing" para el token 3, produciendo tres tokens en un solo ciclo en lugar de tres pasadas hacia adelante separadas. Si el borrador hubiera sido correcto hasta el token 5, obtendríais cinco tokens al costo de una verificación: una aceleración de 5x solo en ese ciclo.
El cuello de botella de verificación
En la práctica, la verificación domina el tiempo de ejecución: el 42-95% del ciclo, dependiendo del método y del tamaño del modelo. La pasada hacia adelante del modelo objetivo es el cuello de botella, y los tokens rechazados representan cálculo desperdiciado.
Por eso la tasa de aceptación es tan importante. Cada token rechazado después del primero es trabajo de verificación desperdiciado. Los mejores métodos de decodificación especulativa maximizan los tokens aceptados esperados por ciclo, no solo la tasa de aceptación cruda.
La garantía matemática
Una de las propiedades más importantes de la decodificación especulativa es que produce tokens de la misma distribución exacta que el muestreo autorregresivo estándar desde el modelo objetivo. El paso de verificación utiliza el muestreo por rechazo: cuando el borrador propone el token x, el modelo objetivo calcula su propia probabilidad p(x) y el borrador calcula p_draft(x). La probabilidad de aceptación es:
min(1, p(x) / p_draft(x))
Cuando el objetivo está de acuerdo (p(x) ≥ p_draft(x)), el token siempre se acepta. Cuando el objetivo no está de acuerdo, el token se acepta con una probabilidad proporcional a la razón, y los tokens rechazados se remuestrean de una distribución residual:
r(x) = max(0, p(x) - p_draft(x)) / Σ max(0, p(y) - p_draft(y))
Este procedimiento garantiza que la secuencia de salida siga exactamente la distribución del modelo objetivo, lo que hace que la decodificación especulativa sea sin pérdida. El modelo de borrador influye en la velocidad, no en la calidad: los tokens que obtienes son estadísticamente indistinguibles de la decodificación estándar, con la misma perplejidad y distribución. La única diferencia es la latencia.
Estrategias de modelo de borrador
El mecanismo de borrador es la variable que más importa. Diferentes enfoques tienen diferentes compromisos entre la complejidad de configuración, la tasa de aceptación y la aceleración.
Modelos de borrador independientes
El enfoque más simple carga un modelo más pequeño junto al objetivo, típicamente un modelo de 1B-3B haciendo borrador para un objetivo de 7B-70B.
Ventajas:
- Conceptualmente directo
- Funciona con cualquier modelo objetivo
- El modelo de borrador puede ajustarse para coincidir con la distribución del objetivo
Desventajas:
- Requiere cargar un segundo modelo en la VRAM (1-4 GB dependiendo del tamaño)
- La calidad del modelo de borrador determina directamente la tasa de aceptación
- Los borradores cruzados de familia (p. ej., Qwen haciendo borrador para Llama) generalmente tienen un rendimiento pobre
Regla general: Usar modelos de la misma familia. Gemma 2 2B hace buen borrador para Gemma 2 27B. Llama 3.2 1B hace buen borrador para Llama 3.1 70B. Los borradores cruzados de familia tienden a tener bajas tasas de aceptación porque las distribuciones de tokens se desvían.
Encontrando modelos de borrador compatibles
No todos los modelos pequeños funcionan como modelos de borrador para un objetivo dado. El factor crítico es la alineación de la distribución: qué tan de cerca coinciden las probabilidades de salida del modelo de borrador con las del objetivo.
| Modelo Objetivo | Borrador Recomendado | Coincidencia de Familia |
|---|---|---|
| Llama 3.1 70B | Llama 3.2 1B-3B | Mismo |
| Llama 3.1 8B | Llama 3.2 1B | Mismo |
| Qwen 3 27B | Qwen 3 0.6B-1.8B | Mismo |
| Gemma 2 27B | Gemma 2 2B | Mismo |
| Mixtral 8x7B | Phi-3 4B (entrenado con datos de Mixtral) | Cruzado (cuidado) |
La regla de oro: si la tasa de aceptación del modelo de borrador cae por debajo del 50%, la decodificación especulativa puede en realidad ralentizarte. El sobrecosto de ejecutar el modelo de borrador más la verificación supera el beneficio cuando la mayoría de las propuestas son rechazadas.
EAGLE y EAGLE-3: Cabezales de predicción
EAGLE (Efficient Architecture Guided Language Model Estimation) elimina la necesidad de un modelo de borrador separado. En su lugar, adhiere cabezales de predicción autorregresivos ligeros a las capas internas del modelo objetivo.
Cómo funciona EAGLE
EAGLE entrena cabezales de predicción que toman los estados ocultos de las capas intermedias del modelo objetivo y predicen tokens futuros. Durante la inferencia:
- El modelo objetivo ejecuta una pasada hacia adelante a través de sus capas.
- En cada capa, el cabezal EAGLE lee el estado oculto y propone tokens para posiciones futuras.
- Múltiples cabezales operan en paralelo, cada uno prediciendo un paso temporal futuro diferente.
- El modelo objetivo verifica todas las propuestas en una sola pasada.
La ventaja: los cabezales EAGLE están entrenados específicamente para coincidir con la distribución del modelo objetivo. Ven directamente las representaciones internas del objetivo, lo que les da una alineación mucho mejor que un modelo de borrador independiente.
Mejoras de EAGLE-3
EAGLE-3 (2025) refinan el enfoque con tres cambios clave:
- Selección de capas: En lugar de adherir cabezales a cada capa, EAGLE-3 usa optimización bayesiana para seleccionar la capa de salida óptima, reduciendo el sobrecosto.
- Predicción multi-token: Cada cabezal predice múltiples tokens simultáneamente, aumentando la profundidad del borrador sin un costo de cómputo proporcional.
- Eficiencia de entrenamiento: EAGLE-3 entrena con los propios datos de generación del modelo objetivo, mejorando las tasas de aceptación en cargas de trabajo dentro de la distribución.
Tasas de aceptación: EAGLE-3 típicamente logra tasas de aceptación del 60-80% en cargas de trabajo dentro de la distribución, en comparación con el 40-60% de los modelos de borrador independientes. En cargas de trabajo de generación de código con alta repetición, la aceptación puede superar el 85%.
Configuración: EAGLE-3 requiere cabezales preentrenados para tu modelo objetivo. NVIDIA proporciona cabezales EAGLE-3 para varios modelos populares a través de TensorRT-LLM y la colección Speculative Decoding Modules en HuggingFace. Existen implementaciones de terceros para vLLM y SGLang.
P-EAGLE: Borrado paralelo (marzo de 2026)
La principal limitación de EAGLE-3 es el borrado autorregresivo: cada token de borrador depende del anterior, por lo que generar K tokens de borrador requiere K pasadas hacia adelante secuenciales a través del cabezal de borrador, y el sobrecosto del borrador crece linealmente con K. P-EAGLE elimina este techo generando todos los K tokens de borrador en una sola pasada hacia adelante a través de un borrador ligero de 4 capas entrenado para predecir hasta 10 tokens en paralelo.
El resultado: P-EAGLE entrega una aceleración de hasta 1,69x sobre EAGLE-3 vanilla en cargas de trabajo reales en NVIDIA B200. La ventaja se amplía con valores de K más altos: donde el borrado secuencial de EAGLE-3 se convierte en un cuello de botella, el borrado paralelo de P-EAGLE no incurre en costos adicionales.
Configuración en vLLM: Descarga un cabezal P-EAGLE preentrenado de HuggingFace, configura "parallel_drafting": true en tu configuración de vLLM y usa la misma bandera --speculative-model; vLLM se encarga del resto. P-EAGLE es el estado del arte actual para la decodificación especulativa basada en EAGLE, y si estás implementando EAGLE en 2026, P-EAGLE es la variante a utilizar.
Decodificación especulativa con n-gramas
La decodificación especulativa con n-gramas reemplaza un borrador neural con la coincidencia de patrones contra el historial del prompt. El algoritmo busca secuencias de n-gramas repetidas en el contexto y, cuando la secuencia de tokens actual coincide con un patrón visto anteriormente, propone los tokens que siguieron a ese patrón antes; por ejemplo, si el modelo ya ha generado def calculate_total(items): y vuelve a encontrar def calculate_total(, sabe que los siguientes tokens probablemente serán items): basándose en la ocurrencia anterior.
Las variantes de mapa n-gram (ngram-map-k, ngram-map-k4v) usan tablas hash para búsquedas más rápidas en lugar de escaneo lineal, con la clave hash como el n-grama actual de tamaño N y el valor como la secuencia de tokens que siguió.
Ventajas:
- Cero sobrecosto de VRAM: no hay modelo adicional que cargar (~16 MB para la tabla hash)
- Extremadamente rápido para cargas de trabajo repetitivas (edición de código, refactorización, generación de plantillas)
- Las tasas de aceptación pueden alcanzar más del 90% en cargas de trabajo con alta auto-similitud
Desventajas:
- Inútil para la generación novel: si el patrón no ha aparecido antes, el n-grama no tiene nada que proponer
- La tasa de aceptación cae a casi cero en cargas de trabajo creativas o diversas
- Profundidad de borrador limitada (típicamente 2-4 tokens por coincidencia)
Mejor para: Refactorización de código, llenado de plantillas, documentación repetitiva y cualquier carga de trabajo donde el modelo vuelva a patrones similares. Peor para: escritura creativa, chat abierto y tareas de razonamiento.
Ajuste de parámetros
Los parámetros de n-gramas importan más de lo que esperas. Los valores predeterminados funcionan para código, pero las cargas de trabajo de texto necesitan ajuste:
| Parámetro | Predeterminado | Código | Texto | Notas |
|---|---|---|---|---|
size-n (longitud de búsqueda) |
12 | 12-16 | 8-10 | Los n-gramas más largos reducen falsos positivos pero pierden patrones más cortos |
size-m (longitud de borrador) |
48 | 48 | 32 | Los borradores más largos significan más tokens por coincidencia, pero también más rechazos |
min-hits |
1 | 1 | 2 | Min-hits más altos reducen falsos positivos a costa de menos coincidencias |
Para cargas de trabajo de texto, reduce size-n a 8-10 y aumenta min-hits a 2. Esto intercambiaría la frecuencia de coincidencia por tasas de aceptación más altas por coincidencia.
Decodificación autoespeculativa
La decodificación autoespeculativa (también llamada LayerSkip o autoespeculación) usa el propio cálculo parcial del modelo como borrador, por lo que no se necesita un modelo separado.
Cómo funciona
En lugar de ejecutar el modelo completo para cada token, la decodificación autoespeculativa ejecuta una versión truncada, omitiendo algunas capas transformadoras, para generar tokens de borrador de forma barata, y luego el modelo completo verifica las propuestas.
Por ejemplo, un modelo de 32 capas podría ejecutarse con solo 16 capas para el borrador, y luego verificar con las 32 capas. La pasada hacia adelante truncada es más rápida porque procesa menos capas, y los tokens de borrador se benefician de ver las mismas capas iniciales que el objetivo.
Ventajas:
- No hay pesos de modelo adicionales que cargar
- Naturalmente alineado con la distribución del objetivo (misma arquitectura, capas parciales)
- Funciona bien para modelos con redundancia significativa en capas más profundas
Desventajas:
- Requiere modificar el motor de inferencia para soportar pasadas hacia adelante parciales
- Complicaciones de caché KV: el borrador usa una caché KV parcial que debe reconciliarse con la caché del modelo completo
- Las tasas de aceptación son típicamente más bajas que EAGLE o modelos de borrador bien ajustados
Implementación en llama.cpp: El PR #18471 introdujo la decodificación autoespeculativa usando el historial de contexto como borrador. El modelo reutiliza tokens de su propio historial de generación para proponer continuaciones, particularmente efectivo para cargas de trabajo de código donde los patrones se repiten dentro de la misma ventana de contexto.
MTP (Predicción Multi-Token)
MTP es una forma especializada de decodificación especulativa integrada directamente en ciertos puntos de control de modelos. Qwen 3.6 incluye variantes GGUF estándar y habilitadas para MTP.
Cómo difiere: Las cabezas MTP están integradas en la arquitectura del modelo durante el entrenamiento. El modelo lleva cabezas de predicción adicionales que proponen múltiples tokens futuros en una sola pasada hacia adelante. No hay un modelo de borrador separado: las cabezas MTP son parte del propio modelo objetivo.
Compromisos:
- No hay un modelo de borrador que gestionar: MTP se activa con
--spec-type draft-mtp --spec-draft-n-max N - Las cabezas MTP añaden ~1-2 GB de sobrecosto de VRAM
- Funciona mejor en arquitecturas MoE (Qwen 3.6 35B-A3B) donde la enrutación dispersa mantiene las cabezas MTP baratas
Para benchmarks detallados de MTP frente a la decodificación estándar en Qwen 3.6 27B y 35B, consulta Qwen 3.6 MTP vs Estándar en GPU de 16GB.
Tasas de aceptación: lo que significan en la práctica
La tasa de aceptación (α) es la métrica individual más importante para el rendimiento de la decodificación especulativa. Determina si estás obteniendo una aceleración o pagando un sobrecosto.
La fórmula de aceleración
Tokens aceptados esperados por pasada de verificación:
E[aceptados] = α × K
Donde K es el número de tokens de borrador propuestos por ciclo. Si α = 0,7 y K = 5, aceptas 3,5 tokens por pasada, una aceleración de 3,5x sobre la decodificación estándar (que produce 1 token por pasada).
Tasa de aceptación por método
| Método | Rango típico de α | Mejor carga de trabajo |
|---|---|---|
| Modelo de borrador (misma familia) | 40-60% | Chat general, razonamiento |
| Modelo de borrador (familia cruzada) | 20-40% | Rara vez recomendado |
| EAGLE-3 | 60-80% | Cargas de trabajo generales, código |
| P-EAGLE | 65-85% | Cargas de trabajo generales, especulación más profunda |
| n-gram | 10-90%+ | Dependiente de la carga de trabajo (alta en repetitiva, casi cero en novel) |
| MTP | 50-70% | Específicamente modelos Qwen 3.6 |
| Autoespeculativa | 30-50% | Codificación, patrones repetitivos |
Cuando la tasa de aceptación cae
La tasa de aceptación no es constante a lo largo de una generación. Varía por:
- Posición del token: Los tokens iniciales tienden a tener mayor aceptación (más contexto, menos incertidumbre). Los tokens posteriores caen a medida que el modelo explora continuaciones más diversas.
- Tipo de carga de trabajo: La edición de código con patrones repetidos ve α > 80%. La escritura creativa abierta ve α < 40%.
- Temperatura: Una temperatura más alta aumenta la divergencia entre el borrador y el objetivo, reduciendo la aceptación. La decodificación especulativa funciona mejor con temperatura baja (0,0-0,7).
Umbral crítico: Si tu tasa de aceptación efectiva (α × K) cae por debajo de 1,0, la decodificación especulativa es más lenta que la decodificación estándar. El sobrecosto del borrador más el tiempo de verificación supera el costo de un paso autorregresivo único.
Decodificación especulativa en producción: lo que realmente ocurre
Los papers de investigación reportan aceleraciones de 2-4x, pero los benchmarks de producción cuentan una historia más matizada: las aceleraciones se reducen con el tamaño de lote, la verificación domina el tiempo del ciclo y ningún método gana en cada carga de trabajo.
Hallazgos de SpecDecode-Bench (2026)
Una evaluación sistemática de cinco variantes de SD (n-gram, EAGLE, EAGLE-3, Draft-Model, MTP) en vLLM a través de cuatro modelos y seis cargas de trabajo reveló:
-
La SD funciona, pero las aceleraciones se reducen con el tamaño de lote. Con tamaño de lote 1, EAGLE logra hasta 1,96x en Llama-3-70B. Con tamaño de lote 128, esto cae a 1,21x. El sistema se vuelve limitado por el cómputo a alta concurrencia, y la GPU tiene menos capacidad de cómputo ociosa sobrante para la especulación.
-
La verificación domina el tiempo de ejecución (42-95%). La pasada hacia adelante del modelo objetivo es el cuello de botella. Reducir la verificación desperdiciada en tokens rechazados es el camino de mejora más prometedor.
-
Ningún método gana en todas partes. EAGLE-3 es la mejor opción general. Los métodos de modelo de borrador sobresalen cuando el modelo objetivo es grande (70B+). El n-gram es óptimo para la edición de código y tareas de alta superposición.
-
El análisis oracle revela una brecha. El límite superior teórico para las estrategias combinadas de n-gram + EAGLE alcanza ~4,9x en cargas de trabajo de edición de código, pero las implementaciones actuales logran 2-3x. Hay margen para la optimización.
Expectativas de aceleración práctica
| Escenario | Aceleración Esperada |
|---|---|
| Modelo 70B, solicitud única, EAGLE-3 | 1,5-2,0x |
| Modelo 70B, lote 32, EAGLE-3 | 1,2-1,5x |
| Modelo 8B, solicitud única, modelo de borrador | 1,3-1,8x |
| Edición de código, n-gram | 2,0-4,0x (dependiente de la carga de trabajo) |
| Escritura creativa, cualquier método | 1,0-1,3x (a menudo no vale la pena) |
| MTP en Qwen 3.6 27B, GPU de 16GB | 1,5-1,7x |
| P-EAGLE en B200, solicitud única | 2,0-3,0x |
El efecto del tamaño de lote es crítico. En lotes pequeños, la GPU tiene cómputo ocioso sobrante para la especulación. En lotes grandes, el sistema ya está saturado, y la decodificación especulativa añade sobrecosto sin un beneficio proporcional.
Monitoreo en producción
Debes rastrear la tasa de aceptación en producción. Una tasa de aceptación decreciente señala que tu modelo de borrador se está desviando del objetivo: ya sea porque la carga de trabajo cambió o porque el modelo de borrador necesita reentrenamiento.
Métricas clave para monitorear:
- Tasa de aceptación por solicitud (debería ser estable alrededor de tu línea base)
- Tokens por segundo con vs. sin decodificación especulativa (la aceleración real)
- Tiempo de verificación como porcentaje del tiempo del ciclo (debería ser 42-95%)
- Tiempo de pasada hacia adelante del modelo de borrador (debería ser < 20% del tiempo del modelo objetivo)
Si tu tasa de aceptación cae por debajo del 40%, desactiva la decodificación especulativa para esa solicitud. El sobrecosto no vale la pena.
Configuración práctica
La elección del motor importa tanto como la estrategia de borrador; consulta Ollama vs vLLM vs LM Studio y otros runtime locales para ver cómo cada runtime maneja el loteo, la compatibilidad de API y el rendimiento antes de elegir una ruta de decodificación especulativa.
llama.cpp
Para la configuración general del servidor y la carga de GGUF, comienza con la introducción a llama.cpp; las banderas de abajo añaden la decodificación especulativa encima.
llama.cpp soporta múltiples métodos de decodificación especulativa a través de la bandera --spec-type:
# Modelo de borrador (independiente)
llama-server \
  --model target-model.gguf \
  --draft-model draft-model.gguf \
  --spec-draft-n-max 4 \
  --parallel 1  # Obligatorio: --parallel 1 para decodificación especulativa

# n-gram
llama-server \
  --model target-model.gguf \
  --spec-type ngram-simple \
  --spec-ngram-simple-size-n 12 \
  --spec-ngram-simple-size-m 48

# n-gram (ajuste para carga de trabajo de texto)
llama-server \
  --model target-model.gguf \
  --spec-type ngram-simple \
  --spec-ngram-simple-size-n 8 \
  --spec-ngram-simple-size-m 32 \
  --spec-ngram-simple-min-hits 2

# MTP (Qwen 3.6)
llama-server \
  --model Qwen3.6-27B-MTP.gguf \
  --spec-type draft-mtp \
  --spec-draft-n-max 2

# Autoespeculativa (cargas de trabajo de codificación)
llama-server \
  --model target-model.gguf \
  --spec-type draft-self
Banderas críticas:
--parallel 1: La decodificación especulativa en llama.cpp requiere el modo de lote único. Esta es una limitación actual.--spec-draft-n-max: Número de tokens de borrador por ciclo. Comienza con 3-5; valores más altos aumentan la presión sobre la VRAM.--spec-ngram-simple-size-n: Longitud del n-grama de búsqueda. El predeterminado 12 funciona bien para código; redúcelo a 8 para texto.
Errores comunes:
- Olvidar
--parallel 1: el servidor ignorará silenciosamente la decodificación especulativa. - Usar modelos de borrador cruzados de familia: las tasas de aceptación colapsan, anulando cualquier aceleración.
- Configurar
--spec-draft-n-maxdemasiado alto: cada token de borrador extra cuesta VRAM para el búfer de borrador. Las ganancias decrecientes empiezan alrededor de 5-8.
vLLM
La introducción a vLLM cubre la implementación base; las banderas de abajo habilitan la decodificación especulativa en un servidor vLLM existente.
vLLM soporta la decodificación especulativa a través de las banderas --speculative-model y --speculative-num-steps:
# Modelo de borrador
vllm serve target-model \
  --speculative-model draft-model \
  --speculative-num-steps 5 \
  --speculative-accept-length 5

# EAGLE-3
vllm serve target-model \
  --speculative-model EAGLE-target-model/ \
  --speculative-num-steps 7 \
  --speculative-draft-tensor-parallel-size 1

# P-EAGLE (borrado paralelo)
vllm serve target-model \
  --speculative-model P-EAGLE-target-model/ \
  --speculative-num-steps 7 \
  --speculative-parallel-drafting true

# n-gram
vllm serve target-model \
  --speculative-method ngram \
  --speculative-num-steps 5 \
  --ngram-context-size 12
La decodificación especulativa de vLLM está integrada con el loteo continuo, por lo que funciona bajo cargas de trabajo concurrentes. El programador maneja múltiples espacios de tokens dentro de una sola pasada hacia adelante, y el administrador de memoria maneja la caché KV para ambos, el modelo de borrador y el modelo objetivo.
SGLang
SGLang soporta la decodificación especulativa a través de su bandera --speculative-algorithm:
python -m sglang.launch_server \
  --model-path target-model \
  --speculative-algorithm ngram \
  --ngram-context-size 12 \
  --ngram-max-candidate-tokens 6
La arquitectura RadixAttention de SGLang se combina bien con la decodificación especulativa porque la caché de prefijos reduce el costo de verificación: el modelo objetivo reutiliza la atención en caché para prefijos compartidos, haciendo que cada pasada de verificación sea más barata que una pasada hacia adelante en frío.
TensorRT-LLM
TensorRT-LLM proporciona decodificación especulativa de grado de producción con Triton Inference Server. La configuración es más involucrada pero ofrece el mejor rendimiento en hardware NVIDIA:
- Construye el motor TensorRT para ambos, el modelo objetivo y el modelo de borrador.
- Configura el repositorio de modelos con
model.yamlespecificando la configuración de decodificación especulativa. - Lanza Triton con la API LLM / backend de PyTorch.
TensorRT-LLM soporta tanto variantes de modelo de borrador como EAGLE-3. Para cargas de trabajo de generación de código, TensorRT-LLM con decodificación especulativa de n-gramas ha demostrado una reducción de latencia de 2-3x en despliegues de producción.
Cuándo usar decodificación especulativa
Úsalo cuando
- Modelos objetivo grandes (7B+): El sobrecosto del mecanismo de borrador se amortiza a través del cómputo del objetivo. La decodificación especulativa brilla cuando el modelo objetivo es lento: cuanto más grande sea el objetivo, más valiosa será la aceleración.
- Cargas de trabajo de baja temperatura: La decodificación especulativa funciona mejor con temperatura 0,0-0,7, donde la distribución del modelo objetivo está concentrada y el borrador tiene una mejor oportunidad de coincidir.
- Aplicaciones interactivas: Las cargas de trabajo sensibles a la latencia (chat, autocompletado de código, llamadas de herramientas de agentes) se benefician más. El procesamiento por lotes donde ya estás saturando la GPU ve menos beneficio.
- Generación y edición de código: La alta repetición en los patrones de código hace que la decodificación de n-gram y autoespeculativa sea particularmente efectiva.
Omítelo cuando
- Modelos objetivo pequeños (< 3B): El sobrecosto del modelo de borrador se acerca al tiempo de la pasada hacia adelante del objetivo. La aceleración es marginal o negativa.
- Muestreo de alta temperatura: Con temperatura > 0,7, la distribución del modelo objetivo es demasiado amplia para que el borrador coincida de forma fiable.
- Escritura creativa y generación abierta: Las bajas tasas de aceptación en contenido novel hacen que el sobrecosto no valga la pena.
- Tamaños de lote altos (> 32): El sistema se vuelve limitado por el cómputo, y la decodificación especulativa añade sobrecosto sin un beneficio proporcional. SpecDecode-Bench muestra que la aceleración cae de 1,96x a 1,21x a medida que el tamaño de lote va de 1 a 128.
Combinando métodos
Las configuraciones avanzadas combinan múltiples estrategias de decodificación especulativa. El análisis oracle de SpecDecode-Bench mostró que combinar de forma adaptativa n-gram y EAGLE puede impulsar la aceleración a 4,9x en cargas de trabajo de edición de código.
La idea es usar n-gram para patrones que han aparecido antes, donde la aceptación es alta y el sobrecosto es casi cero, y recurrir a EAGLE para tokens novel. En la práctica, esto requiere soporte del motor para la especulación multi-método: vLLM y TensorRT-LLM tienen soporte experimental, pero las implementaciones de grado de producción aún están madurando.
Por ahora, la combinación más práctica es MTP + n-gram en llama.cpp. MTP maneja la especulación neural, mientras que n-gram atrapa los patrones repetitivos que MTP pasa por alto. En Qwen 3 27B, esta combinación logra 120 tokens/seg en comparación con 67 tokens/seg estándar: una aceleración de 1,8x.
Consideraciones de costo
La decodificación especulativa intercambia cómputo por latencia. El cómputo total por token es aproximadamente el mismo: solo estás haciendo más trabajo en paralelo en lugar de secuencialemente.
Impacto en el costo de GPU:
- La latencia por solicitud única mejora en un 20-50%, lo cual importa para aplicaciones interactivas.
- El rendimiento (tokens/seg a través de muchas solicitudes) mejora menos: la GPU ya está saturada en tamaños de lote altos.
- El uso de VRAM aumenta por la huella del modelo de borrador (1-4 GB para borradores independientes, mínimo para n-gram/EAGLE).
Inferencia en la nube: A $2-4/hr por H100, la decodificación especulativa reduce la latencia por solicitud sin aumentar el costo por token. Para el procesamiento por lotes donde ya estás saturando la GPU, el beneficio de costo es mínimo: estás pagando por el mismo tiempo de GPU de todos modos.
Cuándo la decodificación especulativa ahorra dinero: Aplicaciones interactivas donde cobras por solicitud y quieres reducir el tiempo hasta el primer token. Una aceleración de 2x significa que tus usuarios esperan la mitad de tiempo, y puedes servir más solicitudes por segundo en el mismo hardware.
Cuándo no lo hace: Procesamiento por lotes donde ya estás maximizando la utilización de la GPU. El cómputo extra de la decodificación especulativa no aumenta el rendimiento: solo cambia el perfil de latencia.
Qué sigue
La decodificación especulativa está madurando de novedad de investigación a estándar de producción. La frontera empuja más allá de las limitaciones actuales:
-
Generación paralela a nivel de modelo: La decodificación especulativa empuja múltiples tokens por pasada hacia adelante a nivel de inferencia sin tocar la distribución de salida. Los modelos de lenguaje de difusión apuestan de una manera estructuralmente diferente, generando múltiples tokens por pasada hacia adelante como parte de la arquitectura del modelo misma. Consulta qué viene después de los LLMs para ver cómo se compara eso con el enfoque de borrador-verificación de arriba, y con los modelos de espacio de estado y los modelos de mundo JEPA en el otro extremo del paisaje post-transformer.
-
Decodificación Especulativa Especulativa (SSD): Paraleliza las etapas de borrado y verificación a través de hardware separado. El modelo de borrador se ejecuta asíncronamente, pre-especulando para múltiples resultados de verificación probables. Los resultados iniciales muestran una aceleración de hasta 2x sobre la decodificación especulativa optimizada, y 5x sobre la decodificación autorregresiva. Todavía no está listo para producción, pero la dirección es clara.
-
SpecSA (Verificación Especulativa Dispersa): Combina la decodificación especulativa con atención dispersa dinámica. Convierte la atención dispersa en una carga de trabajo orientada a la verificación, logrando un rendimiento final de hasta 3,49x sobre la decodificación dispersa autorregresiva. Relevante para modelos de contexto largo donde la atención dispersa ya se está usando.
-
Especulación adaptativa: Conmutación automática entre métodos de n-gram, EAGLE y modelo de borrador basándose en las características de la carga de trabajo. El análisis oracle muestra un potencial significativo no explotado: las implementaciones actuales logran 2-3x, pero el límite teórico es 4,9x.
-
Decodificación especulativa multimodal: Extensión del borrador-verificación a modelos de lenguaje-visión y generación de video. Las encuestas iniciales muestran que los mismos principios aplican, pero las estrategias de verificación necesitan adaptación para modalidades no textuales.
Marco de decisión
| Pregunta | Respuesta | Recomendación |
|---|---|---|
| ¿Tamaño del modelo objetivo? | < 3B | Omitir la decodificación especulativa |
| ¿Tamaño del modelo objetivo? | 7-13B | Usar n-gram o autoespeculativa (bajo sobrecosto) |
| ¿Tamaño del modelo objetivo? | 30B+ | Usar modelo de borrador o EAGLE-3 (objetivo más grande = más beneficio) |
| ¿Tipo de carga de trabajo? | Edición/refactorización de código | Combinación de n-gram + EAGLE |
| ¿Tipo de carga de trabajo? | Chat general | EAGLE-3 o P-EAGLE |
| ¿Tipo de carga de trabajo? | Escritura creativa | Omitir la decodificación especulativa |
| ¿Tamaño de lote? | 1-4 (interactivo) | La decodificación especulativa ayuda más |
| ¿Tamaño de lote? | 32+ (rendimiento) | La decodificación especulativa ayuda menos |
| ¿Temperatura? | 0,0-0,7 | Bueno para decodificación especulativa |
| ¿Temperatura? | > 0,7 | Omitir la decodificación especulativa |
| ¿Hardware? | GPU de 16GB | Usar n-gram o MTP (bajo sobrecosto de VRAM) |
| ¿Hardware? | GPU de 24GB+ | Modelo de borrador o EAGLE-3 factible |
| ¿Motor? | vLLM | EAGLE-3 o P-EAGLE (mejor integración) |
| ¿Motor? | llama.cpp | n-gram o MTP (configuración más simple) |
| ¿Motor? | TensorRT-LLM | EAGLE-3 o modelo de borrador (grado de producción) |
