
RTX 5090 in Australia: prezzi, disponibilità e realtà di marzo 2026
La RTX 5090 in Australia è scarsa e sopravvalutata.
L’Australia ha scorte di RTX 5090. A malapena. E se ne trovate una, pagherete un sovrapprezzo che sembra distaccato dalla realtà.
La RTX 5090 in Australia è scarsa e sopravvalutata.
L’Australia ha scorte di RTX 5090. A malapena. E se ne trovate una, pagherete un sovrapprezzo che sembra distaccato dalla realtà.
Accesso remoto a Ollama senza porte pubbliche
Ollama è al suo meglio quando viene trattato come un demone locale: la CLI e le tue applicazioni comunicano con un’API HTTP su loopback, e il resto della rete non viene a sapere della sua esistenza.
Log JSON interrogabili che si collegano alle tracce.
I log rappresentano un’interfaccia di debugging utilizzabile anche quando il sistema è in fiamme. Il problema è che i log in testo puro si deteriorano rapidamente: non appena è necessario filtrare, aggregare e configurare allarmi, si inizia a analizzare le frasi.
Server Ollama con priorità alla configurazione, GPU e persistenza.
Ollama funziona egregiamente su hardware nativo. Diventa ancora più interessante quando lo si tratta come un servizio: un endpoint stabile, versioni bloccate, storage persistente e una GPU che o è disponibile o non lo è.
HTTPS per Ollama senza interrompere le risposte in streaming.
Eseguire Ollama dietro un proxy inverso è il modo più semplice per ottenere HTTPS, un controllo degli accessi opzionale e un comportamento di streaming prevedibile.
Embedding RAG - Python, Ollama, API OpenAI.
Se stai approfondendo la generazione potenziata dal recupero (RAG), questa sezione illustra le embeddings testuali in termini semplici: cosa sono, come si integrano nella ricerca e nel recupero, e come invocare due configurazioni locali comuni da Python utilizzando Ollama o un’API HTTP compatibile con OpenAI (come espongono molti server basati su llama.cpp).
Deploy basati su Git, CDN, crediti e compromessi.
Netlify è uno dei modi più amichevoli per gli sviluppatori per pubblicare siti Hugo e app web moderne con un flusso di lavoro di livello produzione: URL di anteprima per ogni pull request, deploy atomici, una CDN globale e funzionalità serverless e edge opzionali.
Streaming con stato, checkpoint, K8s, PyFlink, Go.
Apache Flink è un framework per elaborazioni con stato su flussi di dati limitati e illimitati.
Grafici, Cypher, vettori e rafforzamento delle operazioni.
Neo4j è la soluzione a cui si ricorre quando le relazioni sono i dati. Se il tuo dominio assomiglia a una lavagna piena di cerchi e frecce, forzare tutto in tabelle è doloroso.
Aggiorna i URL di spinta ai motori di ricerca dopo il deploy.
I siti statici e i blog cambiano ogni volta che si effettua un deployment. I motori di ricerca che supportano IndexNow possono apprendere questi cambiamenti senza attendere il prossimo crawl automatico.
Scegli un servizio di posta in hosting per il tuo dominio senza rimpianti.
Configurare una casella email sul proprio dominio sembra un compito DNS da fine settimana. In realtà si tratta di un piccolo sistema distribuito con un ventennio di storia alle spalle.
Servire modelli open-source rapidamente con SGLang.
SGLang è un framework di serving ad alte prestazioni per grandi modelli linguistici e modelli multimodali, progettato per fornire inferenza a bassa latenza e alto throughput in tutto, da una singola GPU a cluster distribuiti.
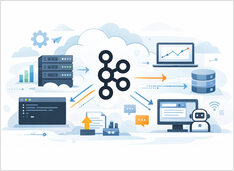
Installa Kafka 4.2 e gestisci gli eventi in streaming in pochi minuti.
Apache Kafka 4.2.0 è la versione supportata attuale e rappresenta la base ideale per una moderna guida introduttiva, poiché Kafka 4.x è completamente privo di ZooKeeper e si basa su KRaft per impostazione predefinita.
Hot-swap dei LLM locali senza modificare i client.
Presto ti ritroverai a gestire vLLM, llama.cpp e altri componenti, ognuno su una porta propria. Tutta l’infrastruttura a valle richiede comunque un unico /v1 come base URL; altrimenti continuerai a riordinare porte, profili e script one-off. llama-swap è il proxy /v1 da posizionare davanti a quegli stack.
Cosa accade effettivamente quando esegui Ultrawork.
Oh My Opencode promette un “team virtuale di sviluppatori AI” — Sisyphus che orchestra specialisti, compiti eseguiti in parallelo e la magica parola chiave ultrawork che attiva tutto.
Conoscete Sisyphus e il suo team di agenti specialisti.
Il salto di capacità più significativo in OpenCode deriva dagli agenti specializzati: una separazione deliberata tra orchestrazione, pianificazione, esecuzione e ricerca.
Ricevi nuovi articoli su sistemi, infrastruttura e ingegneria AI.