So migrieren Sie sicher von OpenClaw auf Hermes Agent

So migrieren Sie sicher von OpenClaw auf Hermes Agent

Ein sicheres Cutover jenseits des einzeiligen Imports

Die Migration eines KI-Assistenten unterscheidet sich grundlegend vom einfachen Kopieren einer Anwendungs-Konfiguration. Die eigentliche Herausforderung besteht darin, Identität, Gedächtnis, Tool-Verhalten, geplante Aufgaben und den Messaging-Zugriff so zu erhalten, dass nicht zwei Gateways als derselbe Bot agieren.

KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

Warum 128K Kontext auf 16 GB scheitert

Ein Modell kann einen 128K-Kontextfenster bewerben und trotzdem bei 40K Tokens auf einer 16-GB-GPU scheitern. Die architektonische Obergrenze hat nie versprochen, dass Modellgewichte, KV-Cache, Rechenspeicher und der Desktop-Compositor gleichzeitig auf Ihrer Grafikkarte Platz finden würden.

Was kommt nach LLMs? Mamba, Diffusion und World Models

Was kommt nach LLMs? Mamba, Diffusion und World Models

Was folgt auf LLMs? Das Zeitalter nach den Transformer-Architekturen.

Der KI-Hype folgt einem Rhythmus: In etwa dreijährigen Abständen wird die Architektur, auf die alle wetten, durch etwas Neues ersetzt. Der nächste Wandel formiert sich bereits in Forschungslaboren.

Agent-Fähigkeiten vs. MCP-Server: Entscheidungsrahmen

Agent-Fähigkeiten vs. MCP-Server: Entscheidungsrahmen

Fertigkeit, MCP-Server oder beides?

Agent Skills und MCP-Server werden oft als konkurrierende Ansätze zur Erweiterung eines KI-Agenten dargestellt. Diese Einordnung ist falsch: Eine Skill lehrt den Agenten, wie er arbeitet, während ein MCP-Server ihm kontrollierten Zugriff auf live Funktionen gewährt.

Superpowers Quickstart: Installation, Workflow und Test

Superpowers Quickstart: Installation, Workflow und Test

Erzwungene SDD-Fähigkeiten, installiert mit einem einzigen Befehl.

Superpowers bündelt eine vollständige, spec-getriebene Methodik in installierbare Claude Skills und erzwingt Brainstorming, Planung, Subagent-gesteuerte Implementierung und striktes TDD, anstatt diese Struktur Ihnen zu überlassen.

Pi Coding Agent im Test: Minimale, anpassbare KI-CLI zum Programmieren

Pi Coding Agent im Test: Minimale, anpassbare KI-CLI zum Programmieren

Ein kleiner Coding-Agent, der darauf ausgelegt ist, von Ihnen geformt zu werden.

Pi Coding Agent ist ein minimalistisches, quelloffenes Terminal-Coding-Harness, das mit vier Standard-Tools ausgeliefert wird und das meiste Verhalten an Erweiterungen, Skills und Ihren eigenen Workflow überlässt.

GFM vs. CommonMark vs. Pandoc Markdown: Ein Syntax-Vergleich

GFM vs. CommonMark vs. Pandoc Markdown: Ein Syntax-Vergleich

Wissen Sie, welche Markdown-Funktionen sicher portabel sind

Markdown sieht auf den ersten Blick aus wie eine einzige Sprache, bis dieselbe Datei auf GitHub, Hugo, Obsidian oder Pandoc unterschiedlich gerendert wird. Und das Problem ist nicht, dass Markdown unzuverlässig wäre.

Datenschwere: Die wahren Kosten von API-First-KI

Datenschwere: Die wahren Kosten von API-First-KI

Warum Ihr KI-Stack jeden Monat anhaltender wird.

Jeder API-Aufruf fühlt sich an wie eine einfache Transaktion – bis sich genügend davon ansammeln, dass Ihre Feinabigungsdaten, Evaluierungs-Tools und Tool-Schemas alle um einen einzigen Anbieter herum geformt sind und ein Wechsel nicht mehr nur eine Routing-Änderung ist.

Claude Code Subagenten: Einrichtung, Konfiguration und Einsatzszenarien

Claude Code Subagenten: Einrichtung, Konfiguration und Einsatzszenarien

Delegieren Sie die lärmintensive Arbeit und halten Sie Ihren Kontext sauber.

Die meisten Claude Code-Sitzungen werden aus demselben Grund langsam und unübersichtlich: Jeder explorative Grep-Durchlauf, jeder Log-Dump und jedes „Ich checke noch eine Datei“ bleibt für immer im Hauptchatverlauf stehen.

Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

Wann von Ollama auf vLLM wechseln

Ollama ist einer der einfachsten Wege, ein lokales Sprachmodell auszuführen, aber die Bequemlichkeit kann den Moment verbergen, in dem ein lokales Experiment zu einem gemeinsamen Inferenzdienst wird, der eine bessere Planung und Beobachtbarkeit benötigt.

Specs, Tests und Code in der KI-Entwicklung synchron halten

Specs, Tests und Code in der KI-Entwicklung synchron halten

Verhindern Sie, dass KI-Agenten von den Spezifikationen, Tests und dem Code abweichen.

KI-Coding-Agenten liefern Features schnell, aber Spezifikationen, Tests und Code veralten stillschweigend und gehen auseinander. Dieser Leitfaden behandelt ein Nachverfolgungsmodell (Traceability), die Zuordnung von Spezifikation zu Test und von Spezifikation zu Code sowie die CI-Prüfungen, die Abweichungen vor einem Merge erkennen.

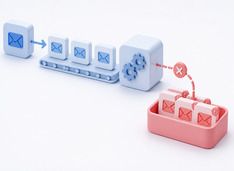
Dead Letter Queues: Umgang mit Gift-Nachrichten in verteilten Systemen

Dead Letter Queues: Umgang mit Gift-Nachrichten in verteilten Systemen

Verhindern Sie, dass vergiftete Nachrichten Warteschlangen blockieren

Eine Dead-Letter-Queue (DLQ) ist das Sicherheitsnetz, das Nachrichten einfängt, die deine Konsumenten nicht verarbeiten können, sodass ein defektes Payload nicht alles Weitere in der Warteschlange blockiert oder stillschweigend verwirft.

Abonnieren

Neue Beiträge zu Systemen, Infrastruktur und KI-Engineering.