
Hosting LLM nel 2026: confronto tra infrastrutture locali, self-hosted e cloud
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Controlla dati e modelli con LLM ospitati in-house
L’auto-ospedalizzazione degli LLM mantiene dati, modelli e inferenza sotto il tuo controllo: una via pratica per la sovranità dell’IA per team, imprese e nazioni.
Test di velocità LLM su RTX 4080 con 16 GB di VRAM
Esecuzione locale di grandi modelli linguistici (LLM) garantisce riservatezza, funzionamento offline e zero costi di API. Questo benchmark rivela esattamente cosa ci si può aspettare da 14 popolari LLM su Ollama su una RTX 4080.
Repositori Go più popolari di gennaio 2026
L’ecosistema Go continua a prosperare grazie a progetti innovativi che spaziano dall’AI, alle applicazioni auto-hosted e all’infrastruttura per sviluppatori. Questa panoramica analizza i repository Go più popolari su GitHub di questo mese.
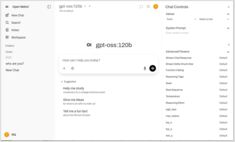
Alternativa auto-gestita a ChatGPT per LLM locali
Open WebUI è un’interfaccia web self-hosted potente, estensibile e ricca di funzionalità per l’interazione con i grandi modelli linguistici.
Prezzi AUD reali dai rivenditori australiani ora
L' NVIDIA DGX Spark (GB10 Grace Blackwell) è ora disponibile in Australia nei principali rivenditori di PC con scorte locali. Se segui le prezzi e disponibilità globali del DGX Spark, sarà interessante sapere che i prezzi in Australia variano da 6.249 a 7.999 AUD a seconda della configurazione di archiviazione e del rivenditore.
Test di Cognee con LLM locali - risultati reali
Cognee è un framework Python per costruire grafi di conoscenza da documenti utilizzando LLM. Ma funziona con modelli auto-hostati?
Output di LLM type-safe con BAML e Instructor
Quando si lavora con i Large Language Models (LLM) in produzione, ottenere output strutturati e type-safe è fondamentale. Due framework popolari - BAML e Instructor - adottano approcci diversi per risolvere questo problema.
Riflessioni sui modelli LLM per Cognee autoospitati
Scegliere il miglior LLM per Cognee richiede di bilanciare la qualità della costruzione del grafo, i tassi di allucinazione e i vincoli hardware. Cognee eccelle con modelli più grandi a bassa allucinazione (32B+) tramite Ollama ma le opzioni di dimensioni medio-piccole funzionano per le configurazioni più leggere.
Crea agenti di ricerca AI con Python e Ollama
La libreria Python di Ollama include ora funzionalità native di ricerca web Ollama. Con sole poche righe di codice, puoi migliorare i tuoi LLM locali con informazioni in tempo reale dal web, riducendo le allucinazioni e migliorando l’accuratezza.
Crea agenti di ricerca AI con Go e Ollama
L’API di ricerca web di Ollama consente di arricchire i LLM locali con informazioni web in tempo reale. Questa guida mostra come implementare le funzionalità di ricerca web in Go, dalle semplici chiamate API agli agenti di ricerca completi.
Confronta i migliori strumenti locali per l'hosting di LLM nel 2026. Maturità delle API, supporto hardware, tool calling e casi d'uso nel mondo reale.
Eseguire LLM in locale è ora pratico per sviluppatori, startup e persino per team aziendali. Ma la scelta dello strumento giusto — Ollama, vLLM, LM Studio, LocalAI o altri — dipende dai tuoi obiettivi:
Distribuisci l'AI enterprise su hardware economico con modelli open source.
La democratizzazione dell’IA è qui. Con LLM open-source come Llama, Mistral e Qwen che ora competono con i modelli proprietari, i team possono costruire potenti infrastrutture AI utilizzando hardware consumer - riducendo drasticamente i costi mantenendo il controllo totale sulla privacy dei dati e sul deployment.
Benchmark GPT-OSS 120b su tre piattaforme AI
Ho trovato alcuni interessanti test sulle prestazioni di GPT-OSS 120b in esecuzione su Ollama su tre diversi piattaforme: NVIDIA DGX Spark, Mac Studio, e RTX 4080. Il modello GPT-OSS 120b dalla libreria Ollama pesa 65 GB, il che significa che non si adatta alla VRAM da 16 GB di un RTX 4080 (o al più recente RTX 5080).
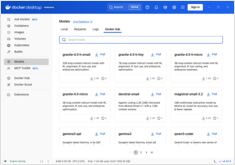
Confronta Docker Model Runner e Ollama per LLM locali
Running large language models (LLMs) locally ha guadagnato popolarità per la privacy, il controllo dei costi e le capacità offline. Il panorama si è notevolmente modificato nel aprile 2025 quando Docker ha introdotto Docker Model Runner (DMR), la sua soluzione ufficiale per il deployment di modelli AI.