
„Lekcja z przeszłości dla agenta Hermes: Pamięć hostowana lokalnie z wykorzystaniem lokalnych LLM”
Trwałe pamięci Hermes na własnym sprzęcie.
Samodzielnie hostowany agent AI potrzebuje czegoś więcej niż długiego okna kontekstu. Wymaga sposobu na zachowywanie użytecznych faktów, odzyskiwanie wcześniejszych decyzji oraz korygowanie swojej wiedzy w miarę ewolucji projektów.
Hermes Agent dostarcza wbudowanych plików pamięci, ale zewnętrzny dostawca może zapewnić znacznie bogatsze wyszukiwanie między sesjami. Hindsight jest jedną z ciekawszych opcji w tej dziedzinie. Ten przewodnik instaluje go dla Hermes z pominięciem chmurowego wnioskowania, początkowo jako jeden kontener Docker, a następnie na istniejącym serwerze PostgreSQL z osobnymi lokalnymi punktami końcowymi modeli.
Przewodnik obejmuje wdrożenie, wybór i podłączenie lokalnych modeli wbudowujących, przestawiających i generatywnych, kontrolowanie tego, co auto-zapis zapisuje w banku, łączenie z Hermesem oraz warstwę operacyjną: kopię zapasową, przeniesienie wbudowanego banku na dedykowany serwer PostgreSQL oraz bieżącą higienę banku. Przykłady używają zamierzonego schematu portów — 8080 dla głównego serwera llama.cpp, 8081 dla wektoryzacji, 8082 dla przestawiania, 11434 dla Ollama — więc zmień je na porty, których już używasz, i trzymaj małe serwery z dala od portu głównego modelu.
Co robi Hindsight
Hindsight to silnik trwałej pamięci agenta z trzema głównymi operacjami: retain (zapis), recall (wspomnienie) i reflect (refleksja). Retain wyodrębnia i przechowuje informacje; recall łączy wyszukiwanie semantyczne, słowne, grafowe i czasowe; reflect syntetyzuje odpowiedź z nagromadzonych pamięci. Tło konsolidacja może przekształcać nakładające się obserwacje w bardziej użyteczną warstwę wiedzy.
To nie jest tylko baza wektorów. Magazyn wektorowy może lokalizować podobne fragmenty, ale system pamięci musi również zachowywać chronologię, granice projektów, sprzeczne dowody i zmiany w decyzjach. Te tryby awarii są omawiane w artykule samonapędzające pętle pamięci.
W przypadku szerszego rynku zobacz porównanie dostawców pamięci agentów). Wbudowane MEMORY.md, USER.md i tryby pamięci w Hermes są opisane w przewodniku system pamięci Hermes Agent, więc ten artykuł zakłada, że wiesz, jak działa wbudowana warstwa.
Dlaczego wykraczać poza Mnemosyne
Mnemosyne dla Hermes oferuje atrakcyjne pomysły lokalne, w tym przechowywanie SQLite i hybrydowe wyszukiwanie. W praktyce, ograniczenia instalacji, kompatybilność wersji, zachowanie zatwierdzania zapisu oraz szybkie zmiany wokół wydania 4.0 mogą sprawiać, że przewidywalna eksploatacja staje się trudna. To są kwestie operacyjne, a nie dowód na to, że model pamięci Mnemosyne jest fundamentalnie wadliwy.
Hindsight również nie jest wolny od zależności: jego obraz Docker i lokalne modele mogą zużywać znaczną ilość miejsca na dysku. Uruchamianie jego API jako niezależnej usługi, z wnioskowaniem w innym miejscu, izoluje aktualizacje i usuwanie usterek od samego agenta.
Wybór wdrożenia
| Komponent | A: Jednolity kontener | B: Istniejący serwer PostgreSQL |
|---|---|---|
| API i UI Hindsight | Kontener Docker | Kontener Docker |
| PostgreSQL | Wbudowany pg0 w kontenerze |
Istniejąca maszyna PostgreSQL |
| Generatywne LLM | Zewnętrzny llama.cpp | Zewnętrzny llama.cpp |
| Wektoryzacja | Domyślnie lokalnie lub zewnętrznie | Zewnętrzny Ollama lub llama.cpp |
| Przestawianie (Reranking) | Domyślnie lokalnie lub zewnętrznie | Zewnętrzny serwer przestawiania |
| Najlepsze do | Szybkiej oceny | Długotrwałej, izolowanej instalacji |
„Jednolity” oznacza tutaj, że API, UI i baza danych Hindsight znajdują się w jednym kontenerze; generatywne LLM jest nadal hostowane w innym miejscu. Jest to zamierzone: oficjalny obraz Docker Hindsight nie zawiera gotowego do użycia lokalnego serwera generatywnego llama.cpp.
Używaj adresów osiągalnych w LAN, a nie localhost, dla usług uruchamianych na innej maszynie. Ogranicz te porty do zaufanych klientów; przykładowe klucze dummy to placeholdery kompatybilności, a nie uwierzytelnianie.
Opcja A: Jednolity kontener Hindsight
To najprostszy sposób na ocenę Hindsight bez zapełniania VM Hermes zależnościami Python, Torch i lokalnych modeli. Kontener uruchamia Hindsight i wbudowany PostgreSQL, podczas gdy Twój główny LLM llama.cpp obsługuje wyodrębnianie pamięci i refleksję.
Dwie tagi obrazów mają tu znaczenie. ghcr.io/vectorize-io/hindsight:latest to duży obraz — około 9 GB na AMD64 — ponieważ zawiera wbudowany enkoder BGE, przestawiacz MiniLM i wbudowany PostgreSQL. latest-slim ma około 500 MB i oczekuje, że te dwa modele znajdują się w innym miejscu, co jest pożądane, gdy wskażesz Hindsight na konfigurację wektoryzacji i przestawiania z sekcji Serwisowanie i podłączanie lokalnych modeli. Po pomyślnym przebyciu testu zdrowia przypnij konkretny tag: ruchomy tag to kiepski wybór dla bazy danych, którą zamierzasz zachować.
Utwórz katalog i plik Compose na hoście Hindsight:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # API Pamięci
      - "9999:9999"  # UI Płaski sterujący
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://ADRES_IP_STACJI_PRACY:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Podmień ADRES_IP_STACJI_PRACY na adres hosta uruchamiającego llama.cpp. W systemie Linux host.docker.internal rozwiązuje się tylko, jeśli kontener deklaruje mapowanie host-gateway pokazane powyżej; bez niego adres bazowy http://host.docker.internal:8080/v1 nie prowadzi donikąd. Rezerwacja 1 GB pamięci współdzielonej jest szczególnie przydatna dla indeksowania wbudowanego PostgreSQL; mały domyślny /dev/shm Docker może powodować awarie. Nazwany wolumen zachowuje bazę danych przy ponownym utworzeniu kontenera, a alternatywa z montowaniem powiązanym (bind mount) musi być własnością użytkownika o uid 1000, co odpowiada użytkownikowi wewnątrz obrazu.
HINDSIGHT_API_WORKER_ID powinien pozostać stabilny przy ponownych utworzeniach — domyślnym w Docker jest nazwa hosta kontenera, a zadanie, które było w trakcie, gdy kontener padł, pozostaje zablokowane pod starym identyfikatorem pracownika.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Jeśli Twoja zainstalowana wersja Hindsight ujawnia stan zdrowia pod inną ścieżką, sprawdź http://localhost:8888/docs i logi kontenera. Płaski sterujący jest zazwyczaj dostępny pod http://HOST_HINDSIGHT:9999. Gdy podstawowe wdrożenie działa, możesz również skierować jego dostawców wektoryzacji i przestawiania na konfigurację z sekcji Serwisowanie i podłączanie lokalnych modeli, zamiast wczytywać domyślne modele wewnątrz kontenera.
Nie wystawiaj portów 8888 ani 9999 bezpośrednio do internetu. Używaj sieci prywatnej lub uwierzytelnianego proxy odwrotnego. Wbudowany PostgreSQL jest wygodny do testów, ale zewnętrznie zarządzana baza danych jest łatwiejsza w kopii zapasowej i konserwacji. Bank, który już istnieje w tym wolumenie, jest przenoszony wraz z dumpem i przywracaniem w sekcji Przeniesienie wbudowanej bazy danych na dedykowany serwer.
Opcja B: Hindsight na istniejącym serwerze PostgreSQL
Dla długotrwałej instalacji preferuję oddzielanie API Hindsight, bazy danych i punktów końcowych wnioskowania. VM Hindsight może pozostać mała, ponieważ uruchamia orkiestrację i usługi HTTP, a nie ciężkie modele. Kroki poniżej zaczynają od pustego serwera. Bank, który już istnieje w wolumenie z Opcji A, jest przenoszony w sekcji Przeniesienie wbudowanej bazy danych na dedykowany serwer.
Przygotowanie PostgreSQL i pgvector
Hindsight wymaga PostgreSQL 14 lub nowszej wersji i rozszerzenia wektorowego w bazie danych hindsight. Rozszerzenie dotyczy konkretnej bazy: instalacja pakietu na serwerze niczego nie robi, dopóki nie wykona się tam CREATE EXTENSION. Na serwerze PostgreSQL na Debian lub Ubuntu zainstaluj pakiet pgvector pasujący do faktycznej wersji głównej PostgreSQL; na przykład, dla PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
Nazwa pakietu i jego dostępność zależą od skonfigurowanych repozytoriów apt. Jeśli nie jest dostępny, postępuj zgodnie z instrukcjami instalacji pgvector lub zainstaluj kompatybilny pakiet z repozytorium PostgreSQL PGDG. Nie zmieniaj ślepo wersji głównej PostgreSQL na wspólnym serwerze. W pakietach PGDG PostgreSQL 18 pg_trgm i btree_gin znajdują się wewnątrz postgresql-18. W pakietach dystrybucji są w postgresql-contrib dla tej wersji głównej. Wbudowana baza danych używa obu, a także vector.
Utwórz dedykowaną rolę i bazę danych jako administrator PostgreSQL:
CREATE ROLE hindsight LOGIN PASSWORD 'ZAMIEŃ_DŁUGIE_HASŁO';
CREATE DATABASE hindsight OWNER hindsight;
Połącz się z nową bazą danych i włącz rozszerzenia:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS pg_trgm;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS btree_gin;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname IN ('vector','pg_trgm','btree_gin');"
Te rozszerzenia zazwyczaj wymagają uprzywilejowanego konta do instalacji; rola aplikacji nie musi być superuserem. Hindsight domyślnie używa pgvector i oczekuje wersji 0.8.0 lub nowszej dla iteracyjnych skanów ANN; starsze serwery odrzucają tę ustawienie. HINDSIGHT_API_VECTOR_EXTENSION może alternatywnie wybrać pgvectorscale (opcję DiskANN, którą Hindsight dokumentuje dla bardzo dużych banków) lub vchord, oba wymagają dodatkowego pakietowania dla tego dokładnego buildu PostgreSQL. Przełączanie algorytmów po istnieniu pamięci zatrzymuje start i żąda migracji, więc wybierz przed pierwszym zapisem. Dla osobistego banku Hermes, pgvector jest tym, którego należy zainstalować i o tym zapomnieć.
Dozwól tylko hostowi Hindsight przez pg_hba.conf, na przykład:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Ustaw listen_addresses PostgreSQL odpowiednio i używaj TLS lub zaufanej sieci prywatnej dla połączeń między hostami. Twórz kopię tej bazy danych niezależnie od kontenera Docker Hindsight. Jeśli serwer jest współdzielony z innymi aplikacjami, trzymaj Hindsight we własnej bazie danych, lub ustaw HINDSIGHT_API_DATABASE_SCHEMA na schemat, który posiadasz; domyślny schemat to public.
Uruchomienie Hindsight na PostgreSQL
Utwórz compose.yaml na VM Hindsight. Ta wersja celowo nie uruchamia PostgreSQL lokalnie:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://ADRES_IP_STACJI_PRACY:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Przechowuj adres zewnętrznej bazy danych w pliku o nazwie .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:HASŁO@IP_POSTGRES:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Jeśli Twoje hasło zawiera @, :, / lub inne zarezerwowane znaki URL, zakoduj je metodą URL przed umieszczeniem w ciągu połączenia. Przetestuj, czy VM Hindsight może osiągnąć port 5432 PostgreSQL, i czy pg_hba.conf dozwala hostowi Hindsight — serwer zawiązany tylko do 127.0.0.1 odrzuca połączenie nawet wtedy, gdy adres URL wygląda poprawnie. Pozwól pierwszemu uruchomieniu wykonać migracje bazy danych; migracje są wykonywane przy starcie, chyba że ustawisz HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Gdy API i baza danych działają, kontynuuj w sekcjach Wybór modeli dla Hindsight i Serwisowanie i podłączanie lokalnych modeli przed połączeniem z Hermesem.
Wybór modeli dla Hindsight
Wdrożenie umieszcza API i bazę danych w sieci. Następna decyzja to, które modele wypełnią trzy role wnioskowania: wektoryzacja dla kandydatów recall, przestawiacz do ponownego sortowania oraz generatywne LLM dla retain, reflect i konsolidacji. Praktycznym domyślnym ustawieniem dla hosta Hindsight z procesorem CPU, którego GPU jest już zajęte rozmową, jest Qwen/Qwen3-Embedding-0.6B w procesie, BAAI/bge-reranker-v2-m3 w procesie oraz współdzielony model czatu llama.cpp dla pracy generatywnej.
Modele wektoryzacji
Hindsight odczytuje wymiarowanie wektoryzacji przy starcie i rozmiaruje bank tak, aby pasowało, więc model wybrany przy pierwszym zapisie pozostaje modelem banku do czasu jego przebudowy. Wymiarowanie i zachowanie instrukcji mają większe znaczenie niż pozycja na liście: silniejszy enkoder 8B nie jest wart migracji, jeśli bank jest już 384- lub 1024-wymiarowy. Wiersze poniżej są posortowane od najlżejszego do najcięższego; wartości RAM to przybliżony stopień obciążenia na CPU (FP16 / typowe lokalne wczytanie), a nie rozmiar pliku GGUF.
| Model | Parametry | Wymiar | Kontekst | Wczytany | Działa na | Uwagi |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Domyślny Hindsight; w obrazie hindsight:latest. Najszybsza ścieżka lokalna. Rozkład punktów nadal kalibruje wiele domyślnych recall_min_scores po jego opuszczeniu. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | Średni BGE po angielsku; blokuje bank 768-wymiarowy. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | Dokumentowany w Hindsight wielojęzyczny MiniLM; 50+ języków z tą samą szerokością banku 384 wymiarów co BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | Domyślny dla dostawcy onnx; lekka ścieżka wielojęzyczna CPU przy eksporcie ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | Popularny enkoder Ollama; dłuższy kontekst niż klasyczny BGE, nadal anglocentryczny. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 tylko tekst (wyłącz wieże wizji/dźwięku). 100+ języków + kod; MRL skraca do 512/256/128; prefiksy instrukcji dla wyszukiwania vs dokument. Pełne wczytanie multimodalne to 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU lub GPU | Silny wielojęzyczny enkoder dwuczęściowy; ta sama szerokość co Qwen3-0.6B, więc zamiana o tym samym wymiarze nadal wymaga pełnej re-wektoryzacji. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | Domyślny tego przewodnika. Świadomy instrukcji (instrukcja wyszukiwania po stronie zapytania); wygodny na CPU. Lokalny dostawca automatycznie stosuje instrukcję; serwery kompatybilne z OpenAI wymagają HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB quant | GPU | Poziom jakości Qwen3; blokuje bank 2560-wymiarowy. Nie wykonalne, gdy GPU konwersacyjne jest już nasycone. |
Sposób uruchomienia modelu to druga połowa wyboru. Dostawcy wektoryzacji Hindsight, od najprostszego do najbardziej złożonego:
| Dostawca | Sposób uruchomienia | Najlepszy, gdy | Uwagi |
|---|---|---|---|
local |
W-procesowy SentenceTransformers; bez sidecar | Jeden host Hindsight, enkoder CPU | Ścieżka domyślna. Ustaw HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Bez llama.cpp, Ollama lub TEI. |
onnx |
W-procesowy ONNX Runtime | Lżejszy CPU niż Torch; masz już eksport ONNX | Wymaga hindsight-api-slim[local-onnx] i HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Zewnętrzny punkt końcowy kompatybilny z OpenAI lub HF TEI | Wektoryzacja poza procesem API; współdzielony host GPU/CPU | To, co konfiguruje Serwisowanie i podłączanie lokalnych modeli dla Ollama / llama.cpp / TEI. Warto tylko, jeśli chcesz izolacji lub innej maszyny. |
Qwen3-Embedding-0.6B nie wymaga zewnętrznego serwisu wektoryzacji. Na hoście Hindsight z procesorem CPU ładuje się wewnątrz procesu API z dostawcą local — Hugging Face pobiera wagi przy pierwszym starcie, a dostawca sam stosuje instrukcję wyszukiwania modelu:
# Środowisko Compose (lub równoważne klucze .env)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Używaj zewnętrznego punktu końcowego kompatybilnego z OpenAI tylko wtedy, gdy chcesz umieścić enkoder na innej maszynie lub poza procesem API. Ollama jest jednym takim hostem:
# Wektoryzacja: Qwen3-Embedding-0.6B na Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Podmień host, port i tag na to, co pokazuje ollama list na Twojej maszynie wnioskującej.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX zależy od dostawcy:
| Ścieżka | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Pozostaw nieustawione / puste — w-procesowy dostawca sam stosuje instrukcję wyszukiwania Qwen | Pozostaw nieustawione / puste |
| Zewnętrzny Ollama / llama.cpp / kompatybilny z OpenAI | Oficjalna instrukcja wyszukiwania Qwen3 (rzeczywista nowa linia przed Query:) |
Pozostaw puste — przechowywane pamięci pozostają surowym tekstem |
| Serwer już zawija wejścia w szablon Qwen | Pozostaw oba puste — inaczej instrukcja zostanie zastosowana dwukrotnie | Pozostaw puste |
Dla ścieżki zewnętrznej ustaw:
# Rzeczywista nowa linia przed Query:. Bash $'...' to niezawodny sposób przekazania.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
W pliku Compose YAML ten sam ciąg wymaga jawnego \n (lub literalnej wartości wieloliniowej). Ustaw prefiksy przed pierwszym zapisem: późniejsza zmiana oznacza, że stare wektory i nowe zapytania nie znajdą się już w tej samej przestrzeni.
Dwie właściwości decydują więcej niż pozycja na liście. Czułość na instrukcję: wektoryzacja Qwen3 stosuje instrukcję wyszukiwania po stronie zapytania; bez pasującego prefiksu na serwerze kompatybilnym z OpenAI, strona przechowywana i strona zapytania przestają znajdować się w tej samej przestrzeni. Blokada wymiaru: ponieważ szerokość jest odczytywana raz przy starcie, przejście później z 0.6B na 4B to migracja banku, a nie zmiana konfiguracji — i nawet zamiana o tym samym wymiarze (BGE-M3 ↔ Qwen3-0.6B, lub EmbeddingGemma 2 ↔ nomic przy 768) zmienia przestrzeń wektorową, więc wektory banku nie są automatycznie przeliczane. Zaplanuj nowy bank lub ręczną re-wektoryzację/reindeksowanie; zobacz Eksport, import i migracja banku pamięci. Po opuszczeniu BGE-small, przetestuj recall_min_scores w stosunku do nowego rozkładu punktów — progi skalibrowane na BGE-small mogą być zbyt wąskie dla Qwen3-0.6B i głodować przestawiacza kandydatów. Dla benchmarków i tła GGUF/Ollama dla rodziny Qwen3, zobacz Modele Qwen3 Embedding i Reranker na Ollama.
Modele przestawiania
Wektoryzacja odzyskuje zestaw kandydatów; przestawiacz punktuje każdą parę zapytanie/fragment i ponownie sortuje ją, zanim Hindsight ją wstrzyknie. Z dostawcą local, Hindsight ładuje krzyżowy enkoder SentenceTransformers (lub generatywny przestawiacz, jeśli jest wspierany). Z zewnętrznym punktem końcowym kompatybilnym z Cohere, wysyła pełne ciało w stylu Cohere do HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Przestawiacz jest opcjonalny, ale gdy enkoder jest ustalony, to zazwyczaj największy dźwignia jakości recall — i na CPU, często większość czasu ściany recall. Wiersze są posortowane od najlżejszego do najcięższego.
| Model | Parametry | Typ | Kontekst | Działa na | Uwagi |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Krzyżowy enkoder | 128 | CPU | Domyślny Hindsight; w obrazie hindsight:latest. Poniżej sekundy dla ~20 kandydatów. Zachowaj jako nazwany fallback, jeśli cięższy model BGE jest zbyt wolny. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Krzyżowy enkoder | 512 | CPU | Ta sama rodzina, wyższa dokładność; nadal anglocentryczny MS MARCO. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Krzyżowy enkoder | 512 | CPU | Dokumentowany w Hindsight wielojęzyczny przestawiacz MiniLM. |
BAAI/bge-reranker-base |
278M | Krzyżowy enkoder | 512 | CPU | Umiarkowana poprawa względem MiniLM; en/zh. Często omawiany; pomijany, gdy v2-m3 już mieści się w budżecie opóźnień. |
BAAI/bge-reranker-v2-m3 |
568M | Krzyżowy enkoder | 8k | CPU lub GPU | Praktyczny wielojęzyczny domyślny na CPU. Dla banku ~500 pamięci, ~2.6–2.8 s na recall przy podłodze 20 kandydatów (~140 ms/kandydat; ~93–99% czasu recall). Limit kandydatów 20/40/80; obniżenie podłogi z 20 → 10 w przybliżeniu połowi koszt przestawiania. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Generatywny (token tak) | 32k | Preferowane GPU | Świadomy instrukcji, długi kontekst. Nie jest drop-in krzyżowy enkoder: wymaga wspierania generatywnego przestawiacza w nowym SentenceTransformers, a scoring /rerank w llama.cpp ma znane błędy z błędnymi punktami (hindsight-benchmarks#11). Zweryfikuj przed wdrożeniem. |
BAAI/bge-reranker-v2-gemma |
2.5B | Krzyżowy enkoder | 8k | Preferowane GPU | Silna wielojęzyczna jakość; nadmierna dla osobistego banku kilkuset pamięci, gdy GPU jest już pełne. |
Qwen/Qwen3-Reranker-4B |
4B | Generatywny | 32k | GPU | Wyższa jakość kandydata Qwen; niewykonalne bez dedykowanego VRAM. |
Qwen/Qwen3-Reranker-8B |
8B | Generatywny | 32k | GPU | Górny poziom rodziny; te same zastrzeżenia scoringu generatywnego, jeszcze większy. |
Chmurowe przestawiacze API (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe i podobne) działają w Hindsight, ale wysyłają tekst pamięci poza urządzenie. Dla lokalnej tylko wielodomenowej konfiguracji są poza zakresem.
Dwa operacyjne ograniczenia dominują wybór. VRAM: jeśli model konwersacyjny już nasyca GPU (na przykład Qwen3.8-27B Q5 na karcie 16 GB bez zapasu), każdy wiersz „Preferowane GPU” odpadają i żywy wybór zawęża się do MiniLM lub BGE-v2-m3 na CPU. Liczba kandydatów: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 w przykładzie zewnętrznego punktu końcowego poniżej) ogranicza, ile fragmentów model ponownie punktuję; każdy kandydat to pełne przejście w przód, więc obniż podłogę przed skokiem o poziom modelu. Dla Qwen3 przez llama.cpp, GGUF musi zachować głowę rankingu — stary convert_hf_to_gguf.py, który ją gubi, punktuję każdy fragment blisko zera — i nawet poprawna konwersja nadal wymaga testu znanej dobrej/złej pary fragmentów, aż ścieżka scoringu generatywnego zostanie potwierdzona.
Poziomy generatywnego LLM
Modele wektoryzacji i przestawiania nie są substytutami generatywnego LLM używanego do wyodrębniania i rozumowania nad pamięciami. Hindsight wspiera domyślne LLM i nadpisanie specyficzne dla operacji, które mogą celować w ten sam serwer llama.cpp lub niezależne punkty końcowe.
| Operacja Hindsight | Cel | Praktyczny poziom modelu | Przykłady Qwen |
|---|---|---|---|
| Retain | Wyodrębniaj fakty, encje, decyzje i chronologię | 4B minimum dla testów; 9B preferowane | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Semantyczne, słowne, grafowe i czasowe wyszukiwanie | Nie wymaga generatywnego LLM | Qwen3-Embedding-0.6B + przestawiacz |
| Reflect | Odpowiadaj na pytania, syntetyzując odzyskane pamięci | 9B do 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Konsolidacja | Wyrównuj i skracaj powiązane fakty | 9B preferowane | Qwen3.5-9B / Qwen3.8-27B |
| Odświeżenie modelu umysłowego | Aktualizuj długowieczne zsyntetyzowane zrozumienie | 9B do 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
To są zalecenia operacyjne, a nie oficjalne minimalne liczb parametrów Hindsight. Mały model może poprawnie wyodrębnić numer portu, ale przeoczyć, że wcześniejsza decyzja architektoniczna została zastąpiona. Wiarygodność wyjścia strukturalnego i wierny obchod negacji mają większe znaczenie niż sama nominalna liczba parametrów. Własne domyślne temperatury Hindsight warto zostawić w spokoju — 0.1 dla retain, 0.0 dla konsolidacji, 0.9 dla reflect — a dla retain i konsolidacji, alias niewyrażający myśli jest wart serwisowania, jeśli Twój build llama.cpp go ma, ponieważ małe checkpointy Qwen3.5 spędzają wiele tokenów w trybie myślenia.
Dla wdrożenia z istniejącym punktem końcowym llama.cpp Qwen3.8-27B, zacznij od jego współdzielenia przez zadania generatywne Hindsight z niską równoległością:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://ADRES_IP_STACJI_PRACY:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Później, skieruj rutynowe wyodrębnianie do niezależnego modelu 9B i zarezerwuj 27B dla trudnej refleksji:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://HOST_LLM_PAMIĘCI:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://ADRES_IP_STACJI_PRACY:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Mniejszy model 4B jest ekonomiczny, ale wymaga testów; 9B to rozsądny kompromis jakości/wydajności. Jeśli retain i konsolidacja dzielą mały model, obniż HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE do 2 — domyślna partia 8 to długi prompt dla małego okna kontekstu. Qwen3.6-35B-A3B jest atrakcyjny dla osobnego dobrze zaopatrzonego serwera wnioskującego (to model mieszanki ekspertów z około 3 miliardami aktywnych parametrów, więc budżetuj go jako mały model aktywny), podczas gdy gęsty model 27B jest zazwyczaj niepotrzebny dla każdego rutynowego zdarzenia retain. Ograniczanie tła równoległości chroni model konwersacyjny Hermes przed wstrzymań utrzymania pamięci.
Serwisowanie i podłączanie lokalnych modeli
Jeśli ustawienia wektoryzacji i przestawiacza w-procesowego local w sekcji Wybór modeli są wystarczające, możesz pominąć podsekcje zewnętrznego Ollama i llama.cpp i przejść do podłączenia — lub zostawić Compose na domyślnych local pokazanych tam. Punkty końcowe zewnętrzne mają znaczenie, gdy enkoder lub przestawiacz powinien znajdować się na innym hoście.
Zewnętrzna wektoryzacja: Ollama lub llama.cpp
Zewnętrzna wektoryzacja jest dla przypadku, gdy chcesz Qwen3-Embedding-0.6B (lub inny model) na osobnym hoście. Dwie praktyczne opcje to Ollama, który obsługuje akwizycję i serwisowanie modeli z małą konfiguracją, oraz llama.cpp, który daje precyzyjną kontrolę nad kwantyzacją GGUF, wątkami CPU, rozmieszczeniem urządzeń i partiami. Tło modeli i benchmarki dla obu modeli Qwen3 znajdują się w Modele Qwen3 Embedding i Reranker na Ollama.
Qwen3-Embedding-0.6B zwraca wektory 1024-wymiarowe, a Hindsight odczytuje tę szerokość przy starcie i rozmiaruje bazę danych tak, aby pasowała. Bank stworzony z wbudowanym 384-wymiarowym modelem BGE nie może przyjąć tego modelu — zacznij od pustej bazy danych lub wolumenu i zdecyduj o modelu wektoryzacji przed pierwszym zapisem. Późniejsza zmiana dostawcy wektoryzacji wymaga re-wektoryzacji przechowywanych rekordów, nawet jeśli oba modele używają tego samego wymiarowania.
Opcja 1: Ollama dla Qwen3-Embedding-0.6B
Zainstaluj Ollama na hoście wnioskującym, korzystając z oficjalnej dokumentacji instalacji Linux, a następnie uruchom model wektoryzacji:
ollama pull qwen3-embedding:0.6b
ollama serve
Dla dostępu zdalnego, skonfiguruj OLLAMA_HOST=0.0.0.0:11434 w środowisku usługi Ollama, zrestartuj usługę i ogień ją do VM Hindsight — procedura jest opisana w Zdalny dostęp do Ollama. Demon zawiązany tylko do 127.0.0.1 jest niewidoczny dla kontenera Hindsight. Najpierw sprawdź nazwę modelu z ollama list i przetestuj standardowy punkt końcowy wektoryzacji:
curl http://HOST_WKT:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"Testowa pamięć"}'
Dostawca wektoryzacji OpenAI w Hindsight wywołuje zamiast tego kompatybilny z OpenAI punkt końcowy /v1/embeddings Ollama. Zweryfikuj, że ten punkt końcowy działa z Twoją wersją Ollama przed skonfigurowaniem Hindsight. Ollama jest prosty dla wektoryzacji; nie zakładaj, że jego API oferuje kompatybilny punkt końcowy przestawiania. Dla przestawiania, preferuj ścieżkę w-procesową local BGE poniżej, lub osobny punkt końcowy llama.cpp / TEI po zważeniu punktów.
Opcja 2: llama.cpp dla Qwen3-Embedding-0.6B
Pobierz zweryfikowaną konwersję GGUF Qwen3-Embedding-0.6B. Użyj nazwy pliku GGUF, którą faktycznie pobrałeś:
#!/bin/sh
# start-embedding.sh - serwer wektoryzacji tylko CPU
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Wektoryzacja Qwen3 używa poolingu ostatniego tokena, w odróżnieniu od poolingu CLS używanego przez niektóre modele BGE. Build llama.cpp tylko CPU jest preferowany, jeśli chcesz absolutnie żadnej inicjalizacji CUDA na stacji roboczej, której GPU jest zajęte przez duży model konwersacyjny. Nie włączaj --reranking na tym serwerze wektoryzacji: to połączenie to znany sposób na uzyskanie wektora zer.
curl -s http://HOST_WKT:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"Testowa pamięć"}' \
  | jq '.data[0].embedding | length'
Pełnowymiarowe wyjście Qwen3-Embedding-0.6B powinno zawierać 1024 floatów. Sprawdź, czy konwersja GGUF i Twoje obsłużenie instrukcji zapytania/dokumentu Hindsight są kompatybilne; modele wektoryzacji wrażliwe na instrukcje mogą stracić dokładność przy nieprawidłowym promptowaniu.
Przestawiacz: lokalny BGE lub Qwen3 przez llama.cpp
Przestawianie różni się od wektoryzacji: model punktuję każdą parę zapytanie/dokument i zwraca ocenę relewancji. Na hoście Hindsight tylko z procesorem CPU — lub zawsze, gdy GPU konwersacyjne nie ma zapasu VRAM — praktyczną ścieżką jest dostawca local Hindsight z BAAI/bge-reranker-v2-m3 (lub lżejszym domyślnym MiniLM). Nie jest wymagany sidecar:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B to generatywny punktownik tokena „tak”, a nie klasyczny krzyżowy enkoder. Może być serwisowany przez llama.cpp z konwersją GGUF zaprojektowaną do rankingu, ale traktuj tę ścieżkę jako eksperymentalną, aż potwierdzisz punkty na znanej dobrej/złej parze: stary convert_hf_to_gguf.py, który gubi głowę rankingu, punktuję każdy fragment blisko zera, a natywna ścieżka /rerank w llama.cpp ma znane zgłoszenia błędnych punktów dla tej rodziny.
#!/bin/sh
# start-reranker.sh - GPU lub CPU, jak wybrane przez --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Ustaw --n-gpu-layers 0, aby uruchomić go na CPU. Wersja GPU potrzebuje dodatkowego VRAM dla buforów obliczeniowych i kontekstu, nie tylko wag modelu; unikaj zakładania, że rozmiar pliku to całkowita alokacja GPU.
curl -s http://HOST_PRZESTAW:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"Przechowywanie PostgreSQL", "documents":["Hindsight przechowuje pamięci w PostgreSQL.","Przepis na chleb."], "top_n":2}' \
  | jq
Dokument PostgreSQL powinien rankować wyżej niż niespokrewniony dokument; wszystkie zerowe oceny relewancji oznaczają, że GGUF to nieprawidłowa konwersja, a recall będzie wyglądał losowo nawet wtedy, gdy fakty są przechowywane. Sprawdź dokładny kształt results[].index i results[].relevance_score: Hindsight oczekuje kompatybilnej z Cohere odpowiedzi rerank, a kompatybilność llama.cpp może różnić się między buildami.
Podłączenie punktów końcowych do Hindsight
Dodaj następujące ustawienia środowiskowe do usługi Compose Hindsight lub przechowaj je w jego pliku .env. Wybierz jedną ścieżkę wektoryzacji — w-procesowy local, Ollama lub llama.cpp — nigdy dwie naraz.
# Opcja A: w-procesowy Qwen3 na hoście Hindsight (CPU; bez sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Opcja B: serwis wektoryzacji llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://HOST_WKT:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opcja C: Ollama na innym hoście
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opcja: lokalny przestawiacz BGE (bez sidecar; preferowane na CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Opcja: kompatybilny z Cohere punkt końcowy rerank llama.cpp (najpierw zwaliduj punkty Qwen3)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://HOST_PRZESTAW:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Nazwy zmiennych są specyficzne dla dostawcy, a niedokładność jest cicha: HINDSIGHT_API_EMBEDDINGS_BASE_URL to zły klucz, a Hindsight cicho celuje we własny punkt końcowy wektoryzacji OpenAI zamiast Twojego lokalnego serwera. Użyj HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. W przypadku ścieżki przestawiacza kompatybilnego z Cohere, Hindsight wysyła pełne ciało w stylu Cohere do HINDSIGHT_API_RERANKER_COHERE_BASE_URL; jeśli log kontenera pokazuje 404 dla /v1/rerank/rerank, Twój build dokleja /rerank samodzielnie i wartość powinna zatrzymać się na /v1.
Dla Opcji B i C, użyj wartości HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX z sekcji Modele wektoryzacji (Opcja A pozostawia go nieustawionego). Przetestuj wyszukiwanie zapytanie-do-fragmentu na Twoich rzeczywistych pamięciach po pierwszym zapisie.
Kontrola tego, co jest pamiętane
Gdy stos działa, następnym trybem awarii jest zwykle ścieżka zapisu: Hermes domyślnie ustawia auto_retain: true, więc każdy obrót rozmowy może zostać wyodrębniony do banku. Nieprawidłowe zgadywania, porzucone plany i stwierdzenia eksploracyjne stają się przeszukiwalnymi faktami, a późniejszy recall traktuje je jako dowody — to pętla opisana w samonapędzające pętle pamięci. Polityka przechwytywania dla Hindsight wśród innych dostawców jest podsumowana w porównanie dostawców pamięci agentów).
Tryby przechwytywania istniejące dziś
Nie ma przełącznika Hermes lub Hindsight o nazwie „synteza sesji”. Plugin albo automatycznie zapisuje surowe obroty rozmowy (opcjonalnie partiami), albo czeka na jawne wywołanie narzędzia hindsight_retain z jakąkolwiek content, którą mu dasz.
| Tryb | Ustawienia Hermes / Hindsight | Co otrzymujesz |
|---|---|---|
| Ciągły | auto_retain: true, retain_every_n_turns: 1 |
Każdy obrót jest zapisany i wyodrębniony jako tekst transkrypcji |
| Automatyczny partiami | auto_retain: true, podnieś retain_every_n_turns |
Obroty są buforowane w pluginie; co N-ty obrót wysyła większy ładunek retain z tych surowych obrotów — nadal automatyczne wyodrębnianie, a nie kuratorowane podsumowanie |
| Tylko jawne | auto_retain: false + narzędzie hindsight_retain |
Nic nie jest przechowywane, dopóki agent nie wywoła narzędzia z content (i opcjonalnie context / tags) |
Automatyczny partiami to nie podsumowanie sesji. Przy retain_every_n_turns > 1, plugin Hindsight w Hermes akumuluje obroty w pamięci i zapisuje je jako JSON rozmowy; przy /new, /reset, /branch i podobnych przełączach sesji spłukuje pozostały bufor pod starym dokumentem sesji. Nie ma dedykowanego podsumowacza końca sesji, a rozbiórka nieaktywnej sesji historycznie mogła gubić niespłukany bufor, gdy N > 1 (brak haka on_session_end w pluginie). Preferuj N: 1, chyba że akceptujesz ten kompromis.
Kuratorowane „zapamiętaj tę sesję” to wzorzec promptu + narzędzia, a nie flaga konfiguracji. Ustaw auto_retain: false, a następnie poproś Hermes o podsumowanie trwałe decyzje i wywołaj hindsight_retain z tym tekstem — lub wywołaj narzędzie samodzielnie przez ścieżkę narzędzi agenta. Reflect i konsolidacja banku to osobne operacje serwera Hindsight, które syntetyzują z tego, co jest już w banku; nie zastępują zapisu końca sesji i nie są włączane przez klucz config.json Hermes.
Ustawienie auto_retain na false wyłącza automatyczne przechowywanie obrotów. Nie dodaje dialogu zatwierdzania człowieka przed każdym zapisem. Agent nadal może wywoływać hindsight_retain zawsze, gdy jego to pozwalają na to; traktuj jawny retain jako celowe przechwytywanie, a nie kolejkę oczekującą.
Brak kolejki zatwierdzania
Wspólnym życzeniem jest oczekująca kolejka kandydatów pamięci, którą przeglądasz i zatwierdzasz, zanim wejdą do banku. Hindsight pod Hermes nie zapewnia dziś tego kontraktu. Mnemosyne dla Hermes implementuje etapowe zapisy specyficzne dla dostawcy w niektórych wersjach; ta ścieżka nie jest wspólnym standardem Hermes i nie dotyczy pluginu Hindsight. Dopóki nie istnieje przepływ zatwierdzania upstream, wykonalnym wzorcem jest auto_retain: false, celowy hindsight_retain i inspekcja lub usuwanie w UI płaskiego sterującego Hindsight, zanim następna sesja będzie polegać na złym fakcie. Nie ma braku klucza write_approval dla Hindsight, którego trzeba by szukać w config.json.
Sterowanie bankiem (misje, etykiety, dyrektywy, modele umysłowe)
Ludzie często nazywają następną warstwę „dostrojeniem”. W Hindsight to w większości konfiguracja banku, a nie sam config.json Hermes: misje i ustawienia wyodrębniania sterują tym, co retain zachowuje; etykiety strukturyzują encje; dyrektywy i modele umysłowe kształtują późniejszą syntezę.
| Kontrola | Gdzie się znajduje | Jak pomaga |
|---|---|---|
Misja retain (retain_mission / bank_retain_mission Hermes) |
Konfiguracja banku | Język potoczny „zwróć uwagę na X, zignoruj Y” wstrzykiwany do wyodrębniania |
Tryb wyodrębniania (concise, verbose, custom, …) |
Konfiguracja banku | concise (domyślny) zachowuje fakty warte długoterminowo; custom zastępuje wbudowane reguły przez retain_custom_instructions |
| Etykiety encji | Konfiguracja banku | Kontrolowany słownictwo klucz:wartość w czasie retain → linki grafowe i opcjonalne tagi; poprawia strukturę wyszukiwania, nie sam w sobie odrzuca błędne stwierdzenia |
| Dyrektywy („twarde reguły”) | API dyrektyw banku | Jawne instrukcje egzekwowane podczas reflect (zakres tagu); ograniczają syntezę, nie brama zatwierdzania zapisu |
| Modele umysłowe | API modeli umysłowych banku | Stałe odpowiedzi na powtarzające się pytania, odświeżane przez reflect z pasujących pamięci; wyprowadzone, więc złe fakty źródłowe nadal je zatruwają |
| Misja reflect / obserwacji | Konfiguracja banku | Steruje syntezą i konsolidacją, a nie surową strzyżawką retain |
Misje, zwięzłe wyodrębnianie i etykiety redukują szum i poprawiają wyszukiwanie. Nie zastępują wyłączania auto-retain, gdy dokładność ważniejsza jest niż kompletność. Preferuj krótką misję retain nazywającą trwałe decyzje projektowe i ignorującą logistykę czatu; dodawaj etykiety encji tylko, gdy masz prawdziwą taksonomię; dodawaj modele umysłowe dla dwóch lub trzech powtarzających się pytań po tym, jak bank już posiada czyste fakty.
Zalecany profil higieny
Konkretym punktem startowym dla osobistego banku Hermes:
{
  "mode": "local_external",
  "api_url": "http://IP_VM_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
Na banku ustaw misję retain i zostaw wyodrębnianie w trybie concise (przez płaski sterujący lub API Banks). Po jawnym retain, otwórz UI, potwierdź obserwację i usuń błędy, zanim uruchomi się konsolidacja lub odświeżenie modelu umysłowego. Zostaw recall_prefetch_method na recall — reflect spędza wywołanie modelu czatu przed każdym obrotem i wstrzykuje syntezę zamiast leżących pod spodem faktów.
Połączenie agenta Hermes z Hindsight
Na VM Hermes, zainstaluj plugin z katalogu, a następnie uruchom kreatora konfiguracji. Wybierz Hindsight i tryb local_external; plugin nie musi uruchamiać wbudowanego PostgreSQL ani serwisować stosu modeli Hindsight lokalnie, a local_embedded uruchomiłoby drugiego demona Hindsight obok kontenera, który właśnie uruchomiłeś.
hermes plugins install hindsight
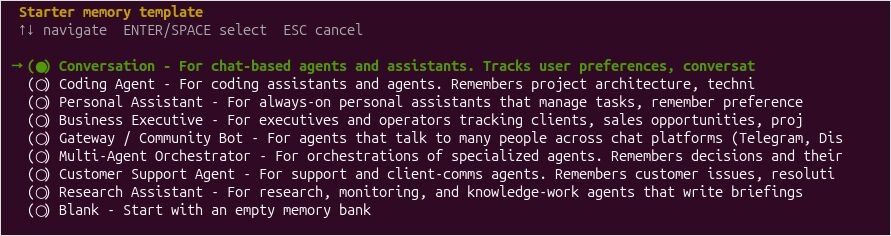
hermes memory setup hindsight
Będzie ciekawy zestaw opcji roli agenta używającej hindsight
hermes memory status
Zewnętrzne połączenie Hindsight znajduje się w ~/.hermes/hindsight/config.json. Przykładowa konfiguracja, która zachowuje ciągłe przechwytywanie (domyślne Hermes), to:
{
  "mode": "local_external",
  "api_url": "http://IP_VM_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Dla jawnego tylko retain i sterowania bankiem, użyj profilu higieny w sekcji Kontrola tego, co jest pamiętane zamiast zostawiania auto_retain włączonym. recall_sync: false priorytetyzuje interaktywną responsywność, ale może wstrzykiwać odzyskany kontekst w następnym obrocie. Używaj synchronicznego recall, gdy bieżący żądanie musi włączyć najnowsze pamięci, zanim model zacznie odpowiadać. retain_async: true unika blokowania zwykłych odpowiedzi, podczas gdy pamięci są przetwarzane.
Domyślny recall pluginu to tylko obserwacje; surowe fakty świata i doświadczenia pozostają w banku i poza promptem, dopóki konsolidacja nie zapisze obserwacji, lub dopóki nie poszerzysz recall_types do observation,world,experience. Poszerzenie go na pierwszy tydzień i obserwowanie płaskiego sterującego, a następnie zawężenie, to rozsądny porządek.
Wbudowana pamięć Hermes pozostaje aktywna obok dostawcy; zachowanie MEMORY.md i USER.md włączonych, podczas gdy uczysz się, co Hindsight dodaje, jest w porządku, a artykuł o systemie pamięci jest miejscem, w którym decydujesz, czy pliki płaskie powinny zostać.
Zrestartuj bramę, jeśli już działa:
hermes gateway restart
hermes memory status
Status powinien zidentyfikować Hindsight jako aktywnego dostawcę. Dla szerszej referencji komend, w tym TUI Hermes i komendy pluginów, zobacz ściągu CLI Hermes Agent).
Walidacja pamięci, a nie tylko instalacji
Poproś Hermes o zapamiętanie jednorazowego faktu o projekcie testowym, uruchom inną sesję i zapytaj o ten fakt ponownie. Retain jest asynchroniczny domyślnie i wyodrębnianie czeka na model czatu, więc daj głównemu serwerowi llama.cpp chwilę przed oceną. Następnie przetestuj trudniejszy przypadek: powiedz Hermesowi, że wcześniejsza decyzja się zmieniła i zapytaj, która decyzja jest aktualna i dlaczego. Sprawdź UI Hindsight i przechowywane obserwacje, zamiast zakładać, że memory status dowodzi poprawności ingestacji i recall.
Jeśli odpowiedź wróci pusta, przejrzyj płaski sterujący przed zmianą modeli. Retain może się powieść i nadal być niewidoczny dla recall, podczas gdy recall_types to tylko obserwacje i konsolidacja się nie uruchomiła — poszerzenie recall_types to pierwsza kontrola. Odmowa połączenia w logu serwera wektoryzacji oznacza, że kontener nie może osiągnąć portu wektoryzacji, a wszystkie zerowe punkty przestawiacza oznaczają, że GGUF to nieprawidłowa konwersja.
Wybory ścieżki zapisu (auto_retain, misje, brak zatwierdzania) są omawiane w Kontrola tego, co jest pamiętane.
Troubleshooting i notatki operacyjne
| Objaw | Prawdopodobna przyczyna | Pierwsza kontrola |
|---|---|---|
| Hermes mówi, że dostawca niedostępny | Zły adres URL local_external lub reguła sieci |
curl http://IP_VM_HINDSIGHT:8888/health |
| Docker startuje, błędy PostgreSQL | Brakujące rozszerzenie, złe poświadczenia lub niewystarczająca pamięć współdzielona | Logi kontenera i pg_extension |
| Wektoryzacja zwraca 401 lub 404 | Nieprawidłowy URL kompatybilny z OpenAI, zła nazwa klucza env lub niezgodność aliasu modelu | Bezpośredni test /v1/embeddings i nazwy zmiennych |
| Przestawianie zawodzi | Niezgodność punktu końcowego lub formatu odpowiedzi, w tym podwojona ścieżka /rerank |
Bezpośredni test /v1/rerank i log kontenera |
| Recall zwraca nic użytecznego | recall_types ograniczone do obserwacji, lub zerowe punkty przestawiacza |
Płaski sterujący, potem recall_types, potem konwersja przestawiacza |
| Istniejący bank zgłasza niezgodność wymiaru | Zmieniono model wektoryzacji | Przebudowa wektorów/przywrócenie z konsekwentnym modelem |
| Odpowiedzi Hermes zwalniają | Synchroniczny recall lub spór o wspólne LLM | Wyłącz synchroniczny recall; ogranicz równoległość retain |
| Nieistotne pamięci się powtarzają | Słabe wyodrębnianie, szumne wyszukiwanie lub niewystarczająca konsolidacja | Inspekcja obserwacji i ocen relewancji |
| Połączenie do PostgreSQL jest odrzucane | listen_addresses to nadal localhost, lub klient użył portu innego klastra |
ss -lntp na hoście bazy danych; restart tego klastra po zmianie listen_addresses |
brak wpisu w pg_hba.conf dla połączenia SSL |
Brak linii host lub hostssl dla adresu klienta, lub linia nie ma /32 i została pominięta |
Dodaj linię, przeładuj i przeczytaj log PostgreSQL |
pg_restore nie może otworzyć dumpu |
Użytkownik postgres nie może wejść do katalogu domowego trzymającego plik |
Skopiuj dump do /tmp i przywróć stamtąd |
musi być właścicielem rozszerzenia btree_gin |
COMMENT ON EXTENSION został wykonany jako rola aplikacji |
Przestrzeż pustą bazę danych i przywróć z --no-comments |
Zainstalowane pakiety PostgreSQL 18, pg_lsclusters pokazuje tylko 14 |
Nowa wersja główna nie tworzy klastra, gdy jeden już istnieje | sudo pg_createcluster 18 main |
Praktycznym małym wdrożeniem jest 2-4 vCPU i 4-6 GB RAM dla VM API Hindsight gdy PostgreSQL i całe wnioskowanie są zewnętrzne. Alokacja dysku zależy nadal od wybranego obrazu Docker i zachowanych warstw obrazu; przydziel około 30-40 GB początkowo z zapasem na rozszerzenie. Rozmiaruj hosta PostgreSQL w oparciu o rzeczywistą objętość pamięci, wydajność przechowywania i inne bazy danych, które obsługuje.
Kopia zapasowa i przywracanie banku Hindsight
Bank pamięci to jedyny stan, który ma znaczenie, i znajduje się w PostgreSQL. W Opcji B to baza danych, którą administrujesz; w Opcji A to wbudowany wolumen pg0 w kontenerze. Rób kopię niezależnie od kontenera Hindsight — ponowne utworzenie kontenera bez najpierw przechwycenia wolumenu lub bazy danych gubi bank, a hermes backup nie sięga do banku działającego w osobnej usłudze.
Opcja B — zewnętrzny PostgreSQL. Wykonaj dump bazy hindsight w formacie custom, a następnie przywróć go do bazy testowej, aby zweryfikować archiwum, zanim mu ufasz:
pg_dump -h IP_POSTGRES -U hindsight -Fc hindsight > hindsight-bank.dump

# przywróć do bazy testowej, aby udowodnić, że dump jest użyteczny
createdb -h IP_POSTGRES -U postgres hindsight-verify
pg_restore -h IP_POSTGRES -U postgres -d hindsight-verify hindsight-bank.dump
Potwierdź rozszerzenie pgvector i przykładowy recall w przywróconej kopii, zanim usuniesz cel oryginalnego dumpu. Przechowuj dump na innym hoście niż VM Hindsight i wykonuj to jako administrator PostgreSQL (rola, która może tworzyć bazy danych), a nie jako rola aplikacji.
Opcja A — jednolity kontener. Wbudowana baza danych to nazwany wolumen, więc zatrzymaj kontener i utwórz archiwum wolumenu przez wolumen jednorazowy:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Punkt montowania wewnątrz kontenera tar (/data) jest dowolny; po prostu aliasuje nazwany wolumen, tak aby tar mógł go odczytać. Aby przywrócić na ten sam wolumen, zatrzymaj kontener, wyczyść wolumen i rozpakuj archiwum z powrotem do niego. Przeniesienie tego banku na serwer, który administrujesz, to dump i przywracanie w Przeniesienie wbudowanej bazy danych na dedykowany serwer.
Rób migawkę w trzech momentach, a nie na harmonogramie kalendarzowym: przed zmianą modelu wektoryzacji, przed dużą aktualizacją Hindsight lub PostgreSQL, i przed przejściem reflect lub konsolidacji, które przepisuje bank. Kopia zapasowa, którą przywróciłeś do banku testowego, jest warta więcej niż ta, którą tylko zapisałeś.
Przeniesienie wbudowanej bazy danych na dedykowany serwer
Wbudowany bank to nazwany wolumen zamontowany w /home/hindsight/.pg0. Ustawienie HINDSIGHT_API_DATABASE_URL powoduje, że ten kontener otwiera bazę danych nazwaną w URL i wykonuje migracje. Wolumen pozostaje bez zmian. Przenieś wiersze przez pg_dump i pg_restore, a następnie zachowaj ten sam kontener i wskaż go na nowy serwer.
Przewodnik instalacyjny opisuje wbudowany pg0 i zewnętrzny URL jako dwa sposoby startu pustego serwera. hindsight-admin kopia zapasowa i przywracanie kopiuje tabele między bazami danych; restore wyzerowuje schemat docelowy i wymaga istnienia tabel najpierw. Eksport, import i migracja banku pamięci to zmiana modelu wektoryzacji: to archiwum pomija wektory i miejsce docelowe je przelicza. Przeniesienie zachowujące ten sam model wektoryzacji zachowuje wektory, a pg_dump to plik, który je przenosi.
Dopasowanie wersji głównej wewnątrz kontenera
pg0 nasłuchuje na 127.0.0.1:5432 wewnątrz kontenera. Jego binaria znajdują się pod /home/hindsight/.pg0/installation/<wersja>/bin, a dane klastra to /home/hindsight/.pg0/instances/hindsight/data. Rola, hasło i nazwa bazy danych domyślnie to hindsight. Odczytaj wersję serwera tym klientem. Jeśli ls /home/hindsight/.pg0/installation pokazuje inny build, użyj tego katalogu zamiast 18.1.0:
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/psql \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -c 'SHOW server_version;'
Dump w formacie custom z tego serwera przywraca się do tej samej wersji głównej lub nowszej. Aktualny obraz ghcr.io/vectorize-io/hindsight:latest zgłasza PostgreSQL 18.1. Pakiet archiwalny Ubuntu 22.04 to PostgreSQL 14, który nie może załadować archiwum 18.
Zainstaluj 18 z repozytorium Apt PostgreSQL obok klastra dystrybucji. Gdy 14/main już istnieje, pakiet postgresql-18 nie tworzy klastra:
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
sudo apt update
sudo apt install -y postgresql-18 postgresql-18-pgvector
sudo pg_createcluster 18 main
sudo pg_ctlcluster 18 main start
pg_lsclusters
pg_lsclusters powinien pokazać 18/main na następnym wolnym porcie, 5433, gdy 14 jest nadal na 5432. SELECT version(); na tym porcie powinien zgłaszać PostgreSQL 18. postgresql-contrib-18 to przejściowa nazwa pakietu: apt wybiera postgresql-18, a ten pakiet zawiera pg_trgm i btree_gin.
Utwórz rolę, bazę danych i rozszerzenia z Przygotowanie PostgreSQL i pgvector i przekazywać -p 5433 dla każdego psql, aby polecenia trafiły w klaster 18. Wbudowana baza danych ma vector, pg_trgm i btree_gin. Pakiet pgvector nowszy niż źródło, taki jak 0.8.7 na serwerze przeciw 0.8.5 w obrazie, nadal akceptuje dump.
Pozwól kontenerowi osiągnąć ten port
Nowy klaster nasłuchuje na localhost, dopóki listen_addresses w /etc/postgresql/18/main/postgresql.conf nie zawiera adresu LAN lub *. To ustawienie jest aplikowane przy starcie klastra 18, więc zrestartuj go przez sudo pg_ctlcluster 18 main restart i sprawdź ss -lntp dla 0.0.0.0:5433. „Odmowa połączenia” z innego hosta oznacza, że nic nie przyjmuje TCP na tym adresie i porcie.
W /etc/postgresql/18/main/pg_hba.conf, dozwól hostowi Hindsight. Maska jest częścią linii; bez /32 PostgreSQL pomija linię przy starcie.
host hindsight hindsight IP_HOST_HINDSIGHT/32 scram-sha-256
host pasuje do połączeń SSL otwieranych domyślnie przez klientów. Przeładuj przez sudo pg_ctlcluster 18 main reload. Adres w następującym błędzie „brak wpisu w pg_hba.conf … szyfrowanie SSL” to adres do wpisania w tę linię. Z Docker, ten adres to host uruchamiający kontener: most tłumaczy wychodzące połączenie kontenera na adres LAN hosta.
Dump, a następnie przywróć klientem 18
Wstrzymaj piszących, a następnie zrób dump binarią pg0. Wiersze zapisane po tym, jak pg_dump otworzył swoje snapshot, są nieobecne w archiwum.
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/pg_dump \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -Fc --no-owner --no-privileges \
  -f /tmp/hindsight-bank.dump

docker cp hindsight:/tmp/hindsight-bank.dump ./hindsight-bank.dump
Na hoście bazy danych, pg_restore musi być binarią 18. Klient 14 nie może odczytać tego archiwum. Najpierw skopiuj plik do /tmp. Użytkownik systemowy postgres nie może wejść do katalogu domowego innego użytkownika, więc pg_restore zgłasza „Odmowa dostępu” dla dumpu, który ls -l pokazuje jako czytelny dla świata.
sudo -u postgres /usr/lib/postgresql/18/bin/pg_restore \
  -p 5433 -d hindsight \
  --no-owner --role=hindsight --no-comments \
  --single-transaction --exit-on-error \
  /tmp/hindsight-bank.dump
--role=hindsight sprawia, że przywrócone tabele należą do roli aplikacji. --no-comments pomija COMMENT ON EXTENSION, który zawodzi z „musi być właścicielem rozszerzenia btree_gin”, gdy superuser stworzył rozszerzenie, a rola aplikacji nie. --single-transaction cofa nieudane załadowanie, więc następny przebieg zaczyna od pustego schematu. Częściowe załadowanie pozostawione przez wcześniejszą próbę wymaga DROP DATABASE i trzech poleceń CREATE EXTENSION ponownie przed ponowieniem.
Porównaj SELECT bank_id FROM banks ORDER BY 1 i SELECT count(*) FROM memory_units z takimi samymi zapytaniami wykonanymi wewnątrz kontenera przed przełączeniem.
Przełącz kontener i zachowaj wolumen
Dodaj URL do .env Compose z Opcji B, używając portu, który faktycznie zawiązał klaster 18:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:ZAKODOWANE_HASŁO@IP_POSTGRES:5433/hindsight
Przekazaj do środowiska usługi jako HINDSIGHT_API_DATABASE_URL: ${HINDSIGHT_API_DATABASE_URL}. Zachowaj HINDSIGHT_API_WORKER_ID bez zmian. Zostań na ghcr.io/vectorize-io/hindsight:latest, gdy usługa ustawia HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL lub HINDSIGHT_API_RERANKER_LOCAL_MODEL. latest-slim to obraz Opcji B dla punktów końcowych wektoryzacji i przestawiania działających poza kontenerem. Zostaw wolumen hindsight-pg0 zamontowany.
docker compose up -d ponownie tworzy kontener. Log powinien nazwać IP_POSTGRES w linii „Łączenie z bazą danych”, a curl -f http://localhost:8888/health powinno zawierać "database":"connected". GET /v1/default/banks wypisuje przywrócone banki. Wspomnij fakt, który już przechowywałeś. Opublikowane porty API i UI pozostają te same, więc Hermes i konfiguracja agenta kodującego zachowują istniejący adres bazowy.
Ponowny start bez HINDSIGHT_API_DATABASE_URL używa wolumenu, który nie otrzymał zapisów, gdy URL był ustawiony. Usuń wolumen po tym, jak ten recall się powiódł. Zawęź pg_hba.conf do jednej linii jednohostowej, gdy kontener połączył, i przeładuj.
Eksport, import i migracja banku pamięci
Przeniesienie wbudowanego banku na dedykowany serwer i zachowanie już przechowywanych wektorów jest omawiane w Przeniesienie wbudowanej bazy danych na dedykowany serwer. Kroki poniżej to zmiana modelu wektoryzacji.
Zmiana modelu wektoryzacji to nie edycja konfiguracji. Wektory w banku zostały obliczone starym modelem, a inny model — na przykład wbudowany 384-wymiarowy enkoder BGE wobec 1024-wymiarowego Qwen3-Embedding-0.6B — pisze w inną przestrzeń i zwykle inną szerokość. Nie możesz ponownie skierować istniejącej instancji na nowy enkoder i zachować starych wektorów; wymiary muszą zostać przeliczone przez re-wektoryzację każdej pamięci nowym modelem wektoryzacji.
Ponieważ enkoder i jego konfiguracja są ustawiane per instancja Hindsight, czystą ścieżką jest postawienie nowej instancji z nową konfiguracją wektoryzacji i migracja banku do niej, zamiast przebudowy wektorów wewnątrz tej, która już serwuje recall. API Hindsight może też przenieść bank, ale dla jednorazowej zmiany eksport/import jest łatwiejszą i bardziej przepytywalną drogą:
# eksportuj bank ze starej instancji
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# importuj bank do nowej instancji
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t weryfikuje archiwum, zanim wyślesz je do nowej instancji. Po imporcie, ponownie skieruj Hermes na api_url nowej instancji w ~/.hermes/hindsight/config.json, zrestartuj bramę i uruchom walidację pamięci z wcześniejszego: zachowany fakt powinien wspomnieć przez nowy enkoder. Zostaw stary bank i jego wektory w starej instancji, dopóki nowa nie działa, aby nadal mieć działający fallback.
Monitorowanie, przycinanie i zachowanie banku stabilnym
Gdy bank działa, codzienną robotą jest obserwowanie tego, co model wyodrębniający postanowił przechowywać i zachowywanie stanu wyprowadzonego pod kontrolą. Używaj UI płaskiego sterującego (hindsight-embed -p hermes ui start), aby inspektować obserwacje, oceny relewancji i wyjście konsolidacji, zamiast zakładać, że memory status dowodzi poprawności ingestacji i recall. Zduplikowane lub przestarzałe pamięci to zwykle słabe wyodrębnianie lub niedokładnie przebiegła konsolidacja, więc napraw poziom wyodrębniania lub częstotliwość konsolidacji przed poszerzaniem wyszukiwania.
Dwa pułapki utrzymania są warte testowania, zanim będziesz polegać na banku. Po pierwsze, usuwanie obserwacji nie gwarantuje, że każdy wyprowadzony reprezentant znika z nią — fakt reflect lub krawędź grafu zbudowana z niej może przeżyć usunięcie, więc zweryfikuj usuwanie od końca do końca, ten sam problem pochodzenia omawiany w samonapędzające pętle pamięci. Po drugie, zachowuj HINDSIGHT_API_WORKER_ID stabilne przy ponownych utworzeniach i przypnij konkretny tag obrazu: zadanie, które było w trakcie, gdy kontener padł, pozostaje zablokowane pod starym identyfikatorem pracownika, a ruchomy tag to kiepski wybór dla bazy danych, którą zamierzasz zachować.
