
Contexto Hierárquico: Uma Hierarquia de Conhecimento para Agentes de IA
Hierarquia de conhecimento em cinco camadas para memória de agentes.
Um agente com um único arquivo de memória plano não esquece coisas; ele não consegue parar de se lembrar de coisas sobre as quais não foi questionado. A solução é um contexto em camadas, onde cada camada de conhecimento entra por meio de um gatilho diferente.
O modo de falha não é o esquecimento, mas sim o oposto. Em um repositório único plano, todos os fatos vivem no mesmo lugar, entram no contexto da mesma maneira e, portanto, estão disponíveis da mesma forma — sempre. Pergunte ao agente sobre um e-mail de um cliente e ele narrará a configuração do roteador enquanto redige a resposta; peça que ele depure um serviço e ele mencionará a taxa de patrocínio cotada no mês passado. A pilha de memória é um monólito: qualquer mudança em uma preocupação afeta todas as outras, e o raio de impacto de cada consulta é todo o corpus.
O conselho padrão é comportamental: ensinar ao agente o que é relevante para o tópico atual. Isso é o equivalente de software de escrever “por favor, tenha cuidado” em uma parede que suporta carga — o agente pode ser instruído e, em grande parte, estará em conformidade, até o dia em que não estiver. A alternativa estrutural é um conhecimento que não pode entrar em uma conversa, a menos que a atividade que precisa dele já esteja em andamento. Este artigo define essa estrutura como uma hierarquia de conhecimento de cinco camadas — o que cada camada é, o que gatilha sua injeção, o que pertence a ela e onde ela falha — e aplica-a a uma configuração concreta de múltiplos domínios: um perfil geral, um para homelab, um para assuntos pessoais, um para o trabalho e um para educação.
Nomeando a hierarquia
Não existe um único termo padrão da indústria, portanto, a definição aqui é explícita. Uma hierarquia de conhecimento é um arranjo estratificado do que o agente sabe, onde cada estrato difere em três propriedades: como entra no contexto do modelo, quão grande é permitido ser e por quanto tempo se espera que permaneça correto. No nível de arquitetura de conhecimento, os paradigmas vizinhos — PKM, RAG, wikis e sistemas de memória — são comparados em PKM vs RAG vs Wiki vs Memory Systems, e os contratos de tempo de execução que os assistentes realmente implementam são mapeados em Sistemas de Memória em Assistentes de IA. Ambos estão dentro do cluster Gestão de Conhecimento, que cobre os fundamentos, métodos e ferramentas dos sistemas de conhecimento humano. Este artigo adiciona a classificação baseada em gatilhos e a fronteira do perfil que tornam o posicionamento aplicável.
Duas linhagens explicam a forma da hierarquia.
A primeira é a hierarquia de memória da CPU. Um processador não armazena cada byte de que ele pode precisar em algum momento no mesmo registrador. Ele tem cache L1 — pequeno, sempre residente, acessado com zero tomada de decisão — L2, memória principal e disco, cada camada maior, mais lenta para alcançar e acessada apenas quando as camadas superiores não têm a resposta. A regra de projeto não é “manter tudo rápido”. É a maioria dos dados raramente importa; pague o custo de acesso apenas quando importar. Um agente com um único arquivo de memória plano é uma CPU com tudo cravado no L1: o arquivo de registradores é enorme, então tudo é visível, incluindo os bytes que a instrução atual não pediu. MemGPT fez o mesmo movimento para agentes, modelando a memória como camadas com movimento explícito entre armazenamentos rápidos e lentos.
A segunda é a taxonomia de memória cognitiva, que divide o conhecimento em memória procedural (como fazer coisas), memória semântica (fatos sobre o mundo) e memória episódica (o que aconteceu, quando, para quem). A taxonomia importa porque os modos de falha diferem por tipo: conhecimento procedural que fica obsoleto é um bug no seu fluxo de trabalho, conhecimento semântico que fica obsoleto é um fato errado e conhecimento episódico que vaza é um incidente de privacidade. Uma hierarquia organizada por tipo de conteúdo, não por localização, diz-lhe quais falhas são perigosas.
O eixo organizador para este artigo não é nenhum dos acima. Classifique o conhecimento pelo que causa sua entrada no contexto. O gatilho de injeção é o mecanismo, e o mecanismo é o que você realmente pode fazer cumprir. Um sistema de agente oferece exatamente quatro gatilhos:
- Sempre. Injetado em cada turno, incondicionalmente.
- Gatilho de tarefa. Carregado quando a atividade atual corresponde a uma condição declarada.
- Recuperação semântica. Surgido quando a mensagem atual é semelhante a algo armazenado.
- Referência explícita. Buscada porque uma tarefa nomeia o arquivo ou a consulta.
Cada camada da hierarquia é definida por qual gatilho a alimenta. Esse é todo o design, e o resto deste artigo é uma elaboração de uma única tabela.
As cinco camadas
| Camada | O que é | Gatilho de injeção | Suporte típico | Disciplina de tamanho | Falha como |
|---|---|---|---|---|---|
| 0 — Identidade | Quem é o agente, como ele fala, o que ele não fará | Sempre | SOUL.md ou equivalente | Pequeno; muda raramente | Inchaço — a identidade se torna um repositório de fatos |
| 1 — Memória residente | Fatos duráveis que se aplicam a cada sessão | Sempre | MEMORY.md / USER.md ou equivalentes | Orçado em caracteres; denso em ponteiros | Monólito — fatos de domínio migram para dentro |
| 2 — Procedural | Como executar tarefas recorrentes, além de onde ficam seus dados | Gatilho de tarefa | Habilidades | Limitado por habilidade; procedimentos, não dados | Crescimento de dados — habilidades se tornam bancos de dados |
| 3 — Referência | O sistema de registro: tabelas, configurações, contratos, runbooks | Referência explícita | Arquivos, wiki | Ilimitado; pesquisável, versionado | Obsolescência — ninguém atualiza o registro |
| 4 — Memória recuperada | Fatos episódicos e relacionais: decisões, trocas, mudanças de estado | Recuperação semântica | Um backend de memória com recuperação (ex.: um banco vetorial/gráfico) | Orçado por recuperação; pontuável por tags | Vazamento — a recuperação traz o domínio errado |
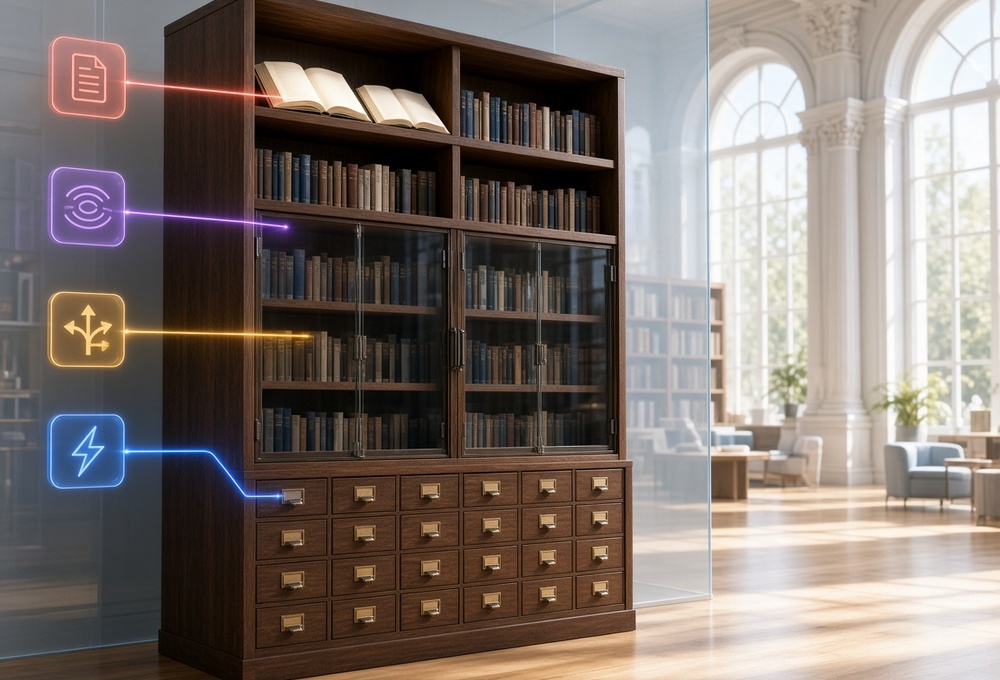
Leia a tabela pela coluna do gatilho, não pela linha. A Camada 0 e a Camada 1 são o cache L1: elas pagam pelo privilégio de sempre estarem residentes sendo minúsculas. A Camada 2 é o cache de instruções: puxada por uma condição de ramo, a tarefa correspondendo ao gatilho da habilidade. A Camada 3 é o disco: pode ser enorme porque nada entra no contexto até que uma etapa de uma tarefa leia explicitamente um arquivo nomeado. A Camada 4 é a desconfortável — é a memória principal, acessada por similaridade, que é o único gatilho da lista que não envolve uma decisão tomada por você ou pela tarefa. A similaridade é um portão probabilístico, e é por isso que ela precisa dos controles externos mais estritos, fornecidos pela seção de perfil. A imagem do armário no topo deste artigo codifica a mesma ideia: quanto mais alta uma camada está, mais livremente seu conteúdo entra em uma conversa, e a divisória de vidro marca onde a prateleira de um domínio termina.
Camada 0: identidade
SOUL.md, ou seja quer seu agente chama seu prompt de sistema. Seu trabalho é definir quem, não o que: tom, valores, limites de recusa e política de memória. A política de memória pertence aqui porque é a única instrução que deve estar em vigor antes que qualquer memória seja consultada. Um arquivo de identidade que começa a listar nomes de servidores, nomes de clientes ou taxas já falhou — ele se tornou conteúdo da Camada 1 usando o distintivo da Camada 0, e agora entra em cada conversa, incluindo aquelas onde não deve aparecer.
Camada 1: memória residente
Os arquivos de memória persistentes: notas gerais e o perfil do usuário. Duas regras governam esta camada, e são as regras que separam uma hierarquia funcional de uma pilha.
Primeiro, ponteiros, não fatos. Se um fato serve apenas a um domínio, ele não pertence aqui. A entrada correta não é o próprio fato, mas um ponto de referência:
Infra facts: wiki/infra/ + memory bank 'homelab'.
Clients and contracts: wiki/business/clients/ + bank 'business'.
O ponto de referência é neutro em relação ao domínio, portanto, é seguro carregá-lo em qualquer lugar. O fato ao qual ele aponta é carregado apenas pela atividade que nomeou o destino.
Segundo, um orçamento rígido, aplicado. Se o repositório não tiver um limite de caracteres, ele se enche, e o enchimento é sempre com o tópico discutido mais recentemente — então uma semana de infraestrutura desloca silenciosamente ou envolve o contexto geral com infraestrutura. Um orçamento quase cheio força o triagem, e a triagem é o único mecanismo que mantém esta camada honesta. A implementação Hermes é um exemplo funcional: MEMORY.md limitado a 2.200 caracteres e USER.md a 1.375, injetado como um bloco congelado no início da sessão, é documentado em Sistema de Memória do Agente Hermes.
Camada 2: conhecimento procedural
Habilidades são como o agente codifica como: o procedimento, as armadilhas e — criticamente para este artigo — os ponteiros para as camadas mais profundas. Uma habilidade para administração de homelab nomeia qual diretório de wiki contém o inventário e qual banco de memória recuperar. Uma habilidade para trabalho com clientes nomeia o repositório de contratos e o banco de negócios. A descrição da habilidade é seu gatilho: é a condição de ramo que decide se o procedimento e, portanto, seus ponteiros, entram no contexto.
Esta é a camada que faz a hierarquia funcionar operacionalmente, porque é a costura entre “qual atividade está acontecendo” e “quais dados essa atividade pode ver”. Uma tarefa sobre um e-mail de cliente carrega a habilidade do cliente; a habilidade do cliente nomeia o banco de negócios e o diretório de contratos; o banco de homelab e o diretório de infraestrutura simplesmente nunca são referenciados de um caminho que a tarefa percorreu.
O modo de falha é o crescimento de dados: colar a lista real de clientes ou a tabela real de IPs no corpo da habilidade. Então, os dados são sempre carregados sempre que o procedimento for, e o gatilho do procedimento se tornou o limite de exposição dos dados. Habilidades carregam o caminho para os dados, e nada mais que seja sensível.
Camada 3: dados de referência
A wiki, a árvore de notas, o sistema de registro. Esta é a camada com as menos restrições e as menos surpresas, porque é a única camada com um caminho de acesso determinístico: algo entra no contexto apenas porque uma etapa de uma tarefa leu explicitamente aquele arquivo. Tabelas, inventários, contratos, runbooks, estatísticas — a coisa que você manteria em um banco de dados ou em um sistema de gerenciamento de configuração. Quando o corpus é mantido por LLM, o padrão LLM Wiki se aplica: a síntese acontece no momento da ingestão e o resultado é armazenado como páginas estruturadas e interligadas.
A razão pela qual os dados de referência pertencem aqui e não na Camada 4 é que a qualidade de recuperação é a ferramenta errada para tabelas. A recuperação semântica é excelente para “o que o cliente X confirmou sobre o prazo” e terrível para “qual é a porta do serviço no host Y” — este último tem exatamente uma linha correta, e um reordenador retornando os três parágrafos mais próximos é um passivo. A consulta determinística vence para dados de referência; a similaridade vence para episódios. Mantenha-os separados, e o padrão de acesso de cada camada corresponde à forma de seu conteúdo.
O modo de falha é a obsolescência, que é um problema de manutenção, não de arquitetura: o registro se afasta da realidade e o agente, fazendo tudo certo, trabalha a partir de uma tabela errada. A mitigação é a mesma que qualquer sistema de registro precisa — um escritor por arquivo, logs de alteração e uma cadência de auditoria — mais as práticas de detecção de desvio e verificação de contradições cobertas em Manutenção da Wiki LLM: Desvio, Contradições e Revisão.
Camada 4: memória recuperada
Um backend de memória com recuperação automática por turno: a memória episódica e relacional do agente. Decisões e suas datas, “o cliente X confirmou Y”, “tentamos Z e não funcionou”. É aqui que vive a parte dinâmica e auto-organizável do sistema — e onde a história de segurança fica interessante, porque a recuperação semântica é um portão probabilístico e portões probabilísticos vazam.
“Questão de faturamento para o cliente X” e “qual host executa o servidor de faturamento” são próximos no espaço de incorporação. Qualquer banco único que contenha tanto os registros de clientes quanto o inventário de infraestrutura terá, com probabilidade não trivial, de trazer o último no primeiro. Você pode estreitar isso com tags e restrições de recuperação, e deve — mas um filtro de tag em um corpus misto é uma disciplina, não uma estrutura. A resposta estrutural é parar de misturar: um banco por domínio, para que o raio de vazamento de uma recuperação seja, por construção, um domínio. A escolha do próprio backend — política de captura, dependências, restrições de auto-hospedagem — é uma comparação separada, coberta em Provedores de Memória de Agente Comparados.
Dois detalhes mecânicos importam quando você liga esta camada. Os caminhos de escrita e leitura são controles separados: um banco pode estar incluído na recuperação sendo excluído da retenção, que é como você constrói um perfil que lê tudo e não escreve em nada. E cada banco deve carregar sua própria missão de retenção — uma declaração curta do para o que aquele banco existe. Um banco de negócios com a missão “correspondência de clientes, termos contratuais, estado de negociação; nunca detalhes de infraestrutura” extrairá de acordo, porque a extração é uma chamada de LLM que lê a missão. O cookbook de personalização da OpenAI trata a consolidação como a fase mais sensível e sujeita a erros de um ciclo de vida de memória — a missão de retenção é o contrato que mantém aquela fase honesta.
Perfis: a fronteira que torna a separação estrutural
Até aqui, a hierarquia separa o conhecimento por camada — necessário, mas não suficiente. As cinco camadas acima são a anatomia de um agente. A pergunta com que este artigo começou é sobre domínios: homelab, pessoal, trabalho, educação e o contexto geral que os abrange.
O mecanismo para a separação de domínios é o perfil — uma instância completa e independente do agente: seu próprio arquivo de identidade, sua própria memória residente, seu próprio diretório de habilidades, seus próprios trabalhos agendados e, decisivamente, seu próprio cabeamento de bancos de memória. Um perfil não é uma tag em uma conversa; é um sistema separado que acontece por compartilhar uma máquina. Quando você executa agent -p homelab, você obtém um processo cuja Camada 0 até a Camada 4 inteira é escopada para o domínio homelab, e cujo pool de recuperação não pode conter o banco de negócios porque o banco de negócios não está em sua configuração.
Esta é a diferença entre as duas respostas para o problema de vazamento. “Não divulque infraestrutura em conversas de negócios” é uma instrução de prompt — uma probabilidade. “O pool de recuperação do perfil de negócios não inclui o banco de infraestrutura” é uma configuração — uma garantia. A hierarquia diz-lhe o que vai para onde; a fronteira do perfil é o que torna o posicionamento intransponível a partir do interior da conversa.
O exemplo trabalhado, cinco domínios:
| comum (padrão) | homelab | pessoal | trabalho | educação | |
|---|---|---|---|---|---|
| Identidade (L0) | Base compartilhada + política de memória | Base + estrutura de “operador de infra” | Base + “privado, sem tom de negócios” | Base + “profissional, voltado para clientes” | Base + “professor, assuma nenhum conhecimento prévio” |
| Memória residente (L1) | Apenas ponteiros — para as quatro casas de domínio | Ponteiros de homelab, fatos de máquina | Ponteiros pessoais | Ponteiros de trabalho | Ponteiros de curso |
| Habilidades (L2) | Habilidades de fluxo de trabalho gerais | Habilidades de infra, habilidade de runbook, habilidade de monitoramento | — | Habilidade de operações de cliente, habilidade de abordagem | Habilidade de planejamento de lição |
| Referência (L3) | Índice compartilhado da wiki | wiki/infra/ | wiki/personal/ | wiki/business/clients/ | wiki/education/ |
| Banco retido (L4) | Nenhum (somente leitura) | banco: homelab | banco: pessoal | banco: negócios | banco: educação |
| Bancos somente de recuperação (L4) | homelab, pessoal, negócios, educação | — | — | — | — |
Duas células nessa tabela fazem o trabalho pesado.
A linha do banco do perfil comum é “nenhum, somente leitura”. A conversa geral é onde você faz perguntas transversais, então ela deve ser capaz de ver os fatos recuperados de todos os domínios — mas não deve escrever em nenhum deles. O papo em uma sessão geral é exatamente o material que você não quer extraído para a memória durável de um domínio, e o cabeamento somente de leitura remove a escolha do modelo completamente. Se o cabeamento do backend suportar listas de bancos somente de recuperação (separados de bancos de escrita), isso é uma linha de configuração por banco de domínio; se não suportar, o perfil comum recupera de um banco geral dedicado e você aceita uma visão transversal mais fraca.
As linhas de recuperação dos perfis de domínio estão vazias. Cada perfil de domínio vê exatamente um banco. O perfil homelab nunca recuperará um termo contratual de um cliente, não porque foi instruído a não fazê-lo, mas porque o termo não está no pool que ele consulta. Esta é a separação bidirecional pela qual todo o exercício é feito: funciona simetricamente por construção, sem nenhuma instrução envolvida em nenhuma direção.
Três consequências operacionais se seguem, e são por isso que a abordagem de perfil custa mais que a abordagem de agente único, mas vale a pena para qualquer pessoa cujos domínios são genuinamente distintos.
- O gatilho se torna a superfície. Se o trabalho de homelab acontece em um terminal que você inicia com
-p homelab, e o trabalho com clientes acontece em uma conta de mensagens roteada para o perfil de trabalho, então qual chapéu você está usando é uma propriedade de como você invocou o agente, não uma bandeira que você se lembra de declarar. A desinformação — acidentalmente executar tarefas de clientes no contexto de homelab — torna-se tão visível quanto executar o shell errado. - O trabalho agendado herda a fronteira. Os trabalhos cron e as subtarefas delegadas executam dentro do perfil que os possui. Uma verificação de infraestrutura noturna agendada no perfil homelab não pode fazer o conteúdo de negócios desviar para o banco homelab, porque ele nunca tem esse conteúdo.
- O sistema de arquivos é compartilhado, e esse é o limite honesto. Perfis separam contexto, não acesso. O terminal de cada perfil pode ler os arquivos de cada perfil; a fronteira protege conversas, não discos. Então, as camadas que contêm material genuinamente sensível precisam da própria disciplina: credenciais em um arquivo de ambiente ou em um cofre de segredos em vez de em texto simples da wiki, a wiki fora de qualquer repositório público e permissões por diretório onde o SO ajuda. Trate a fronteira do perfil como um firewall para contexto — excelente em seu trabalho — e não deixe que seja confundido com um para dados.
Bootstrap de uma pilha plana
A hierarquia é geralmente alcançada de baixo para cima: um agente que começou com um arquivo de memória e agora mantém tudo nele. A ordem da migração importa, porque cada etapa é barata apenas quando a anterior está concluída.
Primeiro, divida o pool de recuperação. Criar um banco de memória por domínio é uma mudança de configuração, não uma reescrita de conteúdo — e é o passo com a maior alavancagem, porque o vazamento de recuperação para de acontecer no dia em que os bancos se dividem. O conteúdo pode migrar depois; a fronteira não deve esperar por isso.
Segundo, orce a Camada 1. Defina um limite de caracteres para os arquivos residentes, depois audite o que já está neles em relação ao limite. Fatos específicos de domínio se tornam ponteiros para onde viverão; o que permanece é o que genuinamente se aplica a cada sessão.
Terceiro, dê um destino aos fatos degradados. Um diretório de wiki por domínio, com a disciplina de um escritor e log de alterações, recebe o que a Camada 1 libera. As habilidades pegam os ponteiros para isso por último, porque uma habilidade que nomeia um diretório que ainda não existe é pior que nenhuma habilidade.
Onde a hierarquia apodrece
A arquitetura é tão boa quanto sua manutenção, e cada camada apodrece de uma maneira característica.
A Camada 1 enche primeiro. É a camada com o caminho de escrita mais conveniente (“apenas lembre-se disso”), então é a primeira a acumular fatos de domínio disfarçados. O orçamento torna isso visível: quando o repositório estiver 90% cheio, audite-o por entradas que deveriam ser ponteiros. A correção é sempre o mesmo movimento — rebaixar fatos para a Camada 3, promover o ponto de referência.
A Camada 2 cresce em segundo lugar. Habilidades são onde procedimentos e dados querem viver juntos, porque “o procedimento referencia os dados constantemente” parece razoável no momento da escrita. A verificação é mecânica: se o corpo de uma habilidade contém uma tabela que é a fonte da verdade para algo, ela pertence à wiki, e a habilidade deve carregar um caminho.
A Camada 4 deriva silenciosamente. A memória recuperada é orientada para adição e auto-explicativa, então episódios obsoletos nunca são corrigidos, apenas ultrapassados. O preâmbulo de recuperação (“estas memórias são contexto histórico, não fatos verificados”) é a mitigação padrão. A mitigação mais limpa é a mesma usada pela Camada 3: quando um episódio se torna um fato durável (“o cliente assinou nesta data nestes termos”), ele é escrito no sistema de registro, onde é visível e editável, e o banco mantém apenas a narrativa. Uma variante mais afiada desse desvio — a própria inferência do agente escrita de volta como evidência — é trabalhada em Loop de Memória Auto-Reforçante em Agentes de IA.
Perfis se multiplicam. Cinco perfis é gerenciável; quinze é uma frota. A disciplina é que um novo perfil aparece apenas quando um novo domínio aparece — não para um novo projeto, uma nova ferramenta ou um novo humor. A separação em nível de projeto é para a estrutura de diretórios da camada de referência; a separação em nível de domínio é para perfis. Confundir os dois é como as pessoas acabam com um zoológico de perfis e sem uma história de recuperação clara.
A lição: uma regra de posicionamento
Coloque cada pedaço de conhecimento na camada mais rasa cujo gatilho corresponda à sua necessidade: fatos sempre necessários na memória residente como ponteiros, procedimentos em habilidades, dados de referência em arquivos, episódios em um banco — e coloque o banco de cada domínio atrás de um perfil que nenhum perfil de outro domínio possa recuperar. O agente então se comporta como um sistema bem projetado: o conhecimento certo está presente porque a atividade certa o solicitou, o conhecimento errado está ausente porque nada na conversa tinha um caminho para ele, e a única coisa que poderia forçar os dois juntos é uma mudança de configuração — algo que você faz deliberadamente e, portanto, pode ver quando acontece.
A pilha plana nunca foi uma falha de disciplina. Foi uma arquitetura onde cada fato compartilha um gatilho, e esse gatilho é “sempre”. Quebre o gatilho em pedaços, e os vazamentos deixam de ser uma questão do julgamento do modelo. Deixam de ser possíveis.
Referências
- PKM vs RAG vs Wiki vs Memory Systems — a comparação fundamental de repositórios de conhecimento pessoal, pipelines de recuperação e memória de agente
- Sistemas de Memória em Assistentes de IA — a pilha de memória de tempo de execução dentro da qual esta hierarquia está
- Recuperação vs Representação em Sistemas de Conhecimento — por que a forma do seu repositório determina o que ele pode responder
- Hub de Memória de Sistemas de IA
