
Roteamento de Modelos: Pare de usar um único modelo para tudo
O modelo certo para a tarefa certa.
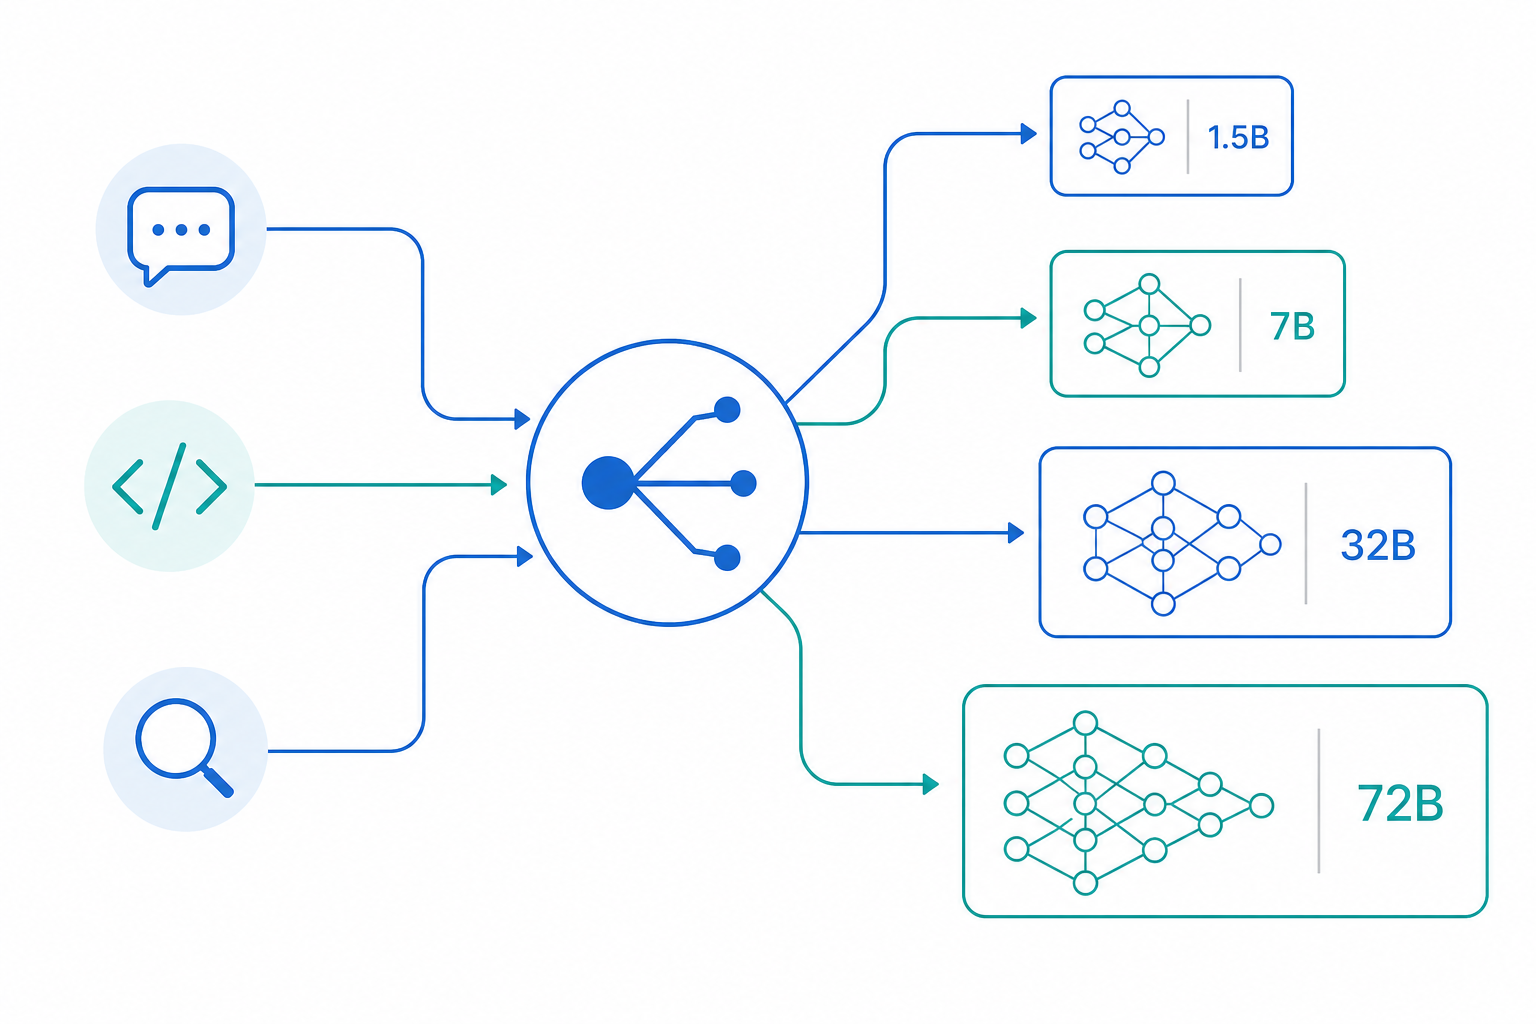
Executar um modelo com 70 bilhões de parâmetros para resumir um e-mail de 200 palavras é um desperdício. Executar um modelo de 3 bilhões para revisar código de produção é imprudência. A maioria dos sistemas vive em algum ponto intermediário — e é exatamente aí que entra o roteamento de modelos.
Ele corresponde a complexidade da tarefa à capacidade do modelo. As compensações são reais, mas as economias também.
O problema do roteamento
As pessoas geralmente começam com um único modelo e permanecem com ele. Isso funciona até você notar o custo, ou a latência, ou ambos. A alternativa é construir um roteador — algo que decide qual modelo lida com qual solicitação.
Quatro estratégias funcionam na prática:
- Baseada em capacidade — rotear com base no que o modelo consegue fazer
- Sensível a custo — rotear com base no que você está disposto a gastar
- Sensível a latência — rotear com base na rapidez necessária
- Híbrida — combiná-las
Cada uma otimiza algo diferente. Escolher uma geralmente é uma decisão sobre o que mais está causando problemas.
Roteamento baseado em capacidade
A abordagem mais simples. Classificar a tarefa e enviá-la ao modelo que a lida.
| Tarefa | Tamanho do modelo | Exemplos |
|---|---|---|
| Classificação, etiquetagem | 1-3B | Qwen3-1.7B, Gemma-2-2B |
| Resumo, extração | 3-7B | Qwen3-8B, Llama-3.1-8B |
| Geração de código | 7-14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| Raciocínio complexo | 14-32B | Qwen3-32B, Llama-3.1-70B |
| Escrita criativa, análise | 32B+ | Qwen2.5-72B, Claude, GPT-4 |
Se a tarefa não precisa do modelo maior, não o use. Um modelo de 1,5B lida bem com a classificação de sentimento. Ele simplesmente não escreveria um ensaio coeso.
A implementação é direta:
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
O porém está na classificação em si. Se você errar o tipo de tarefa, roteia para o modelo errado. Já vi sistemas classificar revisão de código como “resumo” e perder qualidade silenciosamente.
Roteamento sensível a custo
A inferência local brilha aqui. Modelos locais são efetivamente gratuitos após a amortização do hardware. Uma RTX 5080 se paga em cerca de seis meses com uso moderado de API.
| Modelo | Entrada (US$/M tokens) | Saída (US$/M tokens) | Custo local/hora |
|---|---|---|---|
| GPT-4o | US$ 2,50 | US$ 10,00 | — |
| Claude Sonnet 4 | US$ 3,00 | US$ 15,00 | — |
| Qwen2.5-72B (API) | US$ 0,50 | US$ 2,00 | — |
| Qwen3-32B (local) | US$ 0,00 | US$ 0,00 | ~US$ 0,10 |
| Qwen3-8B (local) | US$ 0,00 | US$ 0,00 | ~US$ 0,05 |
Se você está processando milhares de solicitações por sessão, mesmo US$ 0,05 de eletricidade batem US$ 15/M tokens.
O roteamento baseado em orçamento recua conforme você gasta:
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
A qualidade degrada à medida que você recua. Você começa com Claude, passa para o Qwen3-32B e depois para o Qwen3-8B. No final de uma sessão longa, a saída é visivelmente pior. Se isso importa depende do que você está construindo.
Rotear o tráfego de rotina para um modelo local, reservando a API para casos extremos, também traz um benefício secundário além do custo: impede que você caia naquele tipo de gravidade de dados, onde cada ajuste fino e banco de testes acaba moldado em torno da API de um único provedor.
Roteamento sensível a latência
Ferramentas interativas precisam de tokens iniciais rápidos. Jobs em lote podem esperar. A diferença geralmente é um fator de cinco no tamanho do modelo.
| Caso de uso | Token inicial | Completo | Tamanho máx. do modelo |
|---|---|---|---|
| Chat em tempo real | < 200ms | < 2s | < 7B |
| Ferramentas interativas | < 500ms | < 5s | < 14B |
| Processamento em lote | < 1s | < 30s | Qualquer um |
| Pesquisa/análise | < 2s | < 60s | Qualquer um |
Quando você está transmitindo tokens para um usuário, a latência do token inicial é o que ele sente. Um modelo de 32B que leva meio segundo para começar parece lento em comparação com um modelo de 1,5B que dispara instantaneamente.
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
Os números de latência são aproximados — dependem do seu hardware, quantização e tamanho do lote. Meça na sua própria configuração.
Estratégias de fallback
Modelos falham. APIs limitam a taxa de requisições. Tempos limite ocorrem. O padrão que funciona é uma cadeia de fallback, ordenada do melhor para o mais confiável:
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
O último modelo na cadeia deve ser local. Ele é mais lento, mas não falhará por causa de um problema de rede ou de uma chave de API.
Quando o roteamento ajuda
O roteamento faz sentido quando sua carga de trabalho é mista. Se você está fazendo classificação, resumo e raciocínio no mesmo sistema, um roteador economiza dinheiro e latência.
Não faz sentido quando tudo o que você faz tem a mesma complexidade. Use apenas o modelo que é bom naquela tarefa. O roteador adiciona complexidade que você não precisa.
A prototipagem inicial é outra razão para pular essa etapa. Faça a tarefa funcionar com um modelo e depois adicione o roteamento quando custo ou latência se tornarem realmente um problema.
Compensações
Cada estratégia de roteamento otimiza algo e sacrifica outra coisa:
- Modelo único — o mais simples, o mais caro, qualidade consistente
- Baseada em capacidade — custo melhor, qualidade maior por tarefa, complexidade moderada
- Sensível a custo — a mais barata, qualidade variável, complexidade moderada
- Sensível a latência — a mais rápida, pode sacrificar qualidade, complexidade moderada
- Híbrida — o melhor de tudo, a mais complexa de implementar
Sistemas de produção geralmente convergem para o híbrido. Comece com roteamento baseado em capacidade, adicione sensibilidade a custo quando a fatura chegar e adicione sensibilidade a latência quando os usuários reclamarem de lentidão.
Relacionados
- Otimização de Custos para Sistemas LLM — orçamentação de tokens, cache, modelos de fallback
- Guardrails de LLM na Prática — validação de entrada, filtragem de saída, segurança
- Design de Sistemas Multi-Modelo — arquitetura para múltiplos modelos
- LLMs de Decisão: Quando um Modelo Deve Decidir — e Quando Não — a taxonomia de papéis de decisão por trás da seleção de níveis, com escalonamento baseado em confiança
- Arquitetura de LLM — pilar de design de sistema: roteamento, custo, guardrails e orquestração
