
Design de Sistemas Multi-Modelo: Quando um Modelo Não É Suficiente
Escolha o padrão mais simples que funcione.
Sistemas de modelo único são simples. Sistemas mult模型 são poderosos. O desafio não está em escolher os modelos — está em projetar a arquitetura que os orquestra.
Um sistema mult模型 não se trata de ter mais modelos. Trata-se de ter o modelo certo para a tarefa certa, no momento certo.
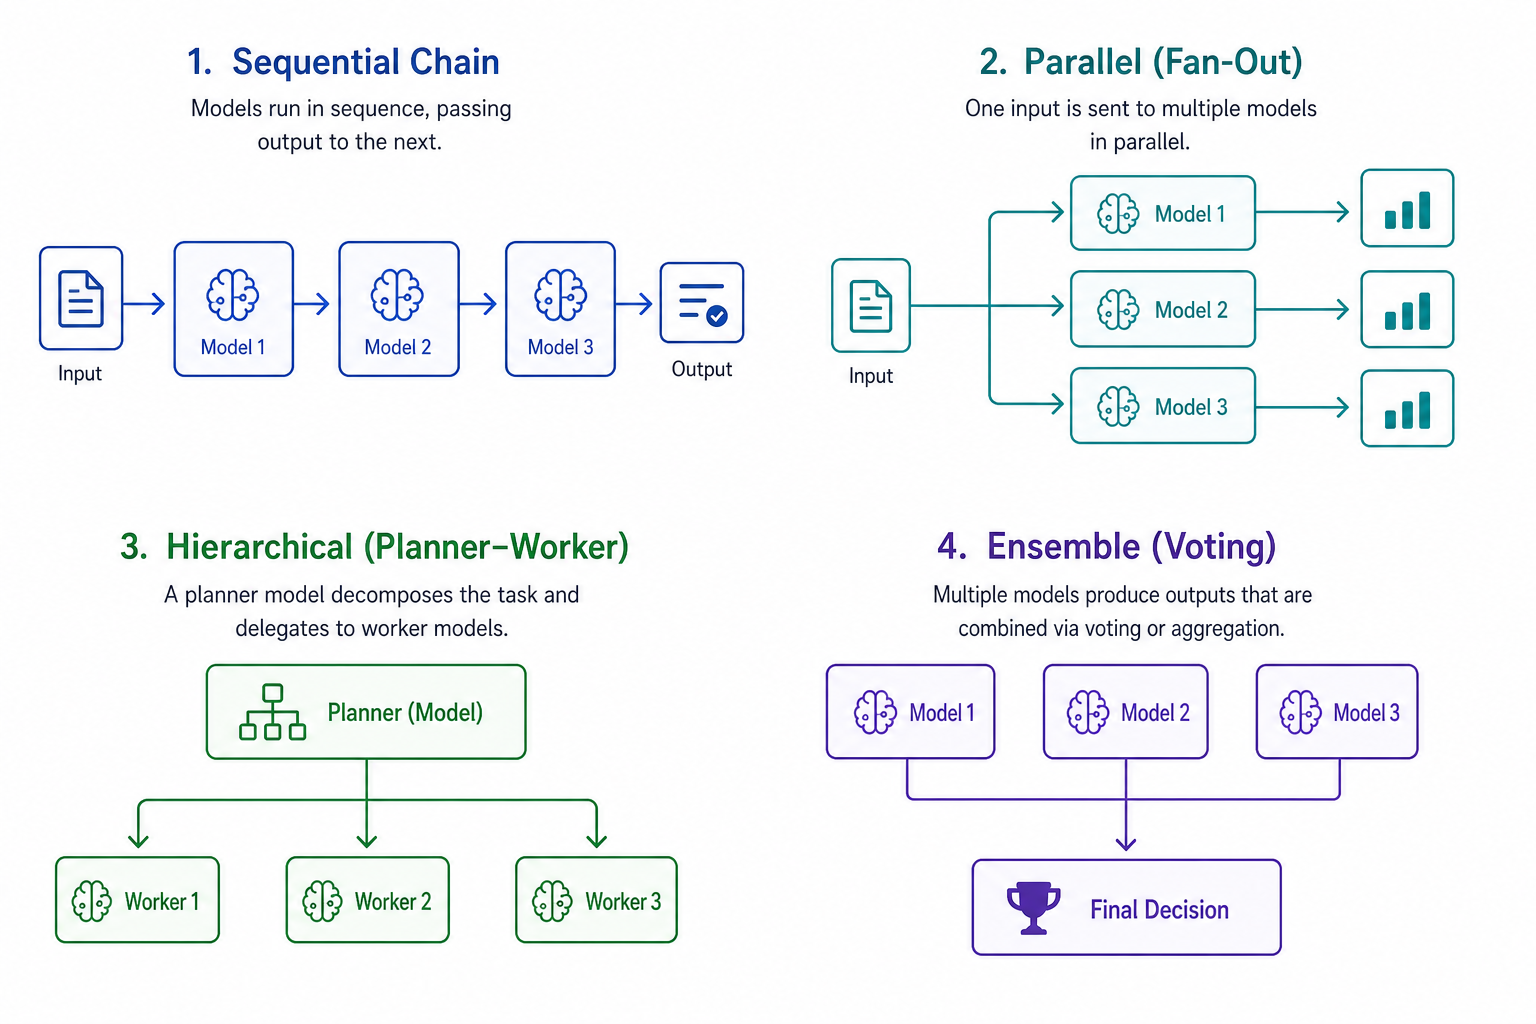
Padrões de arquitetura
Cinco padrões cobrem a maioria dos casos de uso:
| Padrão | Complexidade | Quando usar | Compromisso |
|---|---|---|---|
| Modelo Único | Mais baixa | Prototipagem, tarefas simples | Capacidade limitada |
| Sequencial | Baixa | Fluxos de trabalho com várias etapas | Latência mais alta |
| Paralelo | Média | Tarefas independentes | Custo mais alto |
| Hierárquico | Alta | Raciocínio complexo | Orquestração complexa |
| Ensemble | Mais alta | Decisões críticas | Custo mais alto |
Escolha o mais simples que funcione. A complexidade é real e se acumula.
Arquitetura sequencial
Processe as tarefas através de uma cadeia de modelos, cada um especializado em uma etapa.
Padrão 1: Pipeline
Padrão de pipeline — a saída de cada modelo alimenta o próximo:
class ModelPipeline:
    def __init__(self):
        self.models = [
            {"model": "qwen3-1.7b", "task": "classify"},
            {"model": "qwen3-8b", "task": "extract"},
            {"model": "qwen3-32b", "task": "reason"},
        ]

    def process(self, input: str) -> str:
        current = input
        for model_config in self.models:
            current = self.call_model(
                model_config["model"],
                self.create_prompt(model_config["task"], current)
            )
        return current
A latência se acumula. Três modelos em sequência significam três vezes a latência. Use isso apenas quando cada etapa realmente precisar de um modelo diferente.
Padrão 2: Roteador
Padrão de roteador — classifique a tarefa e roteie para o especialista:
class ModelRouter:
    def __init__(self):
        self.classifier = "qwen3-1.7b"
        self.specialists = {
            "code": "qwen2.5-coder-7b",
            "math": "qwen3-32b",
            "creative": "claude-sonnet-4",
            "general": "qwen3-8b",
        }

    def route(self, prompt: str) -> str:
        task_type = self.classify(prompt)
        model = self.specialists.get(task_type, self.specialists["general"])
        return self.call_model(model, prompt)
O classificador é o elo fraco. Se ele classificar incorretamente, você roteia para o modelo errado e perde qualidade. Use um classificador que seja bom o suficiente — mesmo um pequeno funciona se as categorias forem claras.
Arquitetura paralela
Processe tarefas independentes simultaneamente.
Padrão 1: Fan-Out
Fan-out — execute o mesmo prompt através de múltiplos modelos:
import asyncio

class ModelFanOut:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    async def process(self, prompt: str) -> list[str]:
        tasks = [self.call_model(model, prompt) for model in self.models]
        return await asyncio.gather(*tasks)
Útil para comparação, testes A/B ou quando você deseja escolher a melhor saída. Caro, mas o ganho de qualidade compensa para decisões críticas.
Padrão 2: Votação
Votação — combine as saídas através de consenso:
class ModelVoting:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    def vote(self, prompt: str) -> str:
        responses = [self.call_model(model, prompt) for model in self.models]
        from collections import Counter
        votes = Counter(responses)
        return votes.most_common(1)[0][0]
A votação por maioria funciona para classificação. Para tarefas de geração, é mais difícil — você precisa de similaridade semântica, não de correspondências exatas.
Arquitetura hierárquica
Use modelos em diferentes níveis de abstração.
Padrão 1: Planejador-Executor
Planejador-executor — um modelo forte planeja e modelos menores executam:
class PlannerExecutor:
    def __init__(self):
        self.planner = "qwen3-32b"
        self.executors = {
            "code": "qwen2.5-coder-7b",
            "search": "qwen3-8b",
            "math": "qwen3-8b",
        }

    def process(self, task: str) -> str:
        plan = self.call_model(self.planner, f"Plan: {task}")
        results = []
        for step in self.parse_plan(plan):
            executor = self.executors.get(step["type"], "qwen3-8b")
            result = self.call_model(executor, step["prompt"])
            results.append(result)
        return self.call_model(self.planner, f"Synthesize: {results}")
O planejador faz o trabalho pesado. Os executores lidam com tarefas específicas. Este padrão funciona bem quando a etapa de planejamento é cara, mas as etapas de execução são baratas.
Padrão 2: Supervisor-Trabalhador
Supervisor-trabalhador — um supervisor delega e revisa:
class SupervisorWorker:
    def __init__(self):
        self.supervisor = "qwen3-32b"
        self.workers = ["qwen3-8b", "qwen2.5-coder-7b"]

    def process(self, task: str) -> str:
        assignments = self.call_model(self.supervisor, f"Assign: {task}")
        results = []
        for assignment in self.parse_assignments(assignments):
            result = self.call_model(
                assignment["worker"], assignment["task"]
            )
            results.append(result)
        return self.call_model(self.supervisor, f"Review: {results}")
O supervisor é o gargalo. Ele planeja, delega e revisa. Certifique-se de que ele seja rápido o suficiente, ou o sistema inteiro ficará lento.
Arquitetura Ensemble
Combine múltiplos modelos para decisões críticas.
Padrão 1: Ensemble Ponderado
Ensemble ponderado — pontue a saída de cada modelo e escolha a mais alta:
class WeightedEnsemble:
    def __init__(self):
        self.models = {
            "qwen3-32b": 0.5,
            "claude-sonnet-4": 0.3,
            "qwen3-8b": 0.2,
        }

    def decide(self, prompt: str) -> str:
        responses = {
            model: self.call_model(model, prompt)
            for model in self.models
        }
        scores = {}
        for model, response in responses.items():
            score = self.evaluate(response) * self.models[model]
            scores[response] = scores.get(response, 0) + score
        return max(scores, key=scores.get)
Os pesos refletem sua confiança em cada modelo. Ajuste-os com base no desempenho real, não em benchmarks.
Padrão 2: Ensemble de Consenso
Ensemble de consenso — exija concordância, escale se não houver:
class ConsensusEnsemble:
    def __init__(self, threshold: float = 0.7):
        self.threshold = threshold
        self.models = [
            "qwen3-32b",
            "claude-sonnet-4",
            "qwen3-8b",
        ]

    def decide(self, prompt: str) -> str:
        responses = [
            self.call_model(model, prompt)
            for model in self.models
        ]
        from collections import Counter
        votes = Counter(responses)
        max_votes = max(votes.values())

        if max_votes / len(self.models) >= self.threshold:
            return votes.most_common(1)[0][0]

        return self.call_model("qwen3-32b", prompt)
O limiar controla quão rigoroso é o consenso. 0,7 significa concordância de dois terços. Diminua-o para decisões mais rápidas ou aumente-o para maior confiança.
Quando sistemas mult模型 fazem sentido
Sistemas mult模型 fazem sentido quando você tem cargas de trabalho mistas, precisa de alta qualidade para decisões críticas ou está otimizando para custo ou latência.
Eles não fazem sentido quando todas as tarefas têm complexidade semelhante, você está prototipando ou a simplicidade é mais importante do que a otimização.
A regra prática: comece com um modelo. Adicione mais quando você encontrar uma restrição real — custo, latência ou qualidade. Não projete complexidade antes de precisar dela.
Compromissos
| Padrão | Custo | Latência | Qualidade | Complexidade |
|---|---|---|---|---|
| Modelo Único | Mais baixo | Mais baixa | Variável | Mais baixa |
| Sequencial | Médio | Alta | Alta | Média |
| Paralelo | Alto | Baixa | Alta | Média |
| Hierárquico | Alto | Alta | Mais alta | Alta |
| Ensemble | Mais alto | Média | Mais alta | Mais alta |
Cada padrão troca algo. Escolha aquele que corresponda às suas restrições.
Relacionados
- Estratégias de Roteamento de Modelos — roteamento baseado em capacidade, ciente de custos e latência
- Otimização de Custos para Sistemas LLM — orçamento de tokens, modelos de fallback, cache
- Guardrails LLM na Prática — validação de entrada, filtragem de saída, segurança
- LLMs de Decisão: Quando um Modelo Deve Decidir — e Quando Não Deve — quais decisões um modelo pode tomar em uma orquestração e como verificá-las
- Arquitetura LLM — pilar de design de sistemas: roteamento, custo, guardrails e orquestração
- Padrões de Orquestração Multiagente — distinto do roteamento mult模型: esta cobertura trata como múltiplos agentes autônomos se coordenam, não como as tarefas são roteadas entre modelos
