
Perspectiva retrospectiva para Hermes Agent: Memoria autoalojada con modelos de lenguaje locales
Memoria persistente de Hermes en su propio hardware.
Un agente de IA autoalojado necesita algo más que una ventana de contexto larga. Necesita una forma de retener hechos útiles, recuperar decisiones anteriores y revisar lo que cree saber a medida que los proyectos evolucionan.
Hermes Agent viene con archivos de memoria integrados, pero un proveedor externo puede ofrecer una recuperación mucho más rica entre sesiones. Hindsight es una de las opciones más interesantes en ese espacio. Esta guía lo instala para Hermes sin inferencia en la nube, primero como un contenedor Docker todo en uno y luego contra un servidor PostgreSQL existente con puntos finales locales de modelos separados.
La guía cubre el despliegue, la elección y conexión de modelos locales de incrustaciones, reordenamiento y generativos, el control de lo que auto-retain escribe en el banco, la conexión de Hermes y la capa operativa: copias de seguridad, mover un banco integrado a su propio servidor PostgreSQL e higiene diaria del banco. Los ejemplos usan un esquema de puertos deliberado — 8080 para el servidor principal llama.cpp, 8081 para incrustaciones, 8082 para reordenamiento, 11434 para Ollama —, por lo que cámbialos a los puertos que ya uses y mantén los servidores pequeños fuera del puerto del modelo principal.
Qué hace Hindsight
Hindsight es un motor de memoria persistente para agentes con tres operaciones principales: retain (retener), recall (recordar) y reflect (reflexionar). Retain extrae y almacena información; recall combina la recuperación semántica, por palabras clave, por grafo y temporal; reflect sintetiza una respuesta a partir de memorias acumuladas. La consolidación en segundo plano puede convertir observaciones superpuestas en una capa de conocimiento más útil.
No es solo una base de datos de incrustaciones. Una base de vectores puede localizar pasajes similares, pero un sistema de memoria también debe preservar la cronología, los límites del proyecto, la evidencia contradictoria y los cambios en las decisiones. Esos modos de falla se exploran en bucles de memoria autorreforzantes.
Para el mercado en general, consulta comparación de proveedores de memoria para agentes. La memoria integrada MEMORY.md, USER.md y los modos de memoria de Hermes se cubren en la guía del sistema de memoria de Hermes Agent., por lo que este artículo asume que conoces cómo funciona la capa integrada.
Por qué avanzar más allá de Mnemosyne
Mnemosyne para Hermes. ofrece ideas atractivas centradas en lo local, incluyendo almacenamiento SQLite y recuperación híbrida. En la práctica, las restricciones de instalación, la compatibilidad de versiones, el comportamiento de aprobación de escritura y los cambios rápidos alrededor de sus versiones previas 4.0 pueden hacer que sea difícil operarlo de manera predecible. Esas son preocupaciones operativas, no evidencia de que el modelo de memoria de Mnemosyne sea fundamentalmente defectuoso.
Hindsight tampoco está libre de dependencias: su imagen Docker y los modelos locales pueden consumir espacio en disco considerable. Ejecutar su API como un servicio independiente, con la inferencia en otro lugar, mantiene las actualizaciones y la solución de problemas aisladas del propio agente.
Elige un despliegue
| Componente | A: Contenedor todo en uno | B: Servidor PostgreSQL existente |
|---|---|---|
| API y UI de Hindsight | Contenedor Docker | Contenedor Docker |
| PostgreSQL | pg0 integrado en el contenedor |
Máquina PostgreSQL existente |
| LLM generativo | llama.cpp externo | llama.cpp externo |
| Incrustaciones | Local predeterminado o externo | Ollama o llama.cpp externo |
| Reordenamiento | Local predeterminado o externo | Servidor de reordenamiento externo |
| Ideal para | Evaluación rápida | Instalación a largo plazo, aislada |
Aquí, “todo en uno” significa que la API, la UI y la base de datos de Hindsight están en un solo contenedor; el LLM de inferencia sigue alojándose en otro lugar. Esto es intencional: la imagen oficial de Hindsight de Docker no incluye un servidor llama.cpp generativo local listo para usar.
Usa direcciones alcanzables por LAN, no localhost, para servicios que se ejecutan en un host diferente. Restringe estos puertos a clientes de confianza; las claves dummy de ejemplo son marcadores de posición de compatibilidad, no autenticación.
Opción A: Contenedor Hindsight Todo en Uno
Esta es la forma más sencilla de evaluar Hindsight sin llenar la VM de Hermes con Python, Torch y dependencias de modelos locales. El contenedor ejecuta Hindsight y PostgreSQL integrado, mientras que tu LLM principal llama.cpp maneja la extracción de memoria y la reflexión.
Dos etiquetas de imagen importan aquí. ghcr.io/vectorize-io/hindsight:latest es la imagen grande — aproximadamente 9 GB en AMD64 — porque incluye un incrustador BGE, un reordenador MiniLM y PostgreSQL integrado. latest-slim es de aproximadamente 500 MB y espera que esos dos modelos estén en otro lugar, que es lo que quieres una vez que apuntes Hindsight a la configuración de incrustación y reordenamiento en “Sirve y conecta modelos locales”. Una vez que la comprobación de salud pasa, fija una etiqueta específica: una etiqueta que cambia es una mala opción para una base de datos que pretendes mantener.
Crea un directorio y un archivo Compose en el host de Hindsight:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # API de memoria
      - "9999:9999"  # UI de plano de control
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://IP_DEL_ESCRITORIO:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Reemplaza IP_DEL_ESCRITORIO con el host que ejecuta llama.cpp. En Linux, host.docker.internal se resuelve solo si el contenedor declara el mapeo host-gateway mostrado arriba; sin él, una URL base de http://host.docker.internal:8080/v1 no apunta a ninguna parte. La reserva de memoria compartida de 1 GB es particularmente útil para el indexado de PostgreSQL integrado; el valor predeterminado pequeño de /dev/shm de Docker puede causar fallos. Un volumen con nombre preserva la base de datos cuando el contenedor se recrea, y una alternativa de montaje vinculante debe ser propiedad del uid 1000, el usuario dentro de la imagen.
HINDSIGHT_API_WORKER_ID debería permanecer estable entre recreaciones — el valor predeterminado de Docker es el nombre de host del contenedor, y una tarea que estaba en medio de la ejecución cuando el contenedor murió se queda atascada bajo el antiguo id de trabajador.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Si tu versión de Hindsight instalada expone la salud en una ruta diferente, inspecciona http://localhost:8888/docs y los registros del contenedor. El plano de control normalmente está disponible en http://HOST_HINDSIGHT:9999. Una vez que el despliegue básico funcione, también puedes apuntar sus proveedores de incrustación y reordenamiento a la configuración en “Sirve y conecta modelos locales” en lugar de cargar los modelos predeterminados dentro del contenedor.
No expongas los puertos 8888 o 9999 directamente a internet. Usa una red privada o un proxy inverso autenticado. PostgreSQL integrado es conveniente para pruebas, pero una base de datos administrada externamente es más fácil de respaldar y mantener. Un banco que ya existe en este volumen se mueve con la descarga y restauración en Mover la base de datos integrada a un servidor dedicado.
Opción B: Hindsight contra un Servidor PostgreSQL Existente
Para una instalación a largo plazo, prefiero mantener la API de Hindsight, la base de datos y los puntos finales de inferencia separados. La VM de Hindsight puede permanecer pequeña porque ejecuta servicios de orquestación y HTTP en lugar de modelos pesados. Los pasos a continuación comienzan contra un servidor vacío. Un banco que ya vive en el volumen de la Opción A se mueve en Mover la base de datos integrada a un servidor dedicado.
Prepara PostgreSQL y pgvector
Hindsight necesita PostgreSQL 14 o más nuevo y una extensión vectorial en la base de datos hindsight. La extensión es por base de datos: instalar el paquete en el servidor no hace nada hasta que se ejecute CREATE EXTENSION allí. En un servidor PostgreSQL de Debian o Ubuntu, instala el paquete pgvector que corresponda a la versión principal real de PostgreSQL; por ejemplo, en PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
El nombre del paquete y su disponibilidad dependen de tus repositorios apt configurados. Si no está disponible, sigue las instrucciones de instalación de pgvector, o instala un paquete compatible del repositorio PostgreSQL PGDG. No cambies ciegamente la versión principal de PostgreSQL en un servidor compartido. En los paquetes PGDG de PostgreSQL 18, pg_trgm y btree_gin vienen dentro de postgresql-18. En los paquetes de la distribución están en postgresql-contrib para esa versión principal. La base de datos integrada usa ambas, más vector.
Crea un rol y una base de datos dedicados como administrador de PostgreSQL:
CREATE ROLE hindsight LOGIN PASSWORD 'REEMPLAZA_CON_CONTRA_SENA_LARGA';
CREATE DATABASE hindsight OWNER hindsight;
Conéctate a la nueva base de datos y habilita las extensiones:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS pg_trgm;'
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS btree_gin;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname IN ('vector','pg_trgm','btree_gin');"
Estas extensiones normalmente necesitan privilegios elevados para instalar; el rol de aplicación no necesita ser un superusuario. Hindsight usa pgvector por defecto y quiere 0.8.0 o más nuevo para escaneos ANN iterativos; los servidores antiguos rechazan esa configuración. HINDSIGHT_API_VECTOR_EXTENSION puede seleccionar en su lugar pgvectorscale (una opción DiskANN que Hindsight documenta para bancos muy grandes) o vchord, ambas de las cuales necesitan empaquetado extra en esta construcción exacta de PostgreSQL. Cambiar algoritmos después de que existan memorias detiene el inicio y pide una migración, así que elige antes del primer retain. Para un banco personal de Hermes, pgvector es el que debes instalar y luego dejar.
Permite solo el host de Hindsight a través de pg_hba.conf, por ejemplo:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Configura listen_addresses de PostgreSQL apropiadamente y usa TLS o una red privada de confianza para conexiones entre hosts. Haz una copia de seguridad de esta base de datos independientemente del contenedor Docker de Hindsight. Si el servidor se comparte con otras aplicaciones, mantén Hindsight en su propia base de datos, o configura HINDSIGHT_API_DATABASE_SCHEMA a un esquema que tú poseas; el esquema predeterminado es public.
Ejecuta Hindsight contra PostgreSQL
Crea compose.yaml en la VM de Hindsight. Esta versión deliberadamente no inicia PostgreSQL localmente:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://IP_DEL_ESCRITORIO:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Almacena la URL de la base de datos externa en un archivo llamado .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:TU_CONTRASENA@IP_POSTGRES:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Si tu contraseña contiene @, :, / u otros caracteres reservados de URL, codifícalos en URL antes de ponerlos en la cadena de conexión. Prueba que la VM de Hindsight pueda alcanzar el puerto 5432 de PostgreSQL, y que pg_hba.conf permita el host de Hindsight — un servidor vinculado solo a 127.0.0.1 rechaza la conexión incluso cuando la URL se ve bien. Permite que el primer inicio ejecute migraciones de base de datos; las migraciones se ejecutan en el inicio a menos que configures HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Con la API y la base de datos en marcha, continúa con Elige modelos para Hindsight y Sirve y conecta modelos locales antes de conectar Hermes.
Elige modelos para Hindsight
El despliegue pone la API y la base de datos en la red. La siguiente decisión es qué modelos llenan los tres roles de inferencia: incrustaciones para candidatos de recuperación, un reordenador para reordenarlos, y un LLM generativo para retener, reflexionar y consolidar. Un predeterminado práctico para un host Hindsight de CPU cuya GPU ya esté ocupada con la conversación es Qwen/Qwen3-Embedding-0.6B en proceso, BAAI/bge-reranker-v2-m3 en proceso, y un modelo de chat llama.cpp compartido para trabajo generativo.
Modelos de incrustación
Hindsight lee la dimensión de la incrustación al inicio y dimensiona el banco para que coincida, por lo que el modelo que elijas en el primer retain es el modelo que el banco mantiene hasta que lo reconstruyas. La dimensionalidad y el comportamiento de instrucción importan más que el rango en el tablero de clasificación: un incrustador 8B más fuerte no vale una migración si el banco ya es de 384 o 1024 dimensiones. Las filas de abajo se ordenan de la más ligera a la más pesada; las cifras de RAM son huella cargada aproximada en CPU (FP16 / carga local típica), no el tamaño del archivo GGUF.
| Modelo | Parámetros | Dim | Contexto | Cargado | Corre en | Notas |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Predeterminado de Hindsight; viene en hindsight:latest. Ruta local más rápida. La distribución de puntuación aún calibra muchos predeterminados de recall_min_scores después de que lo dejes. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | BGE inglés de gama media; fija un banco de 768 dim. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | MiniLM multilingüe documentado por Hindsight; 50+ idiomas con el mismo ancho de banco de 384-dim que BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | Predeterminado para el proveedor onnx; ruta CPU multilingüe ligera cuando tienes una exportación ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | Incrustador común de Ollama; contexto más largo que el BGE clásico, aún centrado en inglés. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 solo texto (deshabilita torres de visión/audición). 100+ idiomas + código; MRL trunca a 512/256/128; prefijos de instrucción para búsqueda vs documento. La carga multimodal completa es 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU o GPU | Codificador dual multilingüe fuerte; mismo ancho que Qwen3-0.6B, por lo que un cambio de misma dimensión aún necesita una re-incrustación completa. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | El predeterminado de esta guía. Consciente de instrucciones (instrucción de búsqueda en el lado de la consulta); cómodo en CPU. El proveedor local aplica la instrucción automáticamente; los servidores compatibles con OpenAI necesitan HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB cuant | GPU | Niveles de calidad Qwen3; fija un banco de 2560-dim. No viable cuando la GPU conversacional ya está saturada. |
Cómo se ejecuta el modelo es la otra mitad de la elección. Los proveedores de incrustación de Hindsight, del más sencillo al de más piezas móviles:
| Proveedor | Cómo se ejecuta | Mejor cuando | Notas |
|---|---|---|---|
local |
SentenceTransformers en proceso; sin sidecar | Host único de Hindsight, incrustador CPU | Ruta predeterminada. Configura HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Sin llama.cpp, Ollama o TEI. |
onnx |
ONNX Runtime en proceso | CPU más ligera que Torch; ya tienes una exportación ONNX | Necesita hindsight-api-slim[local-onnx] y HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Punto final externo compatible con OpenAI o HF TEI | Incrustaciones fuera del proceso de API; host GPU/CPU compartido | Lo que configura “Sirve y conecta modelos locales” para Ollama / llama.cpp / TEI. Solo vale la pena el sidecar si quieres aislamiento o una máquina diferente. |
Qwen3-Embedding-0.6B no necesita un servicio de incrustaciones externo. En un host Hindsight de CPU se carga dentro del proceso de API con el proveedor local — Hugging Face descarga los pesos en el primer inicio, y el proveedor aplica la instrucción de búsqueda del modelo él mismo:
# Entorno de Compose (o claves .env equivalentes)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Usa un punto final externo compatible con OpenAI solo cuando quieras el incrustador en otra máquina o fuera del proceso de API. Ollama es un host así:
# Incrustaciones: Qwen3-Embedding-0.6B en Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Reemplaza el host, puerto y etiqueta con lo que muestre ollama list en tu máquina de inferencia.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX depende del proveedor:
| Ruta | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Deja sin configurar / vacío — el proveedor en proceso aplica la instrucción de búsqueda de Qwen él mismo | Deja sin configurar / vacío |
| Ollama / llama.cpp / compatible con OpenAI externo | Instrucción de recuperación oficial de Qwen3 (nueva línea real antes de Query:) |
Deja vacío — las memorias almacenadas permanecen como texto sin formato |
| El servidor ya envuelve las entradas en la plantilla de Qwen | Deja ambos vacíos — de lo contrario, la instrucción se aplica dos veces | Deja vacío |
Para la ruta externa, configura:
# Nueva línea real antes de Query:. Bash $'...' es la forma confiable de pasarla.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
En Compose YAML la misma cadena necesita un \n explícito (o un valor multinivel literal). Configura los prefijos antes del primer retain: cambiarlos después significa que los vectores viejos y las nuevas consultas ya no están en el mismo espacio.
Dos propiedades deciden más que la posición en el tablero. Sensibilidad a instrucción: las incrustaciones de Qwen3 aplican una instrucción de búsqueda en el lado de la consulta; sin el prefijo coincidente en un servidor compatible con OpenAI, el lado almacenado y el lado de la consulta dejan de estar en el mismo espacio. Bloqueo de dimensión: porque el ancho se lee una vez al inicio, pasar de 0.6B a 4B después es una migración de banco, no un cambio de configuración — y aun un cambio de misma dimensión (BGE-M3 ↔ Qwen3-0.6B, o EmbeddingGemma 2 ↔ nomic en 768) cambia el espacio vectorial, por lo que los vectores del banco no se recalculan automáticamente. Planifica un banco nuevo o una re-incrustación/reindexado manual; consulta Exportar, importar y migrar el banco de memoria. Después de dejar BGE-small, sondea recall_min_scores contra la nueva distribución de puntuación — los umbrales calibrados en BGE-small pueden ser demasiado estrictos para Qwen3-0.6B y desnutrir al reordenador de candidatos. Para benchmarks y antecedentes de GGUF/Ollama de la familia Qwen3, consulta Modelos de incrustación y reordenamiento Qwen3 en Ollama.
Modelos de reordenamiento
Las incrustaciones recuerdan un conjunto de candidatos; el reordenador puntúa cada par consulta/pasaje y lo reordena antes de que Hindsight lo inyecte. Con el proveedor local, Hindsight carga un codificador cruzado SentenceTransformers (o un reordenador generativo donde esté soportado). Con un punto final externo compatible con Cohere, publica el cuerpo completo de estilo Cohere a HINDSIGHT_API_RERANKER_COHERE_BASE_URL. El reordenador es opcional, pero una vez que el incrustador está fijo suele ser la palanca más grande de calidad de recuperación — y, en CPU, a menudo la mayor parte del tiempo real de la recuperación. Las filas se ordenan de la más ligera a la más pesada.
| Modelo | Parámetros | Tipo | Contexto | Corre en | Notas |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Codificador cruzado | 128 | CPU | Predeterminado de Hindsight; viene en hindsight:latest. Sub-segundo para ~20 candidatos. Mantén como respaldo con nombre si un modelo BGE más pesado es demasiado lento. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Codificador cruzado | 512 | CPU | Misma familia, mayor precisión; aún con sesgo a inglés de MS MARCO. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Codificador cruzado | 512 | CPU | Reordenador MiniLM multilingüe documentado por Hindsight. |
BAAI/bge-reranker-base |
278M | Codificador cruzado | 512 | CPU | Mejora moderada sobre MiniLM; en/zh. Discutido a menudo; se omite cuando v2-m3 ya encaja en el presupuesto de latencia. |
BAAI/bge-reranker-v2-m3 |
568M | Codificador cruzado | 8k | CPU o GPU | Predeterminado multilingüe práctico en CPU. En un banco de ~500 memorias, ~2.6–2.8 s por recuperación en un piso de 20 candidatos (~140 ms/candidato; ~93–99% del tiempo de recuperación). Límites de candidatos 20/40/80; bajar el piso de 20 → 10 reduce a la mitad aproximadamente el costo de reordenamiento. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Generativo (sí-token) | 32k | Preferido GPU | Consciente de instrucciones, contexto largo. No es un codificador cruzado de inserción: necesita soporte de reordenador generativo reciente de SentenceTransformers, y la puntuación de /rerank de llama.cpp tiene errores conocidos de puntuación incorrecta (hindsight-benchmarks#11). Valida antes de adoptar. |
BAAI/bge-reranker-v2-gemma |
2.5B | Codificador cruzado | 8k | Preferido GPU | Calidad multilingüe fuerte; excesivo para un banco personal de unas pocas cientos de memorias cuando la GPU ya está llena. |
Qwen/Qwen3-Reranker-4B |
4B | Generativo | 32k | GPU | Candidato Qwen de mayor calidad; no viable sin VRAM dedicada. |
Qwen/Qwen3-Reranker-8B |
8B | Generativo | 32k | GPU | Nivel superior de la familia; mismas advertencias de puntuación generativa, aún más grande. |
Los reordenadores de API en la nube (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe, y similares) funcionan en Hindsight pero envían el texto de memoria fuera de la caja. Para un diseño local de solo dominio cruzado están fuera de alcance.
Dos restricciones operativas dominan la elección. VRAM: si el modelo conversacional ya satura la GPU (por ejemplo un Qwen3.8-27B Q5 en una tarjeta de 16 GB sin margen), cada fila “Preferido GPU” queda fuera de la mesa y la elección en vivo colapsa a MiniLM o BGE-v2-m3 en CPU. Conteo de candidatos: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 en el ejemplo de punto final externo a continuación) acota cuántos pasajes el modelo repuntúa; cada candidato es un paso de adelante completo, así que corta el piso antes de saltar un nivel de modelo. Para Qwen3 a través de llama.cpp, el GGUF debe mantener la cabeza de clasificación — un convert_hf_to_gguf.py antiguo que la descarta puntúa cada pasaje cerca de cero — e incluso una conversión correcta aún necesita una prueba de pasaje bueno/malo conocido hasta que se confirme la ruta de puntuación generativa.
Niveles de LLM generativo
Los modelos de incrustación y reordenamiento no son sustitutos del LLM generativo usado para extraer y razonar sobre memorias. Hindsight soporta un LLM predeterminado y sobrescrituras específicas de operación, que pueden apuntar al mismo servidor llama.cpp o a puntos finales independientes.
| Operación de Hindsight | Propósito | Nivel de modelo práctico | Ejemplos Qwen |
|---|---|---|---|
| Retain | Extraer hechos, entidades, decisiones y cronología | Mínimo 4B para pruebas; 9B preferido | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Recuperación semántica, por palabras clave, por grafo y temporal | No requiere LLM generativo | Qwen3-Embedding-0.6B + reordenador |
| Reflect | Responder preguntas sintetizando memorias recuperadas | 9B a 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidación | Reconciliar y comprimir hechos relacionados | 9B preferido | Qwen3.5-9B / Qwen3.8-27B |
| Actualización de modelo mental | Actualizar comprensión sintetizada de vida más larga | 9B a 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Estas son recomendaciones operativas, no conteos oficiales mínimos de parámetros de Hindsight. Un modelo pequeño puede extraer un número de puerto correctamente pero pasar por alto que una decisión arquitectónica anterior ha sido superada. La confiabilidad de la salida estructurada y el manejo fiel de la negación importan más que el conteo nominal de parámetros solo. Los valores predeterminados de temperatura propios de Hindsight valen la pena dejar solos — 0.1 para retain, 0.0 para consolidación, 0.9 para reflect — y para retain y consolidación, el alias no-pensante vale la pena servir si tu construcción llama.cpp tiene uno, porque los puntos de control pequeños de Qwen3.5 gastan muchos tokens en modo de pensamiento.
Para un despliegue con un punto final llama.cpp Qwen3.8-27B existente, comienza compartiéndolo entre tareas generativas de Hindsight con baja concurrencia:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://IP_DEL_ESCRITORIO:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Más tarde, dirige la extracción rutinaria a un modelo 9B independiente y reserva el 27B para reflexiones difíciles:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://HOST_LLM_MEMORIA:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://IP_DEL_ESCRITORIO:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
El modelo 4B más pequeño es económico pero necesita pruebas; 9B es un compromiso sensato de calidad/rendimiento. Si retain y consolidación comparten un modelo pequeño, baja HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE a 2 — el lote predeterminado de 8 es un prompt largo para una ventana de contexto pequeña. Qwen3.6-35B-A3B es atractivo para un servidor de inferencia separado y bien provisionado (es un modelo mezcla de expertos con aproximadamente 3 mil millones de parámetros activos, así que presupuestalo como un modelo activo pequeño), mientras que un modelo denso de 27B suele ser innecesario para cada evento rutinario de retain. Limitar la concurrencia en segundo plano protege al modelo conversacional de Hermes de ráfagas de mantenimiento de memoria.
Sirve y conecta modelos locales
Si las configuraciones de incrustación y reordenador local en proceso en “Elige modelos” son suficientes, puedes omitir los subapartados externos de Ollama y llama.cpp y saltar a la conexión — o dejar Compose en los predeterminados local mostrados allí. Los puntos finales externos importan cuando el incrustador o el reordenador deberían vivir en otro host.
Incrustaciones externas: Ollama o llama.cpp
Las incrustaciones externas son para cuando quieres Qwen3-Embedding-0.6B (u otro modelo) en un host separado. Dos opciones prácticas son Ollama, que maneja la adquisición y el servicio del modelo con poca configuración, y llama.cpp, que da control preciso sobre la cuantización GGUF, los hilos de CPU, la colocación de dispositivos y el lote. El fondo y los benchmarks de ambos modelos Qwen3 están en Modelos de incrustación y reordenamiento Qwen3 en Ollama.
Qwen3-Embedding-0.6B devuelve vectores de 1024 dimensiones, y Hindsight lee ese ancho al inicio y dimensiona la base de datos para que coincida. Un banco creado con el modelo BGE de 384 dimensiones incluido no puede aceptar este modelo — comienza desde una base de datos o volumen vacío, y decide el modelo de incrustación antes del primer retain. Un cambio de proveedor de incrustaciones más tarde requiere re-incrustar registros almacenados incluso si ambos modelos usan la misma dimensionalidad.
Opción 1: Ollama para Qwen3-Embedding-0.6B
Instala Ollama en el host de inferencia usando su documentación oficial de instalación para Linux, luego inicia el modelo de incrustación:
ollama pull qwen3-embedding:0.6b
ollama serve
Para acceso remoto, configura OLLAMA_HOST=0.0.0.0:11434 de Ollama en su entorno de servicio, reinicia el servicio y ponlo en el cortafuegos hacia la VM de Hindsight — el procedimiento se cubre en Acceso remoto a Ollama. Un demonio vinculado solo a 127.0.0.1 es invisible para el contenedor de Hindsight. Primero verifica el nombre del modelo con ollama list, y prueba el punto final estándar de incrustación:
curl http://HOST_INCUSTACION:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"Una memoria de prueba"}'
El proveedor de incrustaciones OpenAI de Hindsight en su lugar llama al punto final /v1/embeddings compatible con OpenAI de Ollama. Verifica que ese punto final funcione con tu versión de Ollama antes de configurar Hindsight. Ollama es sencillo para incrustaciones; no asumas que su API ofrece un punto final de reordenamiento compatible. Para reordenamiento, prefiere la ruta local BGE en proceso a continuación, o un punto final separado de llama.cpp / TEI después de que hayas validado las puntuaciones.
Opción 2: llama.cpp para Qwen3-Embedding-0.6B
Descarga una conversión Qwen3-Embedding-0.6B GGUF verificada. Usa el nombre de archivo GGUF que realmente descargaste:
#!/bin/sh
# start-embedding.sh - servidor de incrustación solo CPU
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Las incrustaciones de Qwen3 usan agrupación de último token, a diferencia de la agrupación CLS usada por algunos modelos BGE. Una construcción llama.cpp solo CPU es preferible si quieres absolutamente ninguna inicialización de CUDA en una estación de trabajo cuya GPU esté ocupada por un modelo conversacional grande. No habilites --reranking en este servidor de incrustación: esa combinación es una forma conocida de obtener un vector de ceros.
curl -s http://HOST_INCUSTACION:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"Una memoria de prueba"}' \
  | jq '.data[0].embedding | length'
Una salida de dimensión completa de Qwen3-Embedding-0.6B debería contener 1024 flotantes. Verifica que la conversión GGUF y tu manejo de instrucción consulta/documento de Hindsight sean compatibles; los modelos de incrustación sensibles a instrucciones pueden perder precisión cuando se les da el prompt incorrectamente.
Reordenador: BGE local o Qwen3 vía llama.cpp
El reordenamiento es diferente de las incrustaciones: el modelo puntúa cada par documento/consulta y devuelve una puntuación de relevancia. En un host Hindsight solo CPU — o siempre que la GPU conversacional no tenga margen de VRAM — la ruta práctica es el proveedor local de Hindsight con BAAI/bge-reranker-v2-m3 (o el predeterminado MiniLM más ligero). No se requiere un sidecar:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B es un puntuador generativo de token sí, no un codificador cruzado clásico. Puede servirse a través de llama.cpp con una conversión GGUF diseñada para clasificación, pero trata esa ruta como experimental hasta que confirmes puntuaciones en un par bueno/malo conocido: un convert_hf_to_gguf.py antiguo que descarta la cabeza de clasificación puntúa cada pasaje cerca de cero, y la ruta nativa /rerank de llama.cpp tiene informes conocidos de puntuaciones incorrectas para esta familia.
#!/bin/sh
# start-reranker.sh - GPU o CPU según lo seleccionado por --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Configura --n-gpu-layers 0 para ejecutarlo en CPU. La versión GPU necesita VRAM adicional para búferes de cómputo y contexto, no solo pesos del modelo; evita asumir que el tamaño del archivo es la asignación total de GPU.
curl -s http://HOST_REORDENAMIENTO:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"Almacenamiento PostgreSQL", "documents":["Hindsight almacena memorias en PostgreSQL.","Una receta para pan."], "top_n":2}' \
  | jq
El documento de PostgreSQL debería clasificarse por encima del documento no relacionado; las puntuaciones de relevancia todas en cero significan que el GGUF es la conversión incorrecta, y la recuperación se verá aleatoria incluso cuando los hechos estén almacenados. Verifica la forma exacta de results[].index y results[].relevance_score: Hindsight espera una respuesta de reordenamiento compatible con Cohere, y la compatibilidad de llama.cpp puede variar entre construcciones.
Conecta puntos finales a Hindsight
Añade las siguientes configuraciones de entorno al servicio Compose de Hindsight, o almacénalas en su archivo .env. Elige una ruta de incrustaciones — local en proceso, Ollama, o llama.cpp — nunca dos a la vez.
# Opción A: Qwen3 en proceso en el host de Hindsight (CPU; sin sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Opción B: servicio de incrustación llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://HOST_INCUSTACION:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opción C: Ollama en otro host
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opción: reordenador BGE local (sin sidecar; preferido en CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Opción: punto final de reordenamiento compatible con Cohere de llama.cpp (valida puntuaciones Qwen3 primero)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://HOST_REORDENAMIENTO:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Los nombres de variables son específicos del proveedor, y un error cercano es silencioso: HINDSIGHT_API_EMBEDDINGS_BASE_URL es la clave incorrecta, y Hindsight apunta en silencio al punto final de incrustación propio de OpenAI en lugar de tu servidor local. Usa HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. Con la ruta de reordenador compatible con Cohere, Hindsight publica el cuerpo completo de estilo Cohere a HINDSIGHT_API_RERANKER_COHERE_BASE_URL; si el registro del contenedor muestra un 404 para /v1/rerank/rerank, tu construcción añade /rerank por su cuenta y el valor debería detenerse en /v1.
Para las Opciones B y C, usa el valor de HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX de Modelos de incrustación (la Opción A lo deja sin configurar). Prueba la recuperación de consulta a pasaje en tus memorias reales después del primer retain.
Controla lo que se recuerda
Con la pila en marcha, el siguiente modo de falla suele ser la ruta de escritura: Hermes predetermina a auto_retain: true, así que cada turno de conversación puede ser extraído al banco. Suposiciones incorrectas, planes descartados y declaraciones exploratorias se convierten en hechos buscables, y la recuperación posterior los trata como evidencia — el bucle descrito en bucles de memoria autorreforzantes. La política de captura para Hindsight entre otros proveedores se resume en comparación de proveedores de memoria para agentes.
Modos de captura que existen hoy
No hay un interruptor de Hermes o Hindsight llamado “síntesis de sesión”. El plugin o retiene automáticamente turnos de conversación crudos (opcionalmente por lotes) o espera por una llamada de herramienta explícita hindsight_retain con el content que le des.
| Modo | Configuraciones de Hermes / Hindsight | Lo que obtienes |
|---|---|---|
| Continuo | auto_retain: true, retain_every_n_turns: 1 |
Cada turno se retiene y extrae como texto de transcripción |
| Auto por lotes | auto_retain: true, sube retain_every_n_turns |
Los turnos se almacenan en el plugin; cada N-ésimo turno envía un payload de retain más grande de esos turnos crudos — aún extracción automática, no un resumen curado |
| Solo explícito | auto_retain: false + herramienta hindsight_retain |
Nada se almacena hasta que el agente llama la herramienta con content (y opcionalmente context / tags) |
El auto por lotes no es un resumen de sesión. Con retain_every_n_turns > 1, el plugin de Hindsight de Hermes acumula turnos en memoria y los retiene como JSON de conversación; en /new, /reset, /branch, y conmutaciones de sesión similares, descarga cualquier búfer restante bajo el documento de sesión antiguo. No hay un sintetizador de fin de sesión dedicado, y la desinstalación de sesión inactiva históricamente ha podido soltar un búfer no descargado cuando N > 1 (sin gancho on_session_end en el plugin). Prefiere N: 1 a menos que aceptes esa desventaja.
El “recuerda esta sesión” curado es un patrón de prompt + herramienta, no un flag de configuración. Configura auto_retain: false, luego pide a Hermes que resuma las decisiones duraderas y llame a hindsight_retain con ese texto — o llama la herramienta tú mismo a través de la ruta de herramientas del agente. El reflect y la consolidación del banco son operaciones separadas del servidor Hindsight que sintetizan desde lo que ya está en el banco; no reemplazan una escritura de fin de sesión, y no se habilitan con una clave config.json de Hermes.
Configurar auto_retain en false deshabilita el almacenamiento automático de turnos. No agrega un diálogo de aprobación humana antes de cada escritura. El agente aún puede llamar a hindsight_retain cuando sus herramientas lo permitan; trata el retain explícito como captura deliberada, no como una cola pendiente.
El hueco de la cola de aprobación
Un deseo común es una cola pendiente de memorias candidatas que revisas y apruebas antes de que entren al banco. Hindsight bajo Hermes no proporciona ese contrato hoy. Mnemosyne para Hermes. implementa escrituras escalonadas específicas del proveedor en algunas versiones; esa ruta no es un estándar compartido de Hermes y no se aplica al plugin de Hindsight. Hasta que exista un flujo de aprobación aguas arriba, el patrón viable es auto_retain: false, hindsight_retain deliberado, e inspección o eliminación en la UI del plano de control de Hindsight antes de que la próxima sesión dependa de un hecho malo. No hay una clave write_approval perdida para Hindsight que buscar en config.json.
Dirección del banco (misiones, etiquetas, directivas, modelos mentales)
La gente a menudo llama a la siguiente capa “ajuste fino”. En Hindsight es mayormente configuración del banco, no solo config.json de Hermes: las misiones y configuraciones de extracción dirigen qué retiene el retain; las etiquetas estructuran entidades; las directivas y modelos mentales forman la síntesis posterior.
| Control | Dónde vive | Cómo ayuda |
|---|---|---|
Misión de retain (retain_mission / bank_retain_mission de Hermes) |
Configuración del banco | “Presta atención a X, ignora Y” en lenguaje llano inyectado en la extracción |
Modo de extracción (concise, verbose, custom, …) |
Configuración del banco | concise (predeterminado) mantiene hechos dignos de largo plazo; custom reemplaza reglas integradas vía retain_custom_instructions |
| Etiquetas de entidad | Configuración del banco | Vocabulario controlado clave:valor en el momento del retain → enlaces de grafo y etiquetas opcionales; mejora la estructura de recuperación, no rechaza por sí solo declaraciones erróneas |
| Directivas (“reglas duras”) | API de directivas del banco | Instrucciones explícitas aplicadas durante reflect (alcance de etiqueta); restringen la síntesis, no una puerta de aprobación de escritura |
| Modelos mentales | API de modelo mental del banco | Respuestas permanentes a preguntas recurrentes, actualizadas vía reflect desde memorias coincidentes; derivado, por lo que los hechos fuente malos aún los envenenan |
| Misión de reflect / observaciones | Configuración del banco | Dirige la síntesis y la consolidación, no la manguera de fuego cruda de retain |
Las misiones, la extracción concisa y las etiquetas reducen el ruido y mejoran la recuperación. No reemplazan apagar el auto-retain cuando la precisión importa más que la completitud. Prefiere una misión de retain corta que nombre decisiones duraderas del proyecto e ignore la logística del chat; añade etiquetas de entidad solo cuando tienes una taxonomía real; añade modelos mentales para dos o tres preguntas recurrentes después de que el banco ya contenga hechos limpios.
Perfil de higiene recomendado
Un punto de partida concreto para un banco personal de Hermes:
{
  "mode": "local_external",
  "api_url": "http://IP_VM_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
En el banco, configura una misión de retain y deja la extracción en modo concise (vía el plano de control o la API de Bancos). Después de un retain explícito, abre la UI, confirma la observación, y elimina errores antes de que la consolidación o la actualización del modelo mental se ejecute. Deja recall_prefetch_method en recall — reflect gasta una llamada del modelo de chat antes de cada turno e inyecta síntesis en lugar de hechos subyacentes.
Conecta Hermes Agent a Hindsight
En la VM de Hermes, instala el plugin del catálogo, luego ejecuta el asistente de configuración. Selecciona Hindsight y el modo local_external; el plugin no necesita iniciar PostgreSQL integrado o ejecutar la pila de modelos Hindsight localmente, y local_embedded iniciaría un segundo demonio de Hindsight junto al contenedor que acabas de ejecutar.
hermes plugins install hindsight
hermes memory setup hindsight
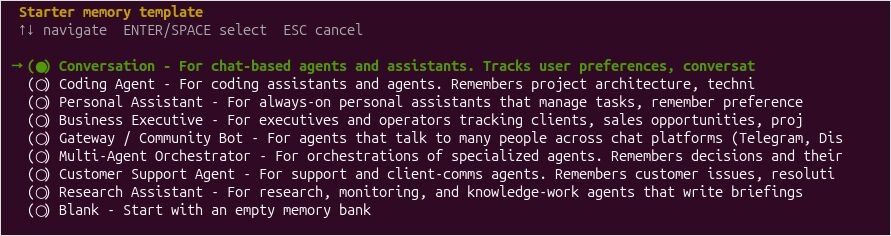
Habrá un conjunto interesante de opciones de rol de agente usando hindsight
hermes memory status
La conexión externa de Hindsight vive en ~/.hermes/hindsight/config.json. Una configuración ilustrativa que mantiene la captura continua (predeterminados de Hermes) es:
{
  "mode": "local_external",
  "api_url": "http://IP_VM_HINDSIGHT:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Para retain solo explícito y dirección del banco, usa el perfil de higiene en Controla lo que se recuerda en lugar de dejar auto_retain encendido. recall_sync: false prioriza la respuesta interactiva pero puede inyectar contexto recuperado en el turno siguiente. Usa recuperación síncrona cuando la solicitud actual debe incorporar las memorias más recientes antes de que el modelo comience a responder. retain_async: true evita bloquear respuestas ordinarias mientras se procesan memorias.
El predeterminado de recuperación del plugin son solo observaciones; los hechos crudos de mundo y experiencia permanecen en el banco y fuera del prompt hasta que la consolidación haya escrito una observación, o hasta que amplíes recall_types a observation,world,experience. Ampliarlo durante la primera semana y observar el plano de control, luego estrecharlo, es un orden razonable.
La memoria integrada de Hermes permanece activa junto al proveedor; mantener MEMORY.md y USER.md encendidos mientras aprendes lo que Hindsight añade está bien, y el artículo del sistema de memoria es el lugar para decidir si los archivos planos deberían permanecer.
Reinicia la pasarela si ya está en marcha:
hermes gateway restart
hermes memory status
El estado debería identificar a Hindsight como el proveedor activo. Para una referencia de comandos más amplia, incluyendo el TUI y los comandos de plugin de Hermes, consulta la hoja de referencia de Hermes Agent CLI.
Valida memoria, no solo instalación
Pide a Hermes que recuerde un hecho descartable sobre un proyecto de prueba, inicia otra sesión, y pide ese hecho de nuevo. La retención es asíncrona por defecto y la extracción espera al modelo de chat, así que da un momento al servidor principal llama.cpp antes de juzgar. Luego prueba un caso más difícil: dile a Hermes que una decisión anterior ha cambiado y pregunta cuál decisión es la actual y por qué. Revisa la UI de Hindsight y las observaciones almacenadas en lugar de asumir que memory status prueba que la ingesta y la recuperación son correctas.
Si la respuesta vuelve vacía, inspecciona el plano de control antes de cambiar modelos. Un retain puede tener éxito y aún así ser invisible para la recuperación mientras recall_types es solo observaciones y la consolidación no se ha ejecutado — ampliar recall_types es la primera comprobación. Una conexión rechazada en el registro del servidor de incrustación significa que el contenedor no puede alcanzar el puerto de incrustación, y las puntuaciones del reordenador todas en cero significan que el GGUF es la conversión incorrecta.
Las elecciones de ruta de escritura (auto_retain, misiones, hueco de aprobación) se cubren en Controla lo que se recuerda.
Solución de problemas y notas operativas
| Síntoma | Causa probable | Primera comprobación |
|---|---|---|
| Hermes dice proveedor no disponible | URL local_external incorrecta o regla de red |
curl http://IP_VM_HINDSIGHT:8888/health |
| Docker inicia, errores de PostgreSQL | Extensión faltante, credenciales incorrectas o memoria compartida insuficiente | Registros del contenedor y pg_extension |
| Incrustaciones devuelven 401 o 404 | URL compatible con OpenAI incorrecta, nombre de variable de entorno equivocado o desajuste de alias de modelo | Prueba directa de /v1/embeddings y nombres de variables |
| El reordenamiento falla | Desajuste de punto final o formato de respuesta, incluyendo ruta /rerank duplicada |
Prueba directa de /v1/rerank y registro del contenedor |
| La recuperación no devuelve nada útil | recall_types limitado a observaciones, o puntuaciones del reordenador en cero |
Plano de control, luego recall_types, luego conversión del reordenador |
| Banco existente reporta desajuste de dimensión | Modelo de incrustación cambiado | Reconstruye vectores/reimporta con un modelo consistente |
| Las respuestas de Hermes se ralentizan | Recuperación síncrona o contención compartida del LLM | Apaga la recuperación síncrona; limita la concurrencia de retain |
| Memorias irrelevantes se repiten | Extracción débil, recuperación ruidosa o consolidación insuficiente | Inspecciona observaciones y puntuaciones de relevancia |
| La conexión a PostgreSQL se rechaza | listen_addresses sigue siendo localhost, o el cliente usó el puerto del otro clúster |
ss -lntp en el host de base de datos; reinicia ese clúster después de cambiar listen_addresses |
no pg_hba.conf entry para una conexión SSL |
No hay línea host o hostssl para la dirección del cliente, o la línea no tiene /32 y se omitió |
Añade la línea, recarga y lee el registro de PostgreSQL |
pg_restore no puede abrir la descarga |
El usuario postgres no puede entrar al directorio de inicio que contiene el archivo |
Copia la descarga a /tmp y restaura desde allí |
must be owner of extension btree_gin |
COMMENT ON EXTENSION se ejecutó como el rol de aplicación |
Recrea la base de datos vacía y restaura con --no-comments |
Paquetes de PostgreSQL 18 instalados, pg_lsclusters muestra solo 14 |
Un nuevo clúster no se crea cuando uno ya existe | sudo pg_createcluster 18 main |
Un despliegue pequeño práctico es 2-4 vCPUs y 4-6 GB de RAM para la VM de API de Hindsight cuando PostgreSQL y toda la inferencia son externas. La asignación de disco aún depende de la imagen Docker elegida y las capas de imagen retenidas; asigna aproximadamente 30-40 GB inicialmente con margen para expandir. Dimensiona el host de PostgreSQL basado en el volumen de memoria real, el rendimiento de almacenamiento y las otras bases de datos que sirve.
Respalda y restaura el banco de Hindsight
El banco de memoria es el único estado que importa, y vive en PostgreSQL. En la Opción B es una base de datos que administras; en la Opción A es el volumen con nombre integrado pg0 dentro del contenedor. Respálalo independientemente del contenedor de Hindsight — recrear el contenedor sin primero capturar el volumen o la base de datos descarta el banco, y hermes backup no alcanza un banco que se ejecuta en un servicio separado.
Opción B — PostgreSQL externo. Descarga la base de datos hindsight en formato personalizado, luego restáurala en una base de datos de prueba para verificar el archivo antes de confiar en él:
pg_dump -h IP_POSTGRES -U hindsight -Fc hindsight > hindsight-bank.dump

# restaura en una base de datos de prueba para demostrar que la descarga es utilizable
createdb -h IP_POSTGRES -U postgres hindsight-verify
pg_restore -h IP_POSTGRES -U postgres -d hindsight-verify hindsight-bank.dump
Confirma que la extensión pgvector y una recuperación de muestra existan en la copia restaurada antes de borrar el destino de la descarga original. Mantén la descarga en un host diferente que la VM de Hindsight, y ejecútala como administrador de PostgreSQL (un rol que puede crear bases de datos) en lugar del rol de aplicación.
Opción A — contenedor todo en uno. La base de datos integrada es un volumen con nombre, así que detén el contenedor y tar el volumen a través de una imagen de un solo uso:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
El punto de montaje dentro del contenedor de tar (/data) es arbitrario; simplemente aliasa el volumen con nombre para que tar pueda leerlo. Para restaurar en el mismo volumen, detén el contenedor, limpia el volumen, y descomprime el archivo de nuevo en él. Mover ese banco a un servidor que administras es la descarga y restauración en Mover la base de datos integrada a un servidor dedicado.
Toma una instantánea en tres momentos en lugar de en un horario de calendario: antes de cambiar el modelo de incrustación, antes de una actualización importante de Hindsight o PostgreSQL, y antes de un paso reflect o consolidación que reescribe el banco. Una copia de seguridad que hayas restaurado en un banco de prueba vale más que una que solo hayas escrito.
Mover la base de datos integrada a un servidor dedicado
El banco todo en uno es el volumen con nombre montado en /home/hindsight/.pg0. Configurar HINDSIGHT_API_DATABASE_URL hace que ese contenedor abra la base de datos nombrada en la URL y ejecute migraciones. El volumen no cambia. Mueve las filas con pg_dump y pg_restore, luego mantén el mismo contenedor y apúntalo al nuevo servidor.
La guía de instalación describe pg0 integrado y una URL externa como dos formas de iniciar un servidor vacío. hindsight-admin respaldo y restauración copia tablas entre bases de datos; restore trunca el esquema de destino y necesita que las tablas existan primero. Exportar, importar y migrar el banco de memoria es el cambio de modelo de incrustación: ese archivo deja los vectores fuera y el destino los recalcula. Un movimiento que mantiene el mismo modelo de incrustación mantiene los vectores, y pg_dump es el archivo que los lleva.
Coincide la versión principal dentro del contenedor
pg0 escucha en 127.0.0.1:5432 dentro del contenedor. Sus binarios viven bajo /home/hindsight/.pg0/installation/<version>/bin, y los datos del clúster son /home/hindsight/.pg0/instances/hindsight/data. El rol, la contraseña y el nombre de la base de datos se predeterminan a hindsight. Lee la versión del servidor con ese cliente. Si ls /home/hindsight/.pg0/installation muestra una construcción diferente, usa ese directorio en lugar de 18.1.0:
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/psql \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -c 'SHOW server_version;'
Una descarga de formato personalizado de ese servidor se restaura en la misma versión principal o una más nueva. Una imagen ghcr.io/vectorize-io/hindsight:latest actual informa PostgreSQL 18.1. El paquete de archivo de Ubuntu 22.04 es PostgreSQL 14, que no puede cargar un archivo 18.
Instala 18 del repositorio Apt de PostgreSQL junto al clúster de la distribución. Cuando 14/main ya existe, el paquete postgresql-18 no crea un clúster:
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
sudo apt update
sudo apt install -y postgresql-18 postgresql-18-pgvector
sudo pg_createcluster 18 main
sudo pg_ctlcluster 18 main start
pg_lsclusters
pg_lsclusters debería mostrar 18/main en el siguiente puerto libre, 5433 cuando 14 sigue en 5432. SELECT version(); en ese puerto debería informar PostgreSQL 18. postgresql-contrib-18 es un nombre de paquete transitorio: apt selecciona postgresql-18, y ese paquete contiene pg_trgm y btree_gin.
Crea el rol, la base de datos y las extensiones de Prepara PostgreSQL y pgvector, y pasa -p 5433 en cada psql para que los comandos alcancen el clúster 18. La base de datos integrada tiene vector, pg_trgm, y btree_gin. Un paquete pgvector más nuevo que la fuente, como 0.8.7 en el servidor contra 0.8.5 en la imagen, aún acepta la descarga.
Deja que el contenedor alcance ese puerto
El nuevo clúster escucha en localhost hasta que listen_addresses en /etc/postgresql/18/main/postgresql.conf incluya la dirección de LAN o *. Esa configuración se aplica cuando el clúster 18 inicia, así que reinícialo con sudo pg_ctlcluster 18 main restart y revisa ss -lntp para 0.0.0.0:5433. “Connection refused” desde otro host significa que nada está aceptando TCP en esa dirección y puerto.
En /etc/postgresql/18/main/pg_hba.conf, permite el host de Hindsight. La máscara es parte de la línea; sin /32 PostgreSQL omite la línea al inicio.
host hindsight hindsight IP_HOST_HINDSIGHT/32 scram-sha-256
host coincide con las conexiones SSL que los clientes abren por defecto. Recarga con sudo pg_ctlcluster 18 main reload. La dirección en un error siguiente “no pg_hba.conf entry … SSL encryption” es la dirección para escribir en esa línea. Desde Docker, esa dirección es el host que ejecuta el contenedor: el puente traduce la conexión saliente del contenedor a la dirección de LAN del host.
Descarga, luego restaura con el cliente 18
Pausa escritores, luego descarga con el binario pg0. Las filas retenidas después de que pg_dump abra su instantánea están ausentes del archivo.
docker exec -e PGPASSWORD=hindsight hindsight \
  /home/hindsight/.pg0/installation/18.1.0/bin/pg_dump \
  -h 127.0.0.1 -p 5432 -U hindsight -d hindsight \
  -Fc --no-owner --no-privileges \
  -f /tmp/hindsight-bank.dump

docker cp hindsight:/tmp/hindsight-bank.dump ./hindsight-bank.dump
En el host de base de datos, pg_restore tiene que ser el binario 18. El cliente 14 no puede leer este archivo. Copia el archivo a /tmp primero. El usuario de sistema postgres no puede entrar al directorio de inicio de otro usuario, así que pg_restore informa “Permission denied” en una descarga que ls -l muestra como legible por todos.
sudo -u postgres /usr/lib/postgresql/18/bin/pg_restore \
  -p 5433 -d hindsight \
  --no-owner --role=hindsight --no-comments \
  --single-transaction --exit-on-error \
  /tmp/hindsight-bank.dump
--role=hindsight hace que las tablas restauradas pertenezcan al rol de aplicación. --no-comments omite COMMENT ON EXTENSION, que falla con “must be owner of extension btree_gin” cuando el superusuario creó la extensión y el rol de aplicación no. --single-transaction deshace una carga fallida, así que la siguiente ejecución comienza desde un esquema vacío. Una carga parcial dejada por un intento anterior necesita DROP DATABASE y las tres declaraciones CREATE EXTENSION de nuevo antes de un reintent
