
Kanban en Hermes Agent para flujos de trabajo de LLMs autoalojados
Controla la carga de Hermes Kanban en tu LLM autodesplegado.
Hermes Agent incorpora un tablero de estilo Kanban y el Gateway de Hermes, que puede saturar tu LLM autoalojado si se envían demasiadas tareas a la vez.
Puedo afirmar que de esta forma puedes fácilmente saturar (ddos) tu propio LLM.
Hermes Kanban es un tablero durable de perfiles múltiples respaldado por ~/.hermes/kanban.db.
Cada carril representa una fase de trabajo, y cada tarjeta es una tarea que puede ser asumida por un perfil específico de Hermes.
De serie, el despachador puede promover muchas tareas en estado ready en una sola pasada. Eso está bien para APIs de nube elásticas, pero puede sobrecargar un pequeño clúster de GPU autoalojado.
Si eres nuevo en esta pila, comienza con la guía amplia de configuración y operaciones de Hermes y el pilar de Sistemas de IA para la arquitectura circundante.
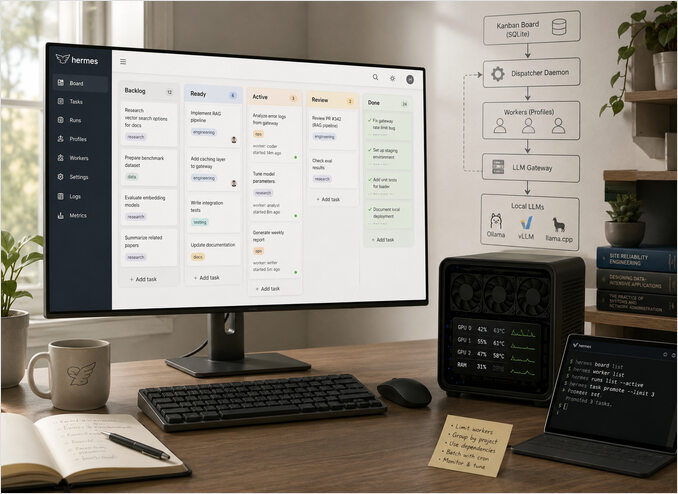
Esta publicación muestra cómo:
- Comprender cómo la interacción de despacho de Hermes Kanban afecta a tu pasarela de LLM.
- Controlar el paralelismo de forma segura para tareas pesadas.
- Agrupar promociones con cron para que los trabajos en segundo plano no colisionen con el uso interactivo.
- Monitorear y ajustar el sistema para que las GPUs sigan ocupadas sin sobrecarga.
Cómo funcionan Hermes Kanban y el despachador
A un nivel alto, el sistema tiene tres capas:
- Tablero - estado SQLite durable para tareas, columnas, relaciones e historial.
- Trabajadores - perfiles de Hermes iniciados en espacios de trabajo aislados para procesar una tarea.
- Despachador - un proceso de larga duración que escanea tarjetas despachables e inicia ejecuciones.
Las tareas creadas desde la CLI o el panel de control generalmente comienzan en backlog o ready. Los subcomandos de hermes kanban utilizados a continuación se resumen en la hoja de referencia de la CLI de Hermes Agent).
El despachador escanea tarjetas elegibles, asume una de forma atómica e inicia el perfil asignado con sus herramientas y memoria.
Cada trabajador luego llama a tu pasarela de LLM o tiempo de ejecución local (por ejemplo, puntos finales compatibles con OpenAI respaldados por Ollama, vLLM o llama.cpp). Para elegir la implementación entre estos tiempos de ejecución, usa Hospedaje de LLM en 2026: Comparación de Infraestructura Local Autoalojada y en la Nube. Si estás ajustando el abanico de solicitudes en Ollama mismo, esto se combina bien con Cómo Ollama maneja peticiones paralelas.
Si agregas muchas tareas pesadas y no limitas las promociones, tu pasarela puede inundarse con solicitudes concurrentes.
En un host con una sola GPU o limitado por CPU, eso a menudo significa colas, inestabilidad (thrashing) y tiempos de espera agotados en lugar de un mejor rendimiento.
La limitación práctica hoy
En las versiones actuales de Hermes que utilizan muchos equipos, la configuración del despachador expone solo dos claves de despacho de Kanban y no aplica un límite global de tareas activas desde la configuración:
kanban:
  dispatch_in_gateway: false
  dispatch_interval_seconds: 10
Para el control de tareas activas, confía en una cadencia de despacho explícita (hermes kanban dispatch --max ...) más el modelado de dependencias.
Problemas conocidos:
- No ejecutes el despacho integrado en la pasarela y
hermes kanban daemon --forcecontra el mismo tablero, o puedes obtener carreras de asunción (claim races). - Si la pasarela está caída, las tareas
readyno se despachan y pueden producirse en ráfaga más tarde cuando el servicio regrese. - Los intervalos de despacho más largos se sienten irregulares porque la asunción ocurre en ticks.
- El comportamiento puede variar entre versiones porque los casos de borde de estado de ejecución y reclamación se parchearon con el tiempo.
Verificación rápida cuando el comportamiento parece incorrecto:
# 1) confirmar que exactamente una ruta de despachador está activa
pgrep -af "hermes gateway start|hermes kanban daemon"

# 2) comprobar las claves del despachador de Kanban configuradas
rg "dispatch_in_gateway|dispatch_interval_seconds" ~/.hermes/config.yaml

# 3) inspeccionar la forma de la cola
hermes kanban list --status ready
hermes kanban list --status running
Ideas clave:
- La configuración del despachador conecta
dispatch_in_gatewayydispatch_interval_seconds. dispatch --maxlimita nuevas apariciones en esa pasada, no las tareas en ejecución total.- Para pequeños clústeres autoalojados, empieza conservador y aumenta solo después de que la latencia se mantenga estable.
Al desplegar Hermes cerca de tu pasarela de LLM por primera vez:
- Mantén solo las claves del despachador de Kanban soportadas en la configuración.
- Observa la utilización de GPU y CPU bajo presión de cola real.
- Usa la Estrategia 1 o la Estrategia 2 para un ritmo determinista.
Hallazgos de la investigación y causa raíz
hermes kanban dispatch no lee config.yaml para max_active_tasks.
En hermes_cli/kanban.py, el comando de despacho expone --max como un límite de CLI (por defecto None) y pasa solo args.max a kb.dispatch_once(...). No hay búsqueda de configuración max_active_tasks en esta ruta. Ver hermes_cli/kanban.py crudo.
Luego en kanban_db.dispatch_once, el único límite es max_spawn, con una lógica equivalente a:
if max_spawn is not None and spawned >= max_spawn:
    break
No hay verificación de tareas ya en ejecución y ninguna referencia a max_active_tasks en esa ruta de despacho. Ver hermes_cli/kanban_db.py crudo.
Comportamiento efectivo:
hermes kanban dispatch
sin límite para esa pasada (limitado por el tamaño de la cola lista).
hermes kanban dispatch --max 2
limita solo nuevas apariciones en esa pasada, no las tareas en ejecución total.
Las perillas de configuración conectadas alrededor del despacho de la pasarela son kanban.dispatch_in_gateway y kanban.dispatch_interval_seconds.
Por lo tanto, max_active_tasks se ignora en esta ruta de despacho porque no está implementado allí.
Estrategia 1: Codificar dependencias para flujos estrictamente secuenciales
Algunos flujos de trabajo deberían ejecutarse estrictamente uno después del otro, por ejemplo:
- pipelines de datos de múltiples pasos con artefactos intermedios compartidos
- migraciones o cambios de infraestructura
- trabajos por lotes que escriben en el mismo almacén de objetos o base de datos
Hermes Kanban soporta dependencias de padre-hijo entre tareas, de modo que una tarjeta hija se vuelve despachable solo cuando su padre está completado.
Puedes modelar esto con un pequeño script de ayuda alrededor de la CLI de Hermes:
#!/usr/bin/env bash

set -euo pipefail

parent_id="$(hermes kanban add \
  --title 'Ingest customer logs for April' \
  --profile 'etl-worker' \
  --column backlog)"

hermes kanban add \
  --title 'Generate April anomaly report' \
  --profile 'analytics-worker' \
  --column backlog \
  --parent "${parent_id}"

hermes kanban add \
  --title 'Publish April summary to dashboard' \
  --profile 'reporting-worker' \
  --column backlog \
  --parent "${parent_id}"
Con una política de tablero adecuada y límites bajos de despachador, solo la tarea padre se ejecuta primero.
Una vez que termina, las tareas hija gradualmente se vuelven listas, y el despachador las recoge una por una sin superar nunca tus límites de concurrencia.
Estrategia 2: Usar cron de Linux con un límite de despacho consciente de las tareas en ejecución
Si deseas un ritmo determinista, usa cron del host más un pequeño script de envoltura.
En lugar de llamar siempre a dispatch --max 2, primero cuenta las tareas en ejecución actuales y luego despacha solo los espacios restantes.
Crea hermes-kanban-dispatch-capped.sh:
#!/usr/bin/env bash
set -euo pipefail

MAX_PARALLEL="${MAX_PARALLEL:-2}"
BOARD="${BOARD:-}"

board_args=()
if [[ -n "$BOARD" ]]; then
  board_args=(--board "$BOARD")
fi

# o donde tengas instalado hermes
export PATH="/home/abc/.local/bin:$PATH"

running_out="$(hermes kanban "${board_args[@]}" list --status running)"

if [[ "$running_out" == *"(no matching tasks)"* ]]; then
  running_count=0
else
  running_count="$(printf '%s\n' "$running_out" | wc -l)"
fi

slots=$(( MAX_PARALLEL - running_count ))

if (( slots <= 0 )); then
  echo "Already at limit running=$running_count max=$MAX_PARALLEL dispatch skipped"
  exit 0
fi

echo "running=$running_count max=$MAX_PARALLEL slots=$slots dispatching up to $slots"

hermes kanban "${board_args[@]}" dispatch --max "$slots"
Hazlo ejecutable:
chmod +x ./hermes-kanban-dispatch-capped.sh
Ejecútalo con:
MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Para un tablero específico:
BOARD=my-board MAX_PARALLEL=2 ./hermes-kanban-dispatch-capped.sh
Programa una vez por minuto con cron:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-capped.sh >> /var/log/hermes/kanban-cron.log 2>&1
Notas operativas:
- Cron a menudo tiene una
PATHmínima, por lo que sihermesno se encuentra, usa su ruta completa dentro del script (por ejemplo/usr/local/bin/hermes). - Si registras en
/var/log/hermes/..., crea primero ese directorio y asegúrate de que el usuario de cron tenga acceso de escritura.
Ejemplo:
sudo mkdir -p /var/log/hermes
sudo chown "$USER":"$USER" /var/log/hermes
Crea o edita las entradas de cron con:
crontab -e
Luego verifica con:
crontab -l
Cadencia sub-minuto con una sola entrada de cron
Cron hace un tick una vez por minuto, pero aún puedes despachar más frecuentemente ejecutando un breve bucle dentro del script.
Ejemplo de hermes-kanban-dispatch-subminute.sh:
#!/usr/bin/env bash
set -euo pipefail

LOCK_FILE="/tmp/hermes-kanban-dispatch.lock"
RUNS_PER_MINUTE="${RUNS_PER_MINUTE:-4}"    # 4 ejecuciones => cada 15 segundos
CAP_SCRIPT="${CAP_SCRIPT:-/opt/hermes/scripts/hermes-kanban-dispatch-capped.sh}"

exec 9>"$LOCK_FILE"
flock -n 9 || exit 0

sleep_seconds=$(( 60 / RUNS_PER_MINUTE ))

for ((i=1; i<=RUNS_PER_MINUTE; i++)); do
  "$CAP_SCRIPT"

  if (( i < RUNS_PER_MINUTE )); then
    sleep "$sleep_seconds"
  fi
done
Hazlo ejecutable:
chmod +x ./hermes-kanban-dispatch-subminute.sh
Programa una vez por minuto:
* * * * * /opt/hermes/scripts/hermes-kanban-dispatch-subminute.sh >> /var/log/hermes/kanban-subminute.log 2>&1
Esto da una cadencia efectiva sub-minuto mientras flock previene ejecuciones superpuestas.
Por qué funciona esto:
list --status runningda la carga en ejecución actual.dispatch --max Nlimita solo nuevas apariciones para esa pasada.- Calcular
Ncomo espacios restantes mantiene las tareas en ejecución cerca de tu límite objetivo.
Advertencia importante: este límite solo funciona para despachos realizados a través de este script.
Deshabilita el despacho integrado en la pasarela, de lo contrario aún puede promover tareas de forma independiente:
kanban:
  dispatch_in_gateway: false
La documentación oficial describe las capacidades de ambos comandos y señala los valores por defecto del despacho de la pasarela en la guía de funciones de Kanban: Documentación de Hermes Kanban.
Cron interno de Hermes
No lo uses.
¿Realmente quieres que tu llm procese prompts regulares como Execute in terminal the command /path/hermes-kanban-dispatch-capped.sh, especialmente cuando está ocupado haciendo algún trabajo útil?
Monitoreo y ajuste de Hermes Kanban
Estrategia elijas, deberías monitorear:
- Métricas de la pasarela de LLM — tasa de solicitudes, latencia, tasa de errores, throughput de tokens.
- Salud del nodo — utilización de GPU, uso de VRAM, carga de CPU y RAM.
- Métricas de Hermes — cuántas tareas están en backlog, ready, active y done.
Para líneas base de métricas de producción y paneles de control, ver Monitoreo de Inferencia de LLM en Producción con Prometheus y Grafana y el centro de Rendimiento de LLM.
Empieza con baja concurrencia, luego aumenta gradualmente los límites mientras observas:
- latencia creciente a constante throughput
- aumento de errores de tiempo de espera o límite de tasa
- colas largas donde algunas tareas permanecen activas durante mucho tiempo
En cuanto veas estos síntomas, vuelve a la configuración estable anterior y mantén eso como tu predeterminado.
Cuando Kanban es la herramienta correcta
Hermes Kanban brilla cuando tienes:
- backlogs de investigación o ingeniería de larga duración
- colaboración multi-agente con perfiles nombrados
- flujos de trabajo que deben sobrevivir reinicios y reinicios del host
- humanos que quieren un panel de control para triar el trabajo
Si solo necesitas una sola ejecución para crear unos pocos helpers temporales, las herramientas de delegación de tareas integradas suelen ser más simples.
Una vez que necesitas historial, paneles de control y control estricto sobre cómo tus agentes impactan los LLM autoalojados, el tablero Kanban más el despachador es la base correcta.
Con algunos ajustes de configuración y agrupación opcional basada en cron, puedes mantener Hermes Kanban responsivo mientras proteges tu pasarela y hardware.
Para una mirada más amplia sobre cómo los trabajadores en segundo plano estilo Hermes encajan en las arquitecturas de asistentes de IA de producción — incluyendo programadores, sondeo basado en colas, protocolos de asunción, flujos de trabajo durables y evaluación semántica — ver Agentes de Sondeo en Asistentes de IA: 11 Patrones de Implementación. Cuando múltiples perfiles nombrados o agentes especializados necesitan coordinarse más allá del simple despacho de tareas, Patrones de Orquestación Multi-Agente cubre las topologías de coordinación — hub-and-spoke, abanico, enjambre — que sostienen configuraciones multi-agente más grandes en infraestructura autoalojada.
