
Ruteo de modelos: Deja de usar un solo modelo para todo
El modelo adecuado para la tarea correcta.
Ejecutar un modelo de 70 mil millones de parámetros para resumir un correo electrónico de 200 palabras es un desperdicio. Ejecutar un modelo de 3 mil millones de parámetros para revisar código de producción es imprudente. La mayoría de los sistemas se sitúan en algún punto intermedio, y es precisamente ahí donde entra en juego el enrutamiento de modelos.
Consiste en hacer coincidir la complejidad de la tarea con la capacidad del modelo. Las compensaciones son reales, al igual que los ahorros.
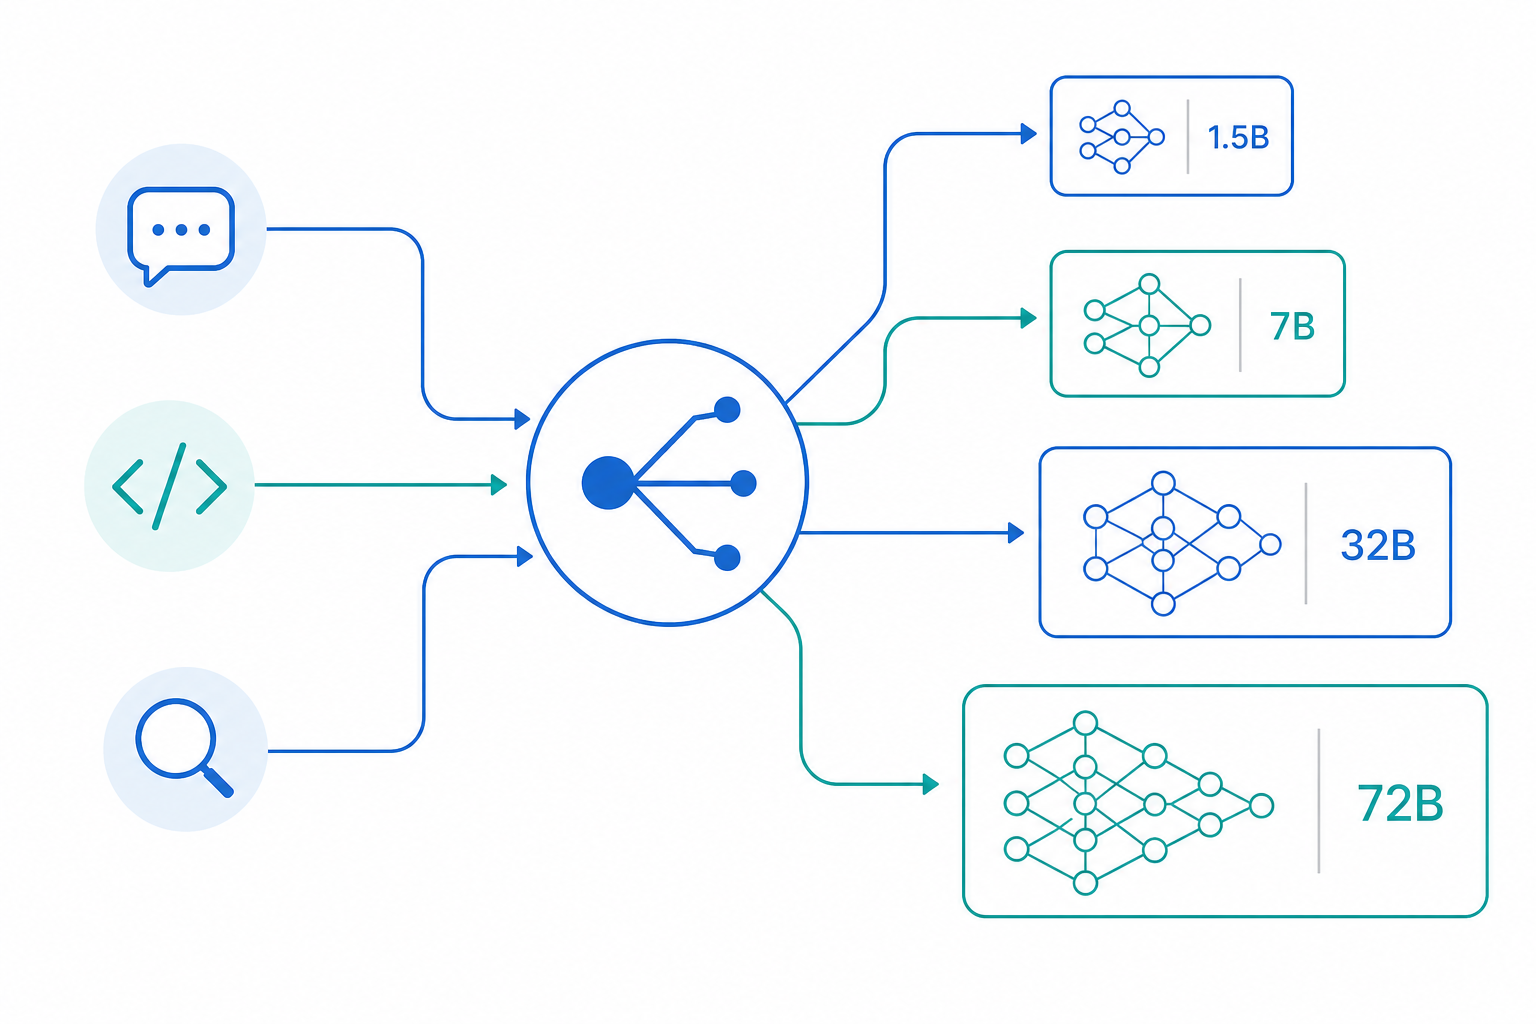
El problema del enrutamiento
Por lo general, las personas comienzan con un solo modelo y se quedan con él. Eso funciona hasta que notan el coste, o la latencia, o ambas cosas. La alternativa es construir un enrutador, algo que decida qué modelo gestiona cada solicitud.
Cuatro estrategias funcionan en la práctica:
- Basada en capacidad — enrutar según lo que el modelo puede hacer
- Consciente del coste — enrutar según lo que estás dispuesto a gastar
- Consciente de la latencia — enrutar según lo rápido que lo necesites
- Híbrida — combinarlas
Cada una optimiza algo diferente. Elegir una suele ser una decisión sobre qué duele más.
Enrutamiento basado en capacidad
El enfoque más sencillo. Clasificar la tarea y enviarla al modelo que la gestiona.
| Tarea | Tamaño del modelo | Ejemplos |
|---|---|---|
| Clasificación, etiquetado | 1-3B | Qwen3-1.7B, Gemma-2-2B |
| Resumen, extracción | 3-7B | Qwen3-8B, Llama-3.1-8B |
| Generación de código | 7-14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| Razonamiento complejo | 14-32B | Qwen3-32B, Llama-3.1-70B |
| Escritura creativa, análisis | 32B+ | Qwen2.5-72B, Claude, GPT-4 |
Si la tarea no necesita el modelo más grande, no lo uses. Un modelo de 1.5B gestiona bien la clasificación de sentimiento. Solo que no escribirá un ensayo coherente.
La implementación es sencilla:
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
El truco está en la propia clasificación. Si aciertas mal el tipo de tarea, enroutes al modelo equivocado. He visto sistemas que clasifican la revisión de código como «resumen» y pierden calidad en silencio.
Enrutamiento consciente del coste
La inferencia local brilla aquí. Los modelos locales son efectivamente gratuitos tras la amortización del hardware. Una RTX 5080 se paga a sí misma en unos seis meses con un uso moderado de la API.
| Modelo | Entrada ($/M tokens) | Salida ($/M tokens) | Coste local/hora |
|---|---|---|---|
| GPT-4o | $2.50 | $10.00 | — |
| Claude Sonnet 4 | $3.00 | $15.00 | — |
| Qwen2.5-72B (API) | $0.50 | $2.00 | — |
| Qwen3-32B (local) | $0.00 | $0.00 | ~$0.10 |
| Qwen3-8B (local) | $0.00 | $0.00 | ~$0.05 |
Si estás procesando miles de solicitudes por sesión, incluso 0,05 dólares en electricidad superan a 15 dólares/millón de tokens.
El enrutamiento basado en presupuesto realiza un retroceso (fallback) a medida que gastas:
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
La calidad se degrada a medida que retrocedes. Comienzas con Claude, pasas a Qwen3-32B y luego a Qwen3-8B. Al final de una sesión larga, la salida es notablemente peor. Si eso importa depende de lo que estés construyendo.
Enrutar el tráfico rutinario a un modelo local mientras se reserva la API para casos límite también tiene un beneficio secundario más allá del coste: te impide caer en el tipo de gravedad de los datos donde cada ajuste fino y banco de pruebas de evaluación termina por tomar forma alrededor de la API de un solo proveedor.
Enrutamiento consciente de la latencia
Las herramientas interactivas necesitan tokens rápidos en el primer token. Las tareas por lotes pueden esperar. La diferencia suele ser un factor de cinco en el tamaño del modelo.
| Caso de uso | Primer token | Completo | Tamaño máximo del modelo |
|---|---|---|---|
| Chat en tiempo real | < 200 ms | < 2 s | < 7B |
| Herramientas interactivas | < 500 ms | < 5 s | < 14B |
| Procesamiento por lotes | < 1 s | < 30 s | Cualquiera |
| Investigación/análisis | < 2 s | < 60 s | Cualquiera |
Cuando estás transmitiendo tokens a un usuario, la latencia del primer token es lo que ellos sienten. Un modelo de 32B que tarda medio segundo para empezar se siente torpe en comparación con un modelo de 1.5B que dispara de inmediato.
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
Las cifras de latencia son aproximadas; dependen de tu hardware, la cuantización y el tamaño del lote. Mide en tu propia configuración.
Estrategias de respaldo
Los modelos fallan. Las APIs limitan el acceso por tasa. Ocurren vencimientos de tiempo. El patrón que funciona es una cadena de respaldo, ordenada de lo mejor a lo más fiable:
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
El último modelo de la cadena debería ser local. Es más lento, pero no fallará por un problema de red o una clave de API.
Cuando el enrutamiento ayuda
El enrutamiento tiene sentido cuando tu carga de trabajo es mixta. Si estás haciendo clasificación, resumen y razonamiento en el mismo sistema, un enrutador ahorra dinero y latencia.
No tiene sentido cuando todo lo que haces tiene la misma complejidad. Solo usa el modelo que sea bueno para esa tarea. El enrutador añade una complejidad que no necesitas.
El prototipado temprano es otra razón para omitirlo. Haz que la tarea funcione con un solo modelo y luego añade enrutamiento cuando el coste o la latencia se conviertan realmente en un problema.
Compensaciones
Cada estrategia de enrutamiento optimiza algo y sacrifica algo más:
- Modelo único — la más sencilla, la más cara, calidad consistente
- Basada en capacidad — mejor coste, mayor calidad por tarea, complejidad moderada
- Consciente del coste — la más barata, la calidad varía, complejidad moderada
- Consciente de la latencia — la más rápida, puede sacrificar calidad, complejidad moderada
- Híbrida — lo mejor de todo, la más compleja de implementar
Los sistemas de producción suelen converger en híbridos. Comienza con enrutamiento basado en capacidad, añade conciencia de coste cuando llegue la factura y añade conciencia de latencia cuando los usuarios se quejen de la lentitud.
Relacionados
- Optimización de costes para sistemas LLM — presupuestación de tokens, caché, modelos de respaldo
- Barandillas de seguridad (Guardrails) para LLM en la práctica — validación de entrada, filtrado de salida, seguridad
- Diseño de sistemas multamodelo — arquitectura para múltiples modelos
- LLM de decisión: cuándo un modelo debe decidir y cuándo no — la taxonomía de roles de decisión detrás de la selección de nivel, con escalado basado en confianza
- Arquitectura de LLM — pilar de diseño de sistemas: enrutamiento, coste, barandillas de seguridad y orquestación
