Llm

Microservizi Go per l'orchestrazione AI/ML

Microservizi Go per l'orchestrazione AI/ML

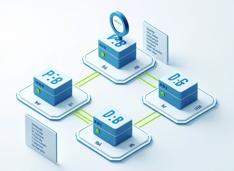
Costruisci pipeline AI/ML robuste con microservizi Go

Con l’aumento della complessità dei carichi di lavoro di AI e ML, la necessità di sistemi di orchestrazione robusti è diventata sempre più pressing. La semplicità, le prestazioni e la concorrenza di Go lo rendono una scelta ideale per costruire il livello di orchestrazione delle pipeline ML, anche quando i modelli stessi sono scritti in Python.
Esecuzione di FLUX.1-dev GGUF Q8 in Python

Esecuzione di FLUX.1-dev GGUF Q8 in Python

Accelerare FLUX.1-dev con la quantizzazione GGUF

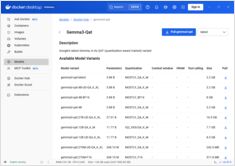
FLUX.1-dev è un potente modello di generazione di immagini da testo che produce risultati straordinari, ma il suo requisito di memoria di 24GB+ rende difficile il suo utilizzo su molti sistemi. Quantizzazione GGUF di FLUX.1-dev offre una soluzione, riducendo l’utilizzo della memoria del circa 50% mantenendo comunque una buona qualità delle immagini.

Convertire HTML in Markdown con Python: una guida completa

Convertire HTML in Markdown con Python: una guida completa

Python per convertire HTML in Markdown pulito e pronto per l'LLM

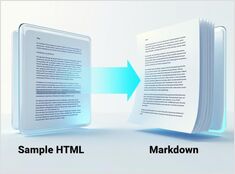
Conversione di HTML in Markdown è un compito fondamentale nei flussi di lavoro di sviluppo moderni, in particolare quando si prepara il contenuto web per i Large Language Models (LLMs), i sistemi di documentazione o i generatori di siti statici come Hugo. Questa guida fa parte del nostro Strumenti di Documentazione nel 2026: Markdown, LaTeX, PDF e Flussi di Lavoro per la Stampa hub.

ASIC per LLM e chip di inferenza specializzati (perché sono importanti)

ASIC per LLM e chip di inferenza specializzati (perché sono importanti)

Le ASIC e il silicio personalizzato aumentano la velocità e l'efficienza dell'inferenza dei modelli LLM

Il futuro dell’AI non riguarda solo modelli più intelligenti. Riguarda anche il silicio che corrisponde al modo in cui questi modelli vengono effettivamente serviti. L’hardware specializzato per l’inferenza LLM sta seguendo un percorso simile al passaggio del mining di Bitcoin dalle GPU agli ASIC appositamente progettati, sebbene con vincoli più stringenti poiché i modelli e le ricette di precisione continuano a evolversi.

DGX Spark vs. Mac Studio: Analisi dei prezzi di NVIDIA's Personal AI Supercomputer

DGX Spark vs. Mac Studio: Analisi dei prezzi di NVIDIA's Personal AI Supercomputer

Disponibilità, prezzi al dettaglio reali in sei Paesi e confronto con Mac Studio.

NVIDIA DGX Spark è reale, in vendita dal 15 ottobre 2025, e pensato per gli sviluppatori CUDA che hanno bisogno di un lavoro locale con LLM dotato di uno stack NVIDIA AI integrato. Il prezzo suggerito al pubblico negli Stati Uniti è di 3.999 $; il prezzo al dettaglio nel Regno Unito/Tedesca/Giappone è più alto a causa dell’IVA e dei canali di distribuzione. I prezzi al dettaglio pubblici in AUD/KRW non sono ancora ampiamente pubblicati.