Conoscete Sisyphus e il suo team di agenti specialisti.
Il salto di capacità più significativo in OpenCode deriva dagli agenti specializzati: una separazione deliberata tra orchestrazione, pianificazione, esecuzione e ricerca.
Installa Oh My Opencode e rilascia più velocemente.
Oh My Opencode trasforma OpenCode in un harness per la programmazione multi-agente: un orchestratore assegna il lavoro ad agenti specializzati che si eseguono in parallelo.
Test di OpenCode LLM — statistiche su codifica e accuratezza
Ho testato come funziona OpenCode con diversi LLM ospitati localmente su Ollama e llama.cpp, e per confronto ho aggiunto alcuni modelli gratuiti da OpenCode Zen.
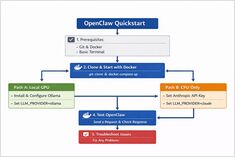
OpenHands è una piattaforma open-source, agnostica rispetto al modello, per agenti di sviluppo software guidati dall’IA.
Permette a un agente di comportarsi più come un partner di programmazione che come un semplice strumento di autocompletamento.
Esegui API compatibili con OpenAI in locale con LocalAI in pochi minuti.
LocalAI è un server di inferenza self-hosted e local-first progettato per comportarsi come un’API OpenAI plug-and-play per eseguire carichi di lavoro di IA sull’hardware proprio (laptop, workstation o server in locale).
L’inferenza LLM sembra “un altro API” — fino a quando i picchi di latenza, le code si ingorgano e le tue GPU rimangono al 95% di memoria senza una spiegazione ovvia.
AWS S3 rimane la linea di base “predefinita” per lo storage di oggetti: è completamente gestito, fortemente coerente e progettato per offrire durabilità e disponibilità estremamente elevate.
Garage e MinIO sono alternative self-hosted compatibili con S3: Garage è progettato per cluster di piccole e medie dimensioni, leggeri e geograficamente distribuiti, mentre MinIO enfatizza l’ampia copertura delle funzionalità dell’API S3 e l’elevata performance nelle implementazioni più grandi.
Garage è un sistema di storage oggetto open-source, auto-hostato e compatibile con S3, progettato per piccole e medie implementazioni, con un forte enfasi sulla resilienza e sulla distribuzione geografica.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Controlla dati e modelli con LLM ospitati in-house
L’auto-ospedalizzazione degli LLM mantiene dati, modelli e inferenza sotto il tuo controllo: una via pratica per la sovranità dell’IA per team, imprese e nazioni.
Test di velocità LLM su RTX 4080 con 16 GB di VRAM
Esecuzione locale di grandi modelli linguistici (LLM) garantisce riservatezza, funzionamento offline e zero costi di API.
Questo benchmark rivela esattamente cosa ci si può aspettare da 14 popolari
LLM su Ollama su una RTX 4080.
L’ecosistema Go continua a prosperare grazie a progetti innovativi che spaziano dall’AI, alle applicazioni auto-hosted e all’infrastruttura per sviluppatori. Questa panoramica analizza i repository Go più popolari su GitHub di questo mese.
Oggi ci concentriamo sui GPU per consumatori di alto livello e sui moduli di RAM.
Specificamente sto esaminando
prezzi RTX-5080 e RTX-5090, e 32GB (2x16GB) DDR5 6000.
vLLM è un motore di inferenza e serving ad alto throughput ed efficiente in termini di memoria per i Large Language Models (LLM), sviluppato dal Sky Computing Lab dell’UC Berkeley.