
LLM ASIC 및 전용 추론 칩(왜 중요한가)
ASIC과 맞춤형 실리콘은 LLM 추론 속도와 효율성을 높입니다
AI의 미래는 단순히 더 스마트한 모델에 관한 것이 아닙니다. 동시에, 이러한 모델이 실제로 서빙되는 방식에 부합하는 실리콘 기술에 관한 것이기도 합니다. LLM 추론을 위한 전용 하드웨어는 비트코인 마이닝이 GPU에서 목적론적 ASIC로 이동했던 경로를 떠올리게 하며, 모델과 정밀도 레시피가 계속 진화하기 때문에 더 어려운 제약 사항이 따릅니다.
처리량, 지연 시간, VRAM, 그리고 런타임 및 하드웨어 전반에 걸친 벤치마크에 대한 자세한 내용은 LLM 성능: 벤치마크, 병목 현상 및 최적화에서 확인하세요.
 전기적 상상력 - Flux 텍스트에서 이미지 생성 LLM.
왜 LLM은 추론 전용 하드웨어에서 이점을 얻는가
대규모 언어 모델(LLM)은 AI를 변화시켰지만, 모든 유창한 응답은 거대하고 예측 가능한 행렬 연산 및 메모리 트래픽 흐름에 의존합니다. 추론 비용이 증가하면서(모델의 수명 동안 학습 비용보다 커지는 경우가 많음) - 모든 가능한 워크로드가 아니라 서빙을 위해 최적화된 칩이 경제적으로 매력적이 becomes됩니다.
비트코인 마이닝과의 비유는 완벽하지는 않지만 교육적입니다. 둘 다 반복적이고 경계가 명확한 작업으로, 다이(die)에서 사용하지 않는 범용성을 제거하면 처리량과 유용한 연산 당 줄(joule) 수에서 큰 이점을 얻을 수 있습니다.
비트코인 마이닝의 역사가 추론 ASIC에 대해 시사하는 것
비트코인 마이닝은 네 개의 세대를 거쳐 진화했습니다:
| 시대 | 하드웨어 | 주요 이점 | 제한 사항 |
|---|---|---|---|
| 2015–2020 | GPU (CUDA, ROCm) | 유연성 | 전력 낭비, 메모리 병목 |
| 2021–2023 | TPU, NPU | 거친粒度의 전문화 | 여전히 학습 지향 |
| 2024–2025 | Transformer ASICs | 낮은 비트 추론을 위한 튜닝 | 제한된 범용성 |
AI는 유사한 경로를 따르고 있습니다. 각 전환은 성능과 에너지 효율성을 수십 배씩 향상시켰습니다.
그러나, 비트코인 ASIC(단 SHA-256만 계산)과 달리, 추론 ASIC는 일정 수준의 유연성이 필요합니다. 모델은 진화하고, 아키텍처는 변화하며, 정밀도 스키마는 개선됩니다. 핵심은 적당히 전문화하는 것입니다 — 핵심 패턴을 하드웨어로 고정하되, 가장자리에서는 적응력을 유지하는 것입니다.
LLM 추론은 학습과 어떻게 다른가 (그리고 칩이 활용하는 것)
추론 워크로드는 전용 하드웨어가 타겟팅할 수 있는 패턴을 드러냅니다:
- 낮은 정밀도가 지배적 — 8-bit, 4-bit, 심지어 3진수나 2진수 연산도 추론에 잘 작동
- 메모리가 병목 — 가중치와 KV 캐시 이동은 계산보다 훨씬 더 많은 에너지를 소모
- 처리량보다 지연 시간이 중요 — 사용자는 200ms 이내에 토큰을 기대
- 대규모 요청 병렬성 — 칩당 수천 개의 동시 추론 요청
- 예측 가능한 패턴 — Transformer 레이어는 구조가 매우 잘 잡혀 있어 하드웨어로 고정 가능
- 희소성 기회 — 모델은 점점 더 가지치기(pruning) 및 MoE(Mixture-of-Experts) 기법을 사용
목적론적으로 구축된 추론 칩은 이러한 가정을 하드웨어로 고정하여 범용 GPU보다 와트당 10~50배 더 나은 성능을 달성할 수 있습니다.
누가 LLM 최적화 추론 실리콘을 구축하고 있는가
추론 ASIC 시장은 기존 대기업, 웨이퍼 스케일 설계, 그리고 Transformer 모양의 실리콘에 베팅하는 스타트업을 포괄합니다:
| 회사 | 칩 / 플랫폼 | 전문 분야 |
|---|---|---|
| Groq | LPU (Language Processing Unit) | LLM을 위한 결정론적 처리량 |
| Etched AI | Sohu ASIC | 하드웨어로 고정된 Transformer 엔진 |
| Tenstorrent | Grayskull / Blackhole | 높은 대역폭 메쉬를 가진 범용 ML |
| Taalas | HC1 (Llama 3.1 8B 제품) / HC2 로드맵 | 모델 특정 “하드코어” 실리콘; 저장과 계산 통합 |
| OpenAI × Broadcom | Custom Inference Chip | 2026년 출시 소문 |
| Intel | Crescent Island | 160GB HBM을 가진 추론 전용 Xe3P GPU |
| Cerebras | Wafer-Scale Engine (WSE-3) | 대규모 온-다이 메모리 대역폭 |
이 중 상당수는 이미 생산 데이터 센터에서 사용되고 있으며, 슬라이드웨어가 아닙니다. d-Matrix, Rain AI, Mythic, Tenet과 같은 더 작은 팀들도 낮은 비트 추론과 구조화된 희소성에 튜닝된 아키텍처를 추구하기 위해 노력하고 있습니다.
Taalas HC1, Chat Jimmy, 그리고 초고속 소형 모델 서빙
Taalas는 “거의 모든 것을 전문화”하는 학문의 최근 사례입니다. 이 회사는 메모리-계산 경계(칩 외부 DRAM 대 칩 내부 SRAM)가 추론의 비용, 전력, 엔지니어링 복잡성을 지배하며, 모델별 실리콘 — 그들이 Hardcore Models라고 부르는 것 — 이 배포가 가중치와 그래프를 고정하는 것을 허용할 때 그 경계를 소거할 수 있다고 주장합니다.
그들의 첫 번째 출하 제품인 HC1은 Llama 3.1 8B 변형을 하드웨어로 고정합니다. 이 선택은 실용적입니다: 모델은 신속하게 구축하기에 충분히 작고, 공개적으로 문서화되어 있으며, 추론 깊이보다 지연 시간과 비용이 더 중요한 많은 자동화, 분류, 초안 작성 작업에 여전히 유용합니다. Taalas는 이 구성에 대해 사용자당 초당 약 16k–17k 디코딩된 토큰을 보고하며(벤더 방법론과 비교는 그들의 자료에 나타남), 동일한 모델 클래스에서 기존 GPU 스택에 비해 자본과 전력 측면에서 큰 이점을 주장합니다. 1세대 제품은 공격적인 혼합 낮은 비트 저장을 사용하며, 회사는 HC2에서 표준 4-bit 부동 소수 형식으로 전환하여 품질 헤드룸을 회복한다고 설명합니다.
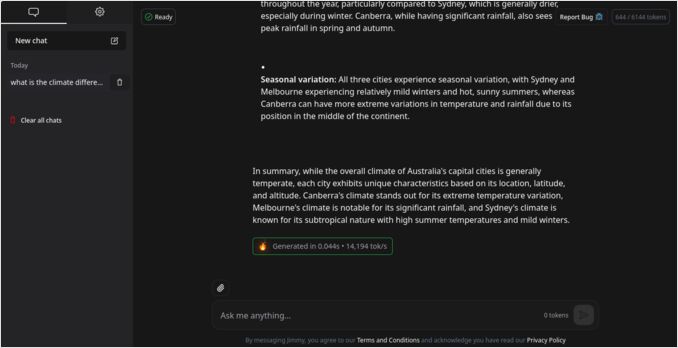
그 처리량 클래스가 실무에서 무엇을 의미하는지 체감하고 싶은 개발자들을 위해, Taalas는 무료 챗봇 데모인 Chat Jimmy를 운영하고 있으며, 사이트의 신청서를 통해 API 접근을 제공합니다. 이는 명시적으로 개념 증명입니다 — 프런티어 어시스턴트가 아닙니다 — 그러나 느리거나 비싼 느낌을 주는 더 큰 모델보다 “인간 인지 속도"의 모범적인 모델을 선호할 수 있는 실제 청중을 보여줍니다.
Transformer 추론 ASIC의 아키텍처
Transformer 최적화 칩은 내부적으로 실제로 어떤 모습일까요?
+--------------------------------------+
|         호스트 인터페이스             |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  칩 내부 인터커넥트 (메쉬/링)        |
+--------------------------------------+
|  계산 타일 / 코어                     |
|   —稠密 행렬 곱 단위                 |
|   —낮은 정밀도 (int8/int4) ALU       |
|   —디Quant / 활성화 단위             |
+--------------------------------------+
|  칩 내부 SRAM & KV 캐시 버퍼         |
|   —핫 가중치, 융합된 캐시            |
+--------------------------------------+
|  양자화 / 디Quant 파이프라인          |
+--------------------------------------+
|  스케줄러 / 컨트롤러                  |
|   —정적 그래프 실행 엔진             |
+--------------------------------------+
|  칩 외부 DRAM / HBM 인터페이스        |
+--------------------------------------+
주요 아키텍처 특징은 다음과 같습니다:
- 계산 코어 — int8, int4, 3진 연산에 최적화된稠密 행렬 곱 단위
- 칩 내부 SRAM — 핫 가중치와 KV 캐시를 유지하는 큰 버퍼로, 비용이 높은 DRAM 액세스를 최소화
- 스트리밍 인터커넥트 — 메쉬 토폴로지가 여러 칩으로의 효율적인 확장을 가능하게 함
- 양자화 엔진 — 레이어 간의 실시간 양자화/디Quant
- 컴파일러 스택 — PyTorch/ONNX 그래프를 칩 특정 마이크로-옵으로 직접 변환
- 하드웨어로 고정된 어텐션 커널 — softmax 및 기타 작업의 제어 흐름 오버헤드를 제거
설계 철학은 비트코인 ASIC과 닮았습니다: 모든 트랜지스터가 특정 워크로드에 사용됩니다. 추론이 필요하지 않는 기능에 실리콘을 낭비하지 않습니다.
LLM 추론을 위한 GPU 대 ASIC 벤치마크
대표적인 공개 수치는 동일한 모델 패밀리에서 전용 추론 하드웨어가 범용 GPU 스택에서 어떻게 앞설 수 있는지를 보여줍니다 (항상 자신의 워크로드에 대한 방법론과 배치 가정을 검증하세요):
| 모델 | 하드웨어 | 처리량 (토큰/초) | 첫 번째 토큰까지 시간 | 성능 배율 |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1.7s | 베이스라인 (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0.22s | 3–18배 더 빠름 |
| Llama-3.3-70B | Groq LPU | ~276 | ~0.2s | 일관된 3배 |
| Gemma-7B | Groq LPU | 814 | <0.1s | 5–15배 더 빠름 |
| Llama-3.1-8B | Taalas HC1 (벤더) | ~16k–17k 디코딩 t/s/사용자 | — | 독립 축 (고정된 8B 그래프, 70B 아님) |
출처: Groq.com, ArtificialAnalysis.ai, NVIDIA Developer Blog; Taalas HC1 수치는 회사의 제품 게시물에서 가져왔습니다.
Groq 집중 행들은 대용량 모델에서 고급 GPU 베이스라인 대비 처리량과 첫 번째 토큰까지 시간에서 크게 이득을 보여줍니다. Taalas 행은 70B 라인에 대한 또 다른 배율이 아닙니다; 그것은 모델과 그래프가 실리콘에 고정되었을 때, 유연성의 대가로 사용자별 디코딩을 얼마나 밀어붙일 수 있는지를 보여줍니다.
추론 실리콘을 전문화할 때의 트레이드오프
전문화는 성능을 구매하지만, 제품 및 엔지니어링 리스크를 재도입합니다:
-
유연성 대 효율성. 완전히 고정된 ASIC은 오늘날의 Transformer 모델에서는 경이롭게 빨라지지만 내일의 아키텍처에서는 고군분투할 수 있습니다. 어텐션 메커니즘이 진화하거나 새로운 모델 패밀리가 등장하면 어떻게 될까요? 이것은 가정이 아닙니다 — 상태 공간 모델, 확산 언어 모델, JEPA 월드 모델은 이미 모델 측면에서 Transformer의 지배력을 도전하고 있으며; 이러한 아키텍처가 하드웨어로 고정된 Transformer 실리콘을 어디로 이끌 수 있는지 확인하려면 LLM 이후에 오는 것을 참조하세요.
-
양자화와 정확도. 낮은 정밀도는 막대한 양의 전력을 절약하지만, 정확도 열화를 관리하려면 정교한 양자화 스키마가 필요합니다. 모든 모델이 4-bit 이하로 우아하게 양자화되는 것은 아닙니다.
-
소프트웨어 생태계. 강력한 컴파일러, 커널, 프레임워크가 없는 하드웨어는 쓸모없습니다. NVIDIA가 여전히 지배적인 이유는 대부분 CUDA의 성숙한 생태계 때문입니다. 새로운 칩 제조업체는 소프트웨어에 상당한 투자를 해야 합니다.
-
비용과 리스크. 칩 테이핑 아웃은 수천만 달러가 들며 12~24개월이 걸립니다. 스타트업에게는 유지되지 않을 수 있는 아키텍처 가정에 대한 거대한 베팅입니다.
그래도, 하이퍼스케일에서는 2배의 효율성 향상조차 수십억 달러의 절감으로 이어집니다. 초당 수백만 개의 추론 요청을 실행하는 클라우드 프로바이더에게는, 맞춤형 실리콘은 점점 더 선택이 아닌 필수가 되고 있습니다.
LLM 추론 칩을 위한 소망 목록 사양
| 기능 | 이상적인 사양 |
|---|---|
| 프로세스 | 3–5nm 노드 |
| 칩 내부 SRAM | 100MB+ 강하게 결합된 |
| 정밀도 | int8 / int4 / 3진 네이티브 지원 |
| 처리량 | 500+ 토큰/초 (70B 모델) |
| 지연 시간 | 첫 번째 토큰까지 <100ms |
| 인터커넥트 | 낮은 지연 메쉬 또는 광학 링크 |
| 컴파일러 | PyTorch/ONNX → 마이크로코드 도구 체인 |
| 에너지 | 토큰당 <0.3 줄 |
전망 (2026–2030)
추론 하드웨어 지형이 세 개의 거친 계층으로 분화될 것으로 기대합니다:
-
학습 칩. NVIDIA B200 및 AMD Instinct MI400과 같은 고급 GPU는 FP16/FP8 유연성과 막대한 메모리 대역폭을 통해 학습을 계속 지배할 것입니다.
-
추론 ASIC. 하드웨어로 고정된, 낮은 정밀도의 Transformer 가속기는 하이퍼스케일에서 생산 서빙을 처리하며, 비용과 효율성을 위해 최적화될 것입니다.
-
엣지 NPU. 작고 초고효율적인 칩은 양자화된 LLM을 스마트폰, 차량, IoT 기기, 로봇으로 가져와 클라우드 의존성 없이 온-디바이스 지능을 가능하게 할 것입니다.
하드웨어 외에도, 우리는 다음을 볼 것입니다:
- 하이브리드 클러스터 — 유연한 학습을 위한 GPU, 효율적인 서빙을 위한 ASIC (또는 웨이퍼 스케일 추론 엔진)
- 추론-as-a-Service — 자체 가속기(AWS Inferentia, Google TPU 등)와 GPU를 혼합하는 하이퍼스케일러
- 하드웨어-소프트웨어 공동 설계 — 블록 희소성, MoE 라우팅, 양자화 친화적 레이어를 위한 모양이 잡힌 모델
- 모델별 또는 패밀리별 실리콘 — 알려진 그래프에서 아키텍처 유연성을 극단의 비용과 지연 시간으로 교환할 배포가 있을 것이라고 베팅하는 Taalas와 같은 회사
- 오픈 추론 API — 실리콘이 포터블하지 않더라도 서빙 인터페이스를 포터블하게 유지하기 위한 압박
최종 생각
“AI 추론의 ASIC-화”는 이미 진행 중입니다. 비트코인 마이닝이 CPU에서 전용 실리콘으로 진화했듯이, AI 배포는 같은 경로를 따르고 있습니다.
AI의 다음 혁명은 더 큰 모델에 관한 것이 아닐 것입니다 — 더 나은 칩에 관한 것이 될 것입니다. Transformer 추론의 특정 패턴에 최적화된 하드웨어가 경제적 대규모로 AI를 배포할 수 있는 사람을 결정할 것입니다.
비트코인 마이너가 낭비된 와트 하나까지 최적화했듯이, 추론 하드웨어는 마지막 FLOP-per-joule까지 짜내겠습니다. 그것이 일어날 때, 진정한 돌파구는 알고리즘이 아니라 — 그것들을 실행하는 실리콘이 될 것입니다.
AI의 미래는 실리콘에 각인되고 있으며, 트랜지스터 하나씩 진행되고 있습니다.
더 많은 벤치마크, 하드웨어 선택, 성능 튜닝에 대해서는 LLM 성능: 벤치마크, 병목 현상 및 최적화 허브를 확인하세요.
유용한 링크
- Groq 공식 벤치마크
- Taalas — 보편적 AI로 가는 길 (HC1, 로드맵, 철학)
- Chat Jimmy — Taalas Llama 3.1 8B 데모
- Taalas API 접근 신청서
- Artificial Analysis - LLM 성능 리더보드
- NVIDIA H100 기술 요약
- Etched AI - Transformer ASIC 발표
- Cerebras Wafer-Scale Engine
- 호주에서 NVidia RTX 5080 및 RTX 5090 가격 - 2025년 10월
- LLM 성능과 PCIe 레인: 주요 고려 사항
- 대규모 언어 모델 속도 테스트
- AI를 위한 NVidia GPU 적합성 비교
- Quadro RTX 5880 Ada 48GB는 어떤가요?
