
오픈 모델의 효율적 프론티어: 2026년의 최적의 균형점 찾기
2026년 오픈 LLM의 최적 구간: 약 30B
2026년 9월, 오픈 모델의 효율적 프런티어(efficient frontier)는 25B~34B 파라미터 사이에 위치합니다: 24 GB 단일 GPU에서 프런티어에 근접한 에이전틱 작업을 수행할 수 있으면서, 70B급 하드웨어의 일부 비용으로만 가능합니다.
2026년 오픈 LLM의 최적 구간: 약 30B
2026년 9월, 오픈 모델의 효율적 프런티어(efficient frontier)는 25B~34B 파라미터 사이에 위치합니다: 24 GB 단일 GPU에서 프런티어에 근접한 에이전틱 작업을 수행할 수 있으면서, 70B급 하드웨어의 일부 비용으로만 가능합니다.
16GB에서 128K 컨텍스트가 실패하는 이유
모델은 128K 컨텍스트 윈도우를 광고하면서도 16 GB GPU에서 40K 토큰에서 실패할 수 있습니다. 아키텍처 상한은 웨이트, KV 캐시, 컴퓨트 버퍼, 데스크톱 컴포지터가 모두 동시에 해당 카드에 들어맞겠다는 약속을 한 적이 없습니다.
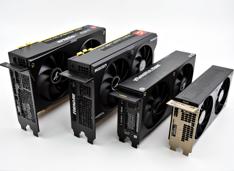
3개 벤더 간 AI GPU 비교
2026년 AI 하드웨어 시장은 크게 변화했습니다. NVIDIA, AMD, 인텔은 모두 로컬 대규모 언어 모델(LLM)과 AI 추론 워크로드를 처리할 수 있는 GPU를 필요로 하는 개발자들을 두고 치열한 경쟁을 벌이고 있습니다.
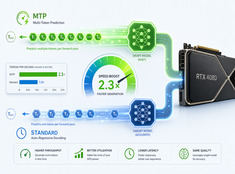
RTX 4080에서 MTP와 표준 디코딩 비교 — 실제 벤치마크
Qwen 3.6 27B와 35B 모델에서 RTX 4080 16 GB VRAM 환경의 스펡추레이티브 디코딩(Speculative decoding, Multi-Token Prediction, MTP) 성능을 테스트했습니다.
16GB VRAM에서 llama.cpp의 토큰 처리 속도(테이블)
여기서는 16GB VRAM을 갖춘 GPU에서 구동되는 여러 LLM의 속도를 비교하고, 자가 호스팅에 가장 적합한 모델을 선택하는 과정을 다루고 있습니다.
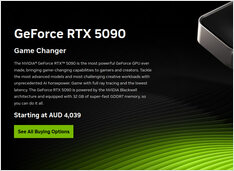
호주에서는 RTX 5090 가 품귀 현상을 보이고 가격이 비쌉니다.
호주에 RTX 5090 재고가 있습니다. 마침내. 하지만 하나를 찾아도 현실과 동떨어진 프리미엄 가격을 지불해야 합니다.
GPU 및 영구 저장 기능을 갖춘 Compose 우선 Ollama 서버
Ollama는 베어 메탈(bare metal) 환경에서도 훌륭하게 작동합니다. 서비스처럼 다룰 때 더 재미가 생깁니다: 안정적인 엔드포인트, 고정된 버전, 영속적 저장소, 그리고 사용 가능하거나 불가능한 GPU.
RTX 4080 (16GB VRAM)에서 LLM 속도 테스트
로컬에서 대규모 언어 모델(Large Language Models, LLM)을 실행하면 개인 정보 보호, 오프라인 사용성, 그리고 제로 API 비용을 얻을 수 있습니다. 이 벤치마크는 RTX 4080에서 Ollama를 통해 실행된 14가지 인기 LLM의 성능을 RTX 4080으로 측정하기에서 무엇을 기대할 수 있는지를 정확히 보여줍니다.
Linux 워크플로우에 맞는 올바른 터미널을 선택하세요
Linux 사용자에게 가장 필수적인 도구 중 하나는 터미널 에뮬레이터입니다.
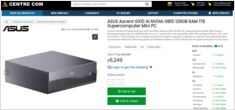
지금 호주 현지 소매업체의 실제 AUD 가격
NVIDIA DGX Spark (GB10 Grace Blackwell) 은 이제 주요 PC 판매점에서 재고 상태로 호주에서도 구매 가능 합니다. 전 세계 DGX Spark 가격과 가용성 을 지켜보셨다면, 호주의 가격은 저장 구성과 판매처에 따라 6,249 호주 달러에서 7,999 호주 달러 사이임을 알게 되시면 흥미로워하실 것입니다.
AI 에 적합한 소비자용 GPU 가격 – RTX 5080 과 RTX 5090
특히 LLM 과 일반적인 AI 에 적합한 최상위 소비자용 GPU 의 가격을 비교해 보겠습니다. 구체적으로는 RTX-5080 과 RTX-5090 가격 에 초점을 맞추고 있습니다.
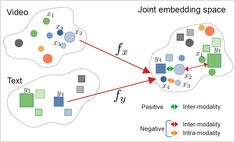
텍스트, 이미지 및 오디오를 공유된 임베딩 공간에 통합하세요.
크로스모달 임베딩은 인공지능 분야에서의 중요한 돌파구로, 다양한 데이터 유형을 하나의 통합된 표현 공간 내에서 이해하고 추론하는 것을 가능하게 합니다.
오픈 모델로 저비용 하드웨어에서 엔터프라이즈 AI 배포
AI 의 민주화는 이제 현실이 되었습니다. Llama, Mistral, Qwen 과 같은 오픈소스 LLM 이 독점 모델들과 경쟁할 수준에 도달함에 따라, 팀들은 소비자용 하드웨어를 활용한 AI 인프라 구축 을 통해 비용을 절감하면서도 데이터 프라이버시와 배포에 대한 완전한 통제를 유지할 수 있게 되었습니다.
Docker 모델 러너에서 컨텍스트 크기 구성 및 대안 마련
Docker 모델 러너에서 컨텍스트 크기 구성은 예상보다 더 복잡한 경우가 많습니다.

텍스트 지시문으로 이미지를 강화하는 AI 모델
블랙 포레스트 랩스는 텍스트 지시문을 사용하여 기존 이미지를 향상시키는 고급 이미지에서 이미지로 생성하는 AI 모델인 FLUX.1-Kontext-dev를 출시했습니다.
NVIDIA CUDA 지원을 통해 Docker 모델 실행기에서 GPU 가속을 활성화하세요.
Docker Model Runner은 AI 모델을 로컬에서 실행하는 Docker의 공식 도구이지만,
Docker Model Runner에서 NVidia GPU 가속 기능 활성화
은 특정 설정이 필요합니다.