
Optymalizacja kosztów w systemach LLM: gdzie naprawdę idą pieniądze
Wykorzystuj tokeny tam, gdzie naprawdę liczą się one najbardziej.
Koszt LLM-ów rośnie liniowo wraz z wolumenem używania. System przetwarzający 10 000 zapytań dziennie przy cenie 0,01 USD za zapytanie kosztuje 100 USD dziennie — 365 USD rocznie. W skali przedsiębiorstwa to ponad 10 000 USD.
Optymalizacja kosztów nie polega na oszczędzaniu na wszystkim. Polega na wydatkowaniu tokenów tam, gdzie ma to znaczenie.
Każdy token, który marnujesz, to token, który mógłbyś wydać na lepszą odpowiedź.
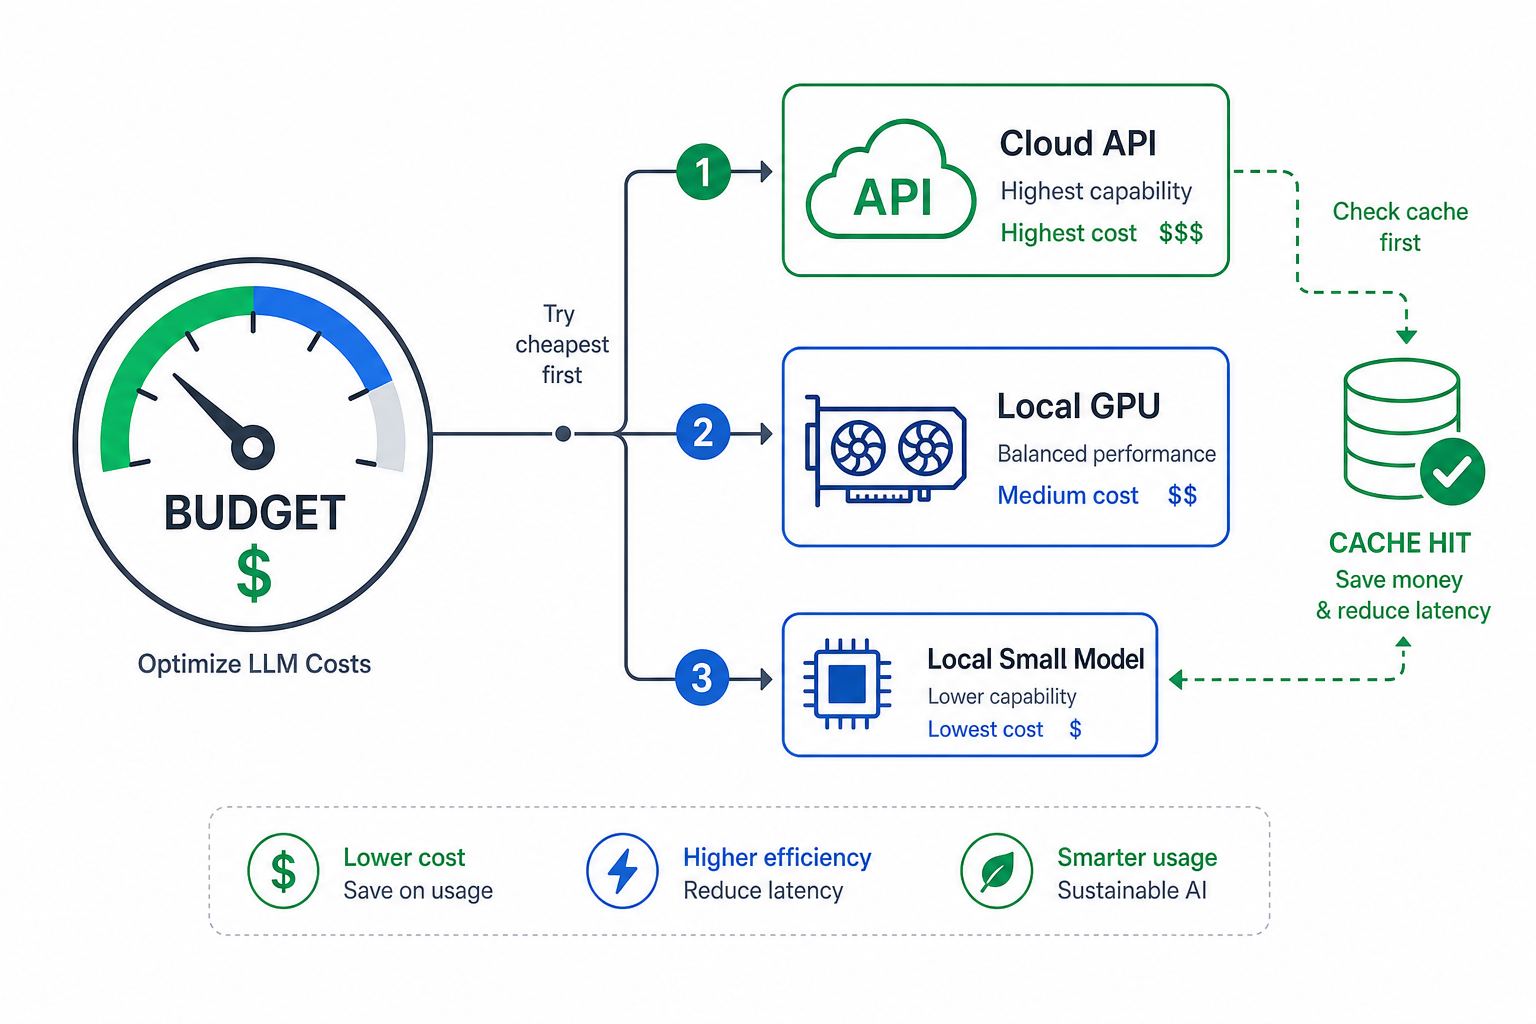
Budżetowanie tokenów
Najprostszym sposobem na kontrolę kosztów jest ustawienie limitów. Per sesja, per zadanie lub per dzień.
Strategia 1: Budżety per sesja
Budżety per sesja są proste w zrozumieniu:
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
Strategia 2: Budżety per zadanie
Budżety per zadanie są bardziej użyteczne. Różne zadania wymagają różnych ilości kontekstu:
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
Strategia 3: Budżety adaptacyjne
Budżety adaptacyjne dostosowują się do tego, co faktycznie się dzieje. Jeśli zadania klasyfikacyjne konsekwentnie zużywają 80 tokenów, przestań alokować 100:
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
Eksponencjalna średnia krocząca (waga 0.9) oznacza, że ostatnie zużycie ma większe znaczenie niż historia. Dostosuj wagę w zależności od zmienności Twoich obciążeń.
Inferencja API vs lokalna
Inferencja lokalna jest tańsza przy dużych wolumenach. Punkt zwrotny zależy od Twojego sprzętu i stawek API.
| Model | API (USD/M tokenów) | Koszt lokalny/godzina | Punkt zwrotny |
|---|---|---|---|
| GPT-4o | 2,50 / 10,00 | — | N/D |
| Claude Sonnet 4 | 3,00 / 15,00 | — | N/D |
| Qwen2.5-72B | 0,50 / 2,00 | ~0,50 | ~4 godziny/dzień |
| qwen3-32b | 0,30 / 1,20 | ~0,20 | ~2 godziny/dzień |
| qwen3-8b | 0,10 / 0,40 | ~0,05 | ~1 godzina/dzień |
Matematyka sprzętu:
| Sprzęt | Koszt początkowy | Miesięczny prąd | Punkt zwrotny vs API |
|---|---|---|---|
| RTX 3090 (używana) | 600 | 15 | ~4 miesiące |
| RTX 4090 | 1500 | 20 | ~6 miesięcy |
| RTX 5080 | 1000 | 18 | ~5 miesięcy |
| DGX Spark | 2000 | 30 | ~8 miesięcy |
Przy umiarkowanym użyciu — godzinie lub więcej dziennie — inferencja lokalna zwraca się. Przy intensywnym użyciu oszczędności są ogromne. Haczykiem jest kapitał początkowy. RTX 5080 kosztuje 1000 USD. Rachunek za API można wstrzymać. Sprzętu nie.
Ta kalkulacja punktu zwrotnego zakłada, że masz swobodę zmiany dostawcy, co często jest większą niewiadomą niż koszt sprzętu. Jeśli Twoje dane do dostrojenia, testy oceniające i schematy narzędzi są już zbudowane wokół API jednego dostawcy, rzeczywisty koszt migracji to czas inżynierski potrzebny na porzucenie tej zależności — a nie cena GPU. Ciężar danych: Prawdziwy koszt AI opartego na API opisuje ten mechanizm blokady oraz checklistę do oceny, jak głęboko już w niego wszedłeś, zanim przystąpisz do tych obliczeń.
Strategie awaryjne (Fallback)
Kiedy Twój preferowany model jest zbyt drogi lub zbyt wolny, użyj tańszego rozwiązania awaryjnego. Kluczem jest wiedza, kiedy jakość jest „dostatecznie dobra".
Strategia 1: Fallback oparty na jakości
Fallback oparty na jakości próbuje modeli, dopóki wynik nie spełni progu:
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
Problemem jest sama ocena. Jak zmierzyć jakość, nie wywołując innego modelu? Niektóre systemy używają małego klasyfikatora. Inne używają sprawdzianów heurystycznych — długości, struktury, obecności słów kluczowych. Żadne z nich nie jest idealne.
Strategia 2: Fallback oparty na opóźnieniu
Fallback oparty na opóźnieniu jest prostszy. Kieruj do najszybszego modelu, który spełnia Twój budżet czasowy:
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
Cache’owanie
Cache’owanie jest najbardziej niedocenianą optymalizacją kosztów. Identyczne zapytania zdarzają się częściej, niż myślisz — żądania klasyfikacyjne, zapytania w stylu FAQ, powtarzane wywołania narzędzi.
Strategia 1: Cache’owanie promptów
Cache’owanie dokładnych promptów jest proste:
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
Strategia 2: Cache’owanie semantyczne
Cache’owanie semantyczne jest bardziej użyteczne. Łapie prompty, które są różne, ale oznaczają to samo:
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
Próg ma znaczenie. 0,95 jest agresywny — tylko bardzo podobne prompty pasują. 0,85 jest bardziej wyrozumiały, ale ryzykuje zwrócenie błędnych odpowiedzi. Mierz swój wskaźnik braku trafień (miss rate) i dostosuj.
Cache’owanie odpowiedzi dla powszechnych zapytań również się opłaca. Jeśli użytkownicy często pytają „jaka jest pogoda" lub „kiedy jest godzina", cache’uj wzorzec, a nie tylko dokładny prompt:
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
To nie jest zaawansowane, ale działa. Powszechne zapytania są powszechne z jakiegoś powodu.
Kiedy optymalizacja pomaga
Optymalizacja ma znaczenie, gdy przetwarzasz duże wolumeny, uruchamiasz mieszane obciążenia lub płacisz koszty API, które się sumują.
Nie ma znaczenia, gdy prototypujesz, używasz pojedynczego modelu lub przetwarzasz małe wolumeny. Złożoność budżetowania, fallbacku i cache’owania nie jest warta tego dla systemu wykonującego 100 zapytań dziennie.
Najpierw spraw, aby podstawowy przepływ działał. Dodaj optymalizację, gdy rachunek się pojawi.
Kompromisy (Tradeoffs)
| Strategia | Koszt | Jakość | Złożoność |
|---|---|---|---|
| Brak optymalizacji | Najwyższy | Spójna | Najniższa |
| Budżetowanie tokenów | Umiarkowany | Zmienna | Średnia |
| Modele awaryjne | Niski-Umiarkowany | Zmienna | Średnia |
| Cache’owanie | Najniższy | Wysoka (dla trafień w cache) | Średnia |
| Hybrydowa | Zoptymalizowana | Zoptymalizowana | Najwyższa |
Systemy produkcyjne zwykle działają w trybie hybrydowym. Budżet per sesja, fallback na podstawie jakości lub opóźnienia, cache’owanie wszystkiego, co się da. Złożoność jest realna, ale oszczędności również.
Powiązane
- Ciężar danych: Prawdziwy koszt AI opartego na API — dlaczego powyższa kalkulacja punktu zwrotnego to tylko połowa decyzji o hostowaniu własnym
- Sprawna granica otwartych modeli w 2026 roku — ekonomia rozmiaru modelu stojąca za punktem zwrotnym: model 27B na jednym wynajętym 4090 w porównaniu z bieżącymi cenami tokenów Sonnet
- Strategie routingu modeli — routing oparty na możliwościach, kosztach i opóźnieniach
- Guardraile LLM w praktyce — walidacja wejścia, filtrowanie wyjścia, bezpieczeństwo
- Projektowanie systemów wielomodelowych — architektura dla wielu modeli
- Architektura LLM — filar projektowania systemów: routing, koszty, guardraile i orkiestracja
