
Projektowanie systemów wielomodelowych: Kiedy jeden model to za mało
Wybierz najprostszy wzorzec, który spełnia zadanie.
Systemy oparte na pojedynczym modelu są proste. Systemy wielomodelowe są potężne. Wyzwanie nie polega na wyborze modeli – ale na zaprojektowaniu architektury, która je orkiestruje.
System wielomodelowy nie dotyczy posiadania większej liczby modeli. Chodzi o to, aby mieć odpowiedni model do odpowiedniego zadania w odpowiednim czasie.
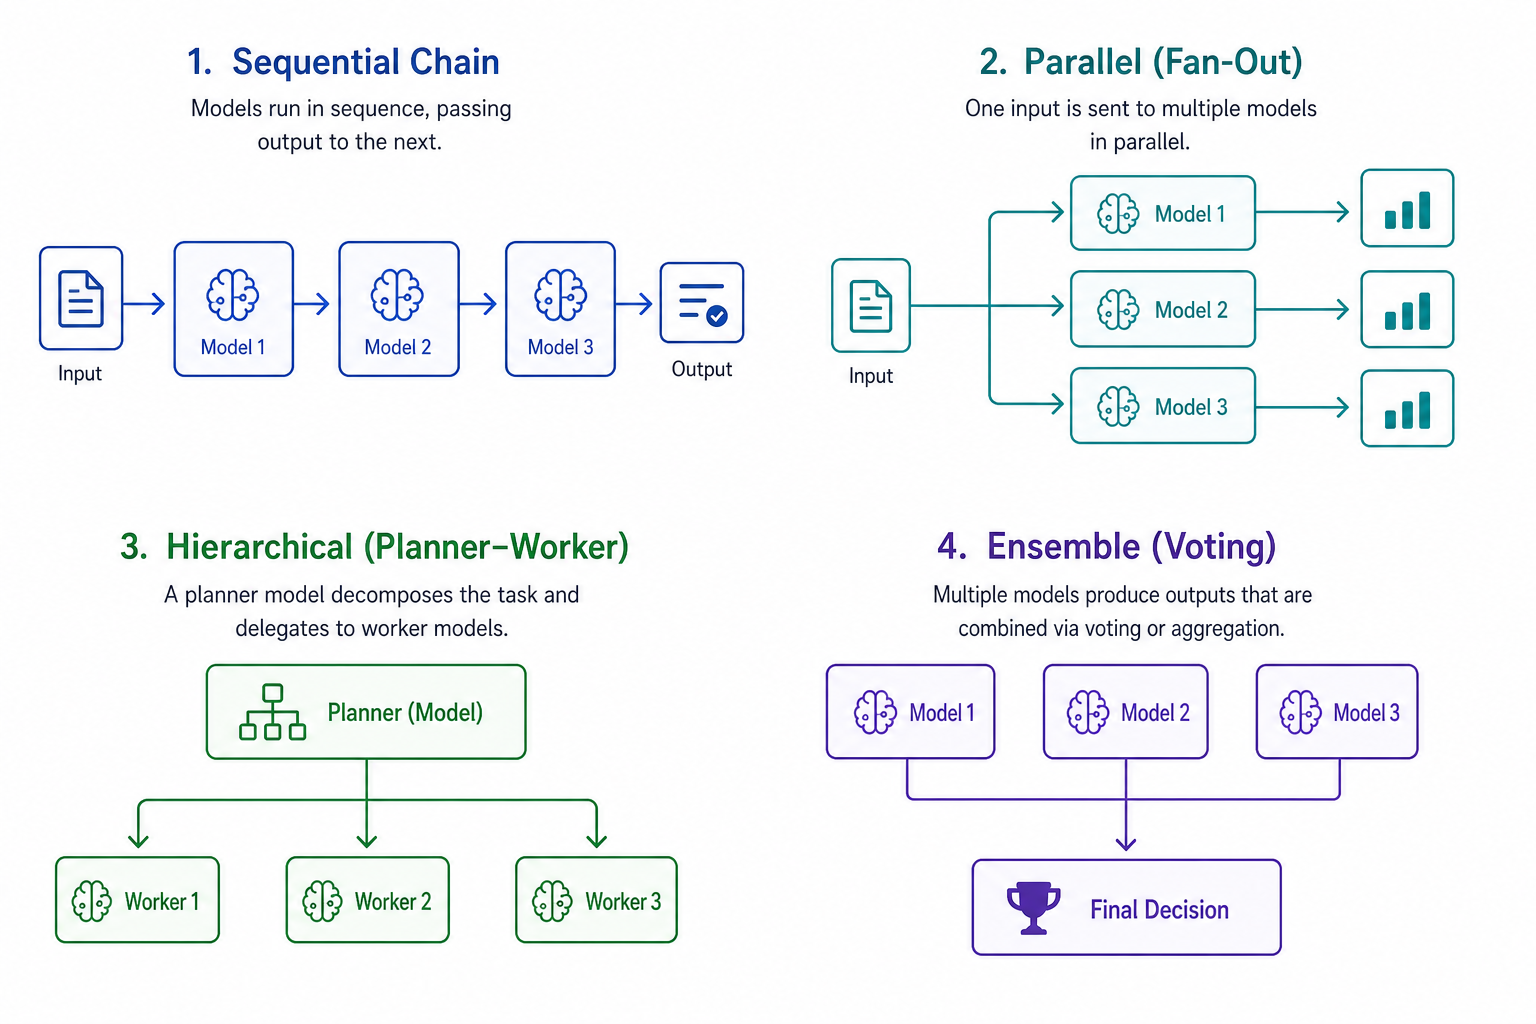
Wzorce architektoniczne
Pięć wzorców pokrywa większość zastosowań:
| Wzorzec | Złożoność | Kiedy stosować | Kompromis |
|---|---|---|---|
| Pojedynczy model | Najniższa | Prototypowanie, proste zadania | Ograniczone możliwości |
| Sekwencyjny | Niska | Prace wieloetapowe | Wyższa latencja |
| Równoległy | Średnia | Niezależne zadania | Wyższy koszt |
| Hierarchiczny | Wysoka | Złożone rozumowanie | Złożona orkiestracja |
| Zbiorowy (Ensemble) | Najwyższa | Krytyczne decyzje | Najwyższy koszt |
Wybierz najprostsze rozwiązanie, które działa. Złożoność jest realna i narasta kaskadowo.
Architektura sekwencyjna
Przetwarzaj zadania za pomocą łańcucha modeli, gdzie każdy specjalizuje się w konkretnym etapie.
Wzorzec 1: Linia produkcyjna (Pipeline)
Wzorzec linii produkcyjnej – wyjście jednego modelu jest wejściem dla następnego:
class ModelPipeline:
    def __init__(self):
        self.models = [
            {"model": "qwen3-1.7b", "task": "classify"},
            {"model": "qwen3-8b", "task": "extract"},
            {"model": "qwen3-32b", "task": "reason"},
        ]

    def process(self, input: str) -> str:
        current = input
        for model_config in self.models:
            current = self.call_model(
                model_config["model"],
                self.create_prompt(model_config["task"], current)
            )
        return current
Latencja się kumuluje. Trzy modele w sekwencji oznaczają trzykrotnie większą latencję. Stosuj ten wzorzec tylko wtedy, gdy każdy etap faktycznie wymaga innego modelu.
Wzorzec 2: Router
Wzorzec routera – sklasyfikuj zadanie, a następnie skieruj je do specjalisty:
class ModelRouter:
    def __init__(self):
        self.classifier = "qwen3-1.7b"
        self.specialists = {
            "code": "qwen2.5-coder-7b",
            "math": "qwen3-32b",
            "creative": "claude-sonnet-4",
            "general": "qwen3-8b",
        }

    def route(self, prompt: str) -> str:
        task_type = self.classify(prompt)
        model = self.specialists.get(task_type, self.specialists["general"])
        return self.call_model(model, prompt)
Klasyfikator jest elementem najsłabszym. Jeśli sklasyfikuje zadanie błędnie, zostanie ono skierowane do niewłaściwego modelu, co pogorszy jakość wyniku. Używaj klasyfikatora, który jest wystarczająco dobry – nawet mały model zadziała, o ile kategorie są jasno zdefiniowane.
Architektura równoległa
Przetwarzaj niezależne zadania jednocześnie.
Wzorzec 1: Rozrzut (Fan-Out)
Rozrzut – uruchom ten sam prompt w wielu modelach:
import asyncio

class ModelFanOut:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    async def process(self, prompt: str) -> list[str]:
        tasks = [self.call_model(model, prompt) for model in self.models]
        return await asyncio.gather(*tasks)
Przydatne do porównań, testów A/B lub kiedy chcesz wybrać najlepszy wynik. Jest to kosztowne, ale zysk na jakości jest warty ceny w przypadku krytycznych decyzji.
Wzorzec 2: Głosowanie (Voting)
Głosowanie – łączenie wyników poprzez konsensus:
class ModelVoting:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    def vote(self, prompt: str) -> str:
        responses = [self.call_model(model, prompt) for model in self.models]
        from collections import Counter
        votes = Counter(responses)
        return votes.most_common(1)[0][0]
Głosowanie większościowe działa w przypadku klasyfikacji. W zadaniach generatywnych jest trudniejsze – potrzebujesz podobieństwa semantycznego, a nie dokładnych zbieżności.
Architektura hierarchiczna
Używaj modeli na różnych poziomach abstrakcji.
Wzorzec 1: Planista-Executor
Planista-executor – potężny model planuje, a mniejsze modele wykonują zadania:
class PlannerExecutor:
    def __init__(self):
        self.planner = "qwen3-32b"
        self.executors = {
            "code": "qwen2.5-coder-7b",
            "search": "qwen3-8b",
            "math": "qwen3-8b",
        }

    def process(self, task: str) -> str:
        plan = self.call_model(self.planner, f"Plan: {task}")
        results = []
        for step in self.parse_plan(plan):
            executor = self.executors.get(step["type"], "qwen3-8b")
            result = self.call_model(executor, step["prompt"])
            results.append(result)
        return self.call_model(self.planner, f"Synthesize: {results}")
Planista wykonuje główną pracę. Executorzy zajmują się konkretnymi zadaniami. Ten wzorzec sprawdza się dobrze, gdy etap planowania jest kosztowny, ale etapy wykonania są tanie.
Wzorzec 2: Przewodnik-Pracownik
Przewodnik-pracownik – przewodnik deleguje zadania i przegląda wyniki:
class SupervisorWorker:
    def __init__(self):
        self.supervisor = "qwen3-32b"
        self.workers = ["qwen3-8b", "qwen2.5-coder-7b"]

    def process(self, task: str) -> str:
        assignments = self.call_model(self.supervisor, f"Assign: {task}")
        results = []
        for assignment in self.parse_assignments(assignments):
            result = self.call_model(
                assignment["worker"], assignment["task"]
            )
            results.append(result)
        return self.call_model(self.supervisor, f"Review: {results}")
Przewodnik jest wąskim gardłem. Planuje, deleguje i przegląda. Upewnij się, że jest wystarczająco szybki, w przeciwnym razie cały system spowolni.
Architektura zbiorowa (Ensemble)
Łącz wiele modeli dla krytycznych decyzji.
Wzorzec 1: Zbiorowość ważona
Zbiorowość ważona – oceń wynik każdego modelu i wybierz najwyższy:
class WeightedEnsemble:
    def __init__(self):
        self.models = {
            "qwen3-32b": 0.5,
            "claude-sonnet-4": 0.3,
            "qwen3-8b": 0.2,
        }

    def decide(self, prompt: str) -> str:
        responses = {
            model: self.call_model(model, prompt)
            for model in self.models
        }
        scores = {}
        for model, response in responses.items():
            score = self.evaluate(response) * self.models[model]
            scores[response] = scores.get(response, 0) + score
        return max(scores, key=scores.get)
Wagi odzwierciedlają Twój poziom zaufania do każdego modelu. Dostosuj je na podstawie rzeczywistych wyników, a nie benchmarków.
Wzorzec 2: Zbiorowość konsensusowa
Zbiorowość konsensusowa – wymagaj zgodności, a w razie jej braku eskaluj proces:
class ConsensusEnsemble:
    def __init__(self, threshold: float = 0.7):
        self.threshold = threshold
        self.models = [
            "qwen3-32b",
            "claude-sonnet-4",
            "qwen3-8b",
        ]

    def decide(self, prompt: str) -> str:
        responses = [
            self.call_model(model, prompt)
            for model in self.models
        ]
        from collections import Counter
        votes = Counter(responses)
        max_votes = max(votes.values())

        if max_votes / len(self.models) >= self.threshold:
            return votes.most_common(1)[0][0]

        return self.call_model("qwen3-32b", prompt)
Próg kontroluje, jak rygorystyczny musi być konsensus. Wartość 0,7 oznacza zgodność dwóch trzecich. Obniż go dla szybszych decyzji, podnieś dla wyższego poziomu pewności.
Kiedy systemy wielomodelowe mają sens
Systemy wielomodelowe mają sens, gdy masz mieszane obciążenia, potrzebujesz wysokiej jakości dla krytycznych decyzji lub optymalizujesz koszty lub latencję.
Nie mają sensu, gdy wszystkie zadania mają podobną złożoność, znajdujesz się w fazie prototypowania lub prostota jest ważniejsza niż optymalizacja.
Zasada kciukowa: zacznij od jednego modelu. Dodawaj kolejne, gdy natrafisz na realne ograniczenie – koszt, latencję lub jakość. Nie projektuj złożoności, zanim jej nie potrzebujesz.
Kompromisy
| Wzorzec | Koszt | Latencja | Jakość | Złożoność |
|---|---|---|---|---|
| Pojedynczy model | Najniższy | Najniższa | Zmienna | Najniższa |
| Sekwencyjny | Średni | Wysoka | Wysoka | Średnia |
| Równoległy | Wysoki | Niska | Wysoka | Średnia |
| Hierarchiczny | Wysoki | Wysoka | Najwyższa | Wysoka |
| Zbiorowy (Ensemble) | Najwyższy | Średnia | Najwyższa | Najwyższa |
Każdy wzorzec wiąże się z pewnymi kompromisami. Wybierz ten, który najlepiej odpowiada Twoim ograniczeniom.
Powiązane
- Strategie routingu modeli – routing oparty na możliwościach, kosztach i latencji
- Optymalizacja kosztów systemów LLM – budżetowanie tokenów, modele awaryjne, cache
- Guardrails dla LLM w praktyce – walidacja wejścia, filtrowanie wyjścia, bezpieczeństwo
- LLM decyzyjne: Kiedy model powinien decydować – i kiedy nie powinien – które decyzje model może podjąć w orkiestracji i jak je zweryfikować
- Architektura LLM – filar projektowania systemów: routing, koszty, guardrails i orkiestracja
- Wzorce orkiestracji wieloagentowej – odrębne od routingu wielomodelowego: obejmuje to, jak wiele autonomicznych agentów koordynuje się, a nie jak zadania są routowane między modelami
