
Routerowanie modeli: przestań używać jednego modelu do wszystkiego
Dopasuj odpowiedni model do właściwego zadania.
Uruchamianie modelu o 70 miliardach parametrów w celu podsumowania maila na 200 słów to marnotrawstwo. Używanie 3-miliardowego modelu do weryfikacji kodu produkcyjnego jest z kolei nieodpowiedzialne. Większość systemów funkcjonuje gdzieś pomiędzy tymi skrajnościami — i właśnie tutaj wchodzi model routing.
Dopasowuje on złożoność zadania do możliwości modelu. Kompromisy są realne, ale i oszczędności też.
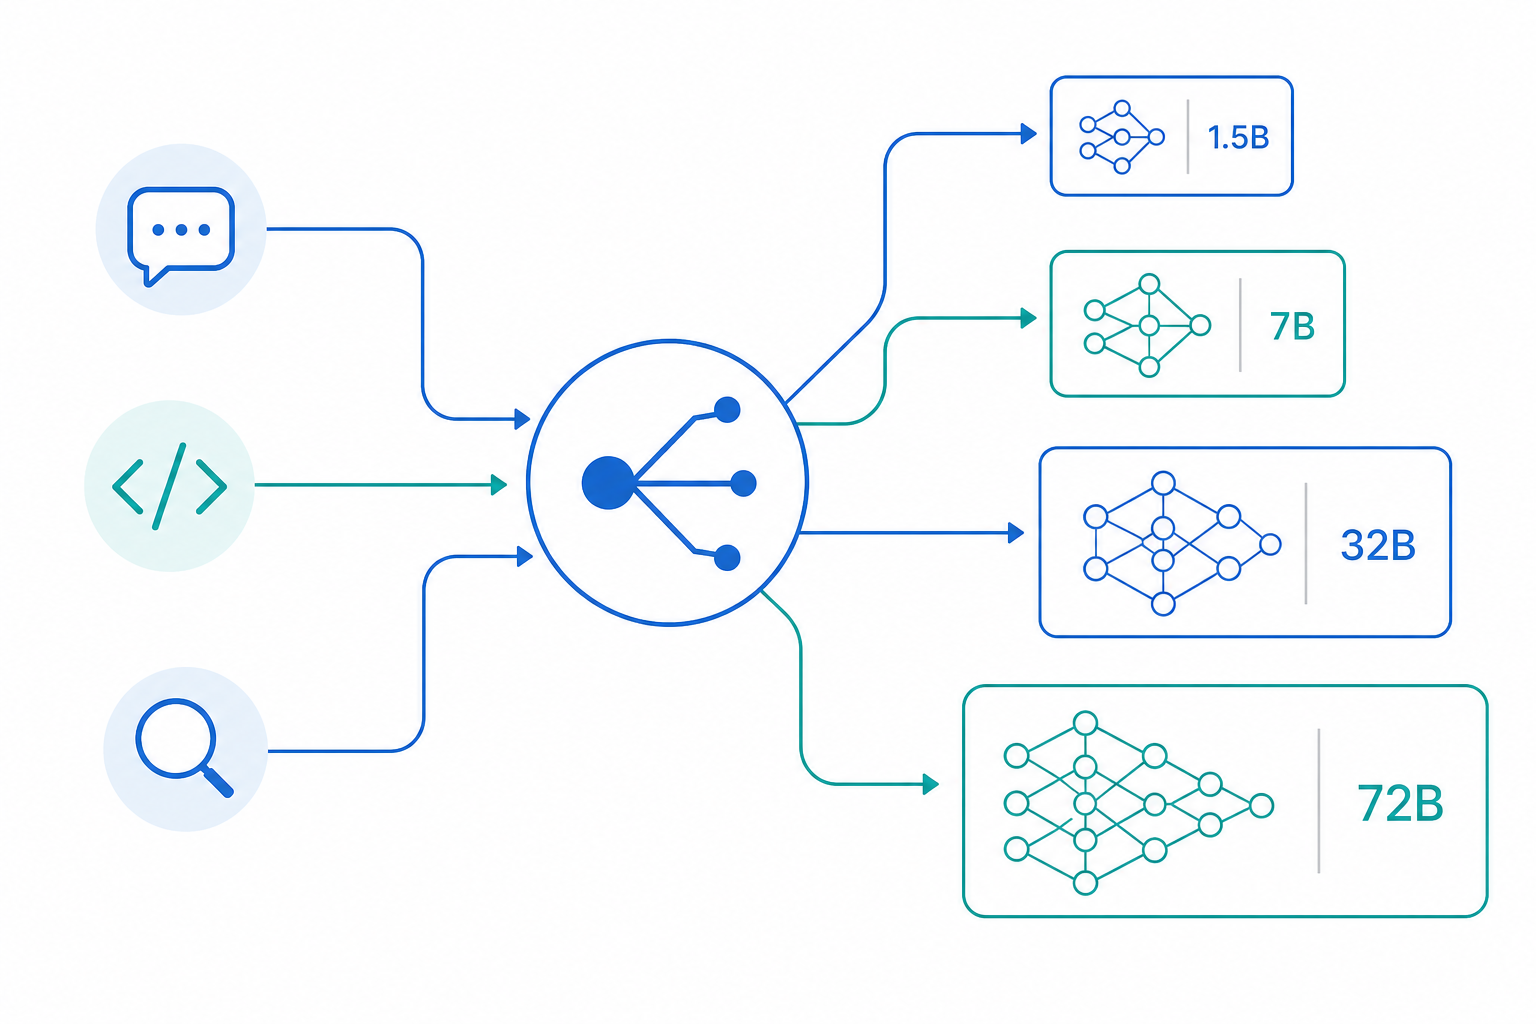
Problem routingu
Ludzie zazwyczaj zaczynają od jednego modelu i trzymają się go. To działa, dopóki nie zauważymy kosztów, opóźnień lub obu tych kwestii jednocześnie. Alternatywą jest zbudowanie routera — czegoś, co decyduje, który model obsłuży dane żądanie.
W praktyce działają cztery strategie:
- Oparty na możliwościach — kierowanie według tego, co model potrafi zrobić
- Oparty na kosztach — kierowanie według tego, ile jesteś gotów wydać
- Oparty na opóźnieniach — kierowanie według tego, jak szybko potrzebujesz wyniku
- Hybrydowy — łączenie powyższych
Każda optymalizuje coś innego. Wybór jednej to zazwyczaj decyzja o tym, co sprawia najwięcej bólu.
Routing oparty na możliwościach
Najprostsze podejście. Zklasyfikuj zadanie i wyślij je do modelu, który je obsługuje.
| Zadanie | Rozmiar modelu | Przykłady |
|---|---|---|
| Klasyfikacja, tagowanie | 1-3B | Qwen3-1.7B, Gemma-2-2B |
| Podsumowywanie, ekstrakcja | 3-7B | Qwen3-8B, Llama-3.1-8B |
| Generowanie kodu | 7-14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| Złożone rozumowanie | 14-32B | Qwen3-32B, Llama-3.1-70B |
| Pisanie kreatywne, analiza | 32B+ | Qwen2.5-72B, Claude, GPT-4 |
Jeśli zadanie nie wymaga większego modelu, nie używaj go. Model 1,5B bez problemu radzi sobie z klasyfikacją sentymentu. Po prostu nie napisze spójnej esej.
Implementacja jest prosta:
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
Haczyk polega na samej klasyfikacji. Jeśli źle określisz typ zadania, skierujesz żądanie do błędnego modelu. Widziałem systemy, które klasyfikowały recenzję kodu jako „podsumowywanie” i bezgłośnie traciły na jakości.
Routing oparty na kosztach
Lokalna inferencja błyszczy w tym kontekście. Modele lokalne są praktycznie darmowe po amortyzacji sprzętu. Karta RTX 5080 zwraca koszt zakupu w około sześć miesięcy przy umiarkowanym użyciu API.
| Model | Wejście ($/M tokenów) | Wyjście ($/M tokenów) | Koszt lokalny/godzinę |
|---|---|---|---|
| GPT-4o | $2.50 | $10.00 | — |
| Claude Sonnet 4 | $3.00 | $15.00 | — |
| Qwen2.5-72B (API) | $0.50 | $2.00 | — |
| Qwen3-32B (lokalnie) | $0.00 | $0.00 | ~$0.10 |
| Qwen3-8B (lokalnie) | $0.00 | $0.00 | ~$0.05 |
Jeśli przetwarzasz tysiące żądań na sesję, nawet 0,05 $ na prąd bije 15 $/M tokenów.
Routing oparty na budżecie cofa się w dół, gdy wydajesz:
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
Jakość spada, gdy przechodzisz na tańsze modele. Zaczynasz od Claude, przechodzisz do Qwen3-32B, a potem do Qwen3-8B. Pod koniec długiej sesji wynik jest wyraźnie gorszy. Czy to ma znaczenie, zależy od tego, co budujesz.
Kierowanie rutynowego ruchu do modelu lokalnego i zarezerwowanie API na przypadki krańcowe ma dodatkową korzyść wykraczającą poza koszty: chroni przed wprawianiem się w ten rodzaj ciężaru danych, w którym każdy fine-tune i zestaw narzędzi do ewaluacji kończy się ukształtowany wokół API jednego dostawcy.
Routing oparty na opóźnieniach
Narzędzia interaktywne potrzebują szybkich pierwszych tokenów. Zlecenia wsadowe mogą czekać. Różnica to zwykle czynnik pięciu w rozmiarze modelu.
| Przypadek użycia | Pierwszy token | Całość | Maks. rozmiar modelu |
|---|---|---|---|
| Czat w czasie rzeczywistym | < 200 ms | < 2 s | < 7B |
| Narzędzia interaktywne | < 500 ms | < 5 s | < 14B |
| Przetwarzanie wsadowe | < 1 s | < 30 s | Dowolny |
| Badania/analiza | < 2 s | < 60 s | Dowolny |
Gdy streamujesz tokeny do użytkownika, to opóźnienie pierwszego tokenu jest tym, co odczuwa. Model 32B zajmujący pół sekundy na start sprawia wrażenie ospałego w porównaniu z modelem 1,5B, który odpowiada natychmiast.
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
Wartości opóźnień są przybliżone — zależą od Twojego sprzętu, kwantyzacji i rozmiaru partii. Zmierz na własnym zestawie.
Strategie awaryjne
Modele się zawieszają. API ogranicza przepustowość. Dochodzi do przekroczeń czasu oczekiwania. Wzorcem, który działa, jest łańcuch awaryjny, uporządkowany od najlepszego do najpewniejszego:
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
Ostatni model w łańcuchu powinien być lokalny. Jest wolniejszy, ale nie zawiedzie z powodu problemu z siecią ani klucza API.
Kiedy routing pomaga
Routing ma sens, gdy Twoje obciążenie jest mieszane. Jeśli w tym samym systemie wykonujesz klasyfikację, podsumowywanie i rozumowanie, router oszczędza pieniądze i czas odpowiedzi.
Nie ma sensu, gdy wszystko, co robisz, ma tę samą złożoność. Wystarczy użyć modelu, który jest dobry w danym zadaniu. Router dodaje niepotrzebną złożoność.
Wczesne prototypowanie to kolejny powód, by go pominąć. Najpierw uzyskaj działanie zadania z jednym modelem, a potem dodaj routing, gdy koszt lub opóźnienia faktycznie staną się problemem.
Kompromisy
Każda strategia routingu optymalizuje coś kosztem czegoś innego:
- Jeden model — najprostszy, najdroższy, spójna jakość
- Oparty na możliwościach — lepsze koszty, wyższa jakość na zadanie, umiarkowana złożoność
- Oparty na kosztach — najtańszy, zmienna jakość, umiarkowana złożoność
- Oparty na opóźnieniach — najszybszy, może pogarszać jakość, umiarkowana złożoność
- Hybrydowy — najlepsze z wszystkiego, najtrudniejszy w implementacji
Systemy produkcyjne zazwyczaj zbiegają się do hybrydowego. Zacznij od routingu opartego na możliwościach, dodaj świadomość kosztów, gdy przyjdzie rachunek, a świadomość opóźnień, gdy użytkownicy zaczną narzekać na wolność.
Powiązane
- Optymalizacja kosztów dla systemów LLM — budżetowanie tokenów, cache, modele awaryjne
- Guardraile dla LLM w praktyce — walidacja wejścia, filtrowanie wyjścia, bezpieczeństwo
- Projektowanie systemów wielomodelowych — architektura dla wielu modeli
- LLM decyzyjne: Kiedy model powinien decydować — a kiedy nie powinien — taksonomia ról decyzyjnych stojąca za wyborem hierarchii, z eskalacją opartą na pewności
- Architektura LLM — filar projektowania systemów: routing, koszty, guardraile i orkiestracja
