
Diseño de sistemas de múltiples modelos: cuando un solo modelo no basta
Elige el patrón más sencillo que funcione.
Los sistemas de un solo modelo son simples. Los sistemas de múltiples modelos son potentes. El desafío no consiste en elegir modelos, sino en diseñar la arquitectura que los orqueste.
Un sistema de múltiples modelos no se trata de tener más modelos. Se trata de tener el modelo adecuado para la tarea adecuada en el momento adecuado.
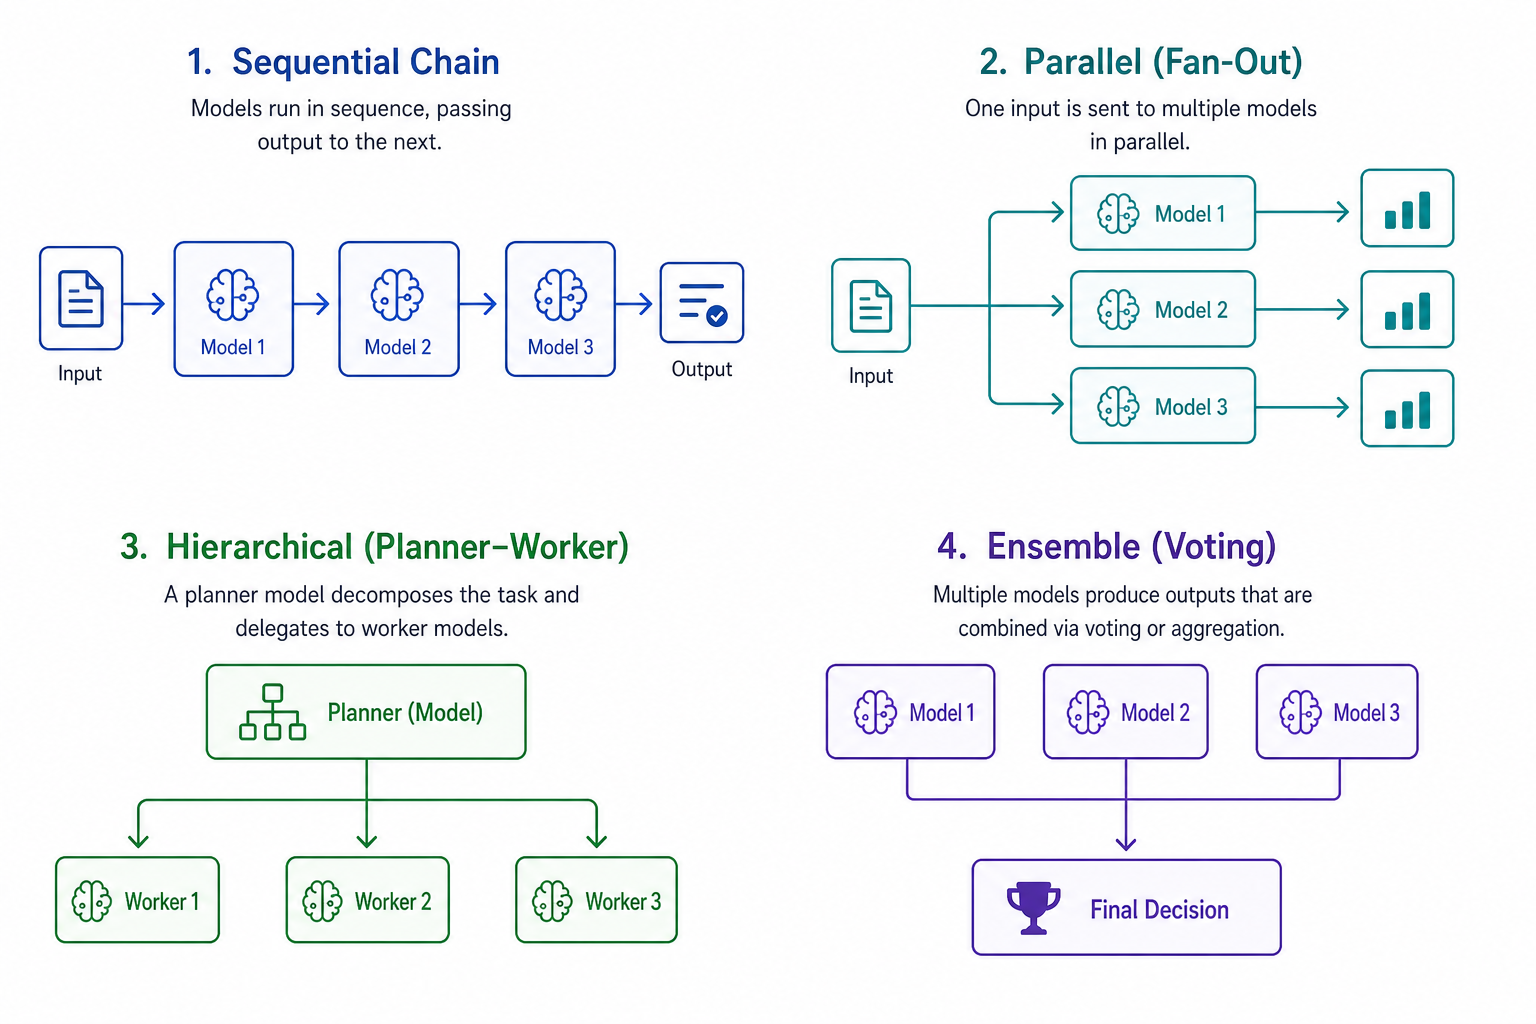
Patrones de arquitectura
Cinco patrones cubren la mayoría de los casos de uso:
| Patrón | Complejidad | Cuándo usarlo | Compensación |
|---|---|---|---|
| Modelo único | Más baja | Prototipado, tareas simples | Capacidad limitada |
| Secuencial | Baja | Flujos de trabajo de múltiples pasos | Mayor latencia |
| Paralelo | Media | Tareas independientes | Mayor costo |
| Jerárquico | Alta | Razonamiento complejo | Orquestación compleja |
| Conjunto (Ensemble) | Más alta | Decisiones críticas | Costo más alto |
Elija el más simple que funcione. La complejidad es real y se acumula.
Arquitectura secuencial
Procesar tareas a través de una cadena de modelos, donde cada uno se especializa en un paso.
Patrón 1: Tubería (Pipeline)
Patrón de tubería: la salida de cada modelo alimenta al siguiente:
class ModelPipeline:
    def __init__(self):
        self.models = [
            {"model": "qwen3-1.7b", "task": "classify"},
            {"model": "qwen3-8b", "task": "extract"},
            {"model": "qwen3-32b", "task": "reason"},
        ]

    def process(self, input: str) -> str:
        current = input
        for model_config in self.models:
            current = self.call_model(
                model_config["model"],
                self.create_prompt(model_config["task"], current)
            )
        return current
La latencia se acumula. Tres modelos en secuencia significan tres veces la latencia. Solo use esto cuando cada paso requiera realmente un modelo diferente.
Patrón 2: Enrutador (Router)
Patrón de enrutador: clasificar la tarea y enrutarla al especialista:
class ModelRouter:
    def __init__(self):
        self.classifier = "qwen3-1.7b"
        self.specialists = {
            "code": "qwen2.5-coder-7b",
            "math": "qwen3-32b",
            "creative": "claude-sonnet-4",
            "general": "qwen3-8b",
        }

    def route(self, prompt: str) -> str:
        task_type = self.classify(prompt)
        model = self.specialists.get(task_type, self.specialists["general"])
        return self.call_model(model, prompt)
El clasificador es el eslabón débil. Si clasifica incorrectamente, se enruta al modelo equivocado y se pierde calidad. Use un clasificador lo suficientemente bueno: incluso uno pequeño funciona si las categorías están claras.
Arquitectura paralela
Procesar tareas independientes simultáneamente.
Patrón 1: Difusión (Fan-Out)
Difusión: ejecutar el mismo indicación (prompt) a través de múltiples modelos:
import asyncio

class ModelFanOut:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    async def process(self, prompt: str) -> list[str]:
        tasks = [self.call_model(model, prompt) for model in self.models]
        return await asyncio.gather(*tasks)
Útil para comparación, pruebas A/B o cuando desea elegir la mejor salida. Es costoso, pero la ganancia en calidad vale la pena para decisiones críticas.
Patrón 2: Votación (Voting)
Votación: combinar salidas a través del consenso:
class ModelVoting:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    def vote(self, prompt: str) -> str:
        responses = [self.call_model(model, prompt) for model in self.models]
        from collections import Counter
        votes = Counter(responses)
        return votes.most_common(1)[0][0]
La votación por mayoría funciona para clasificación. Para tareas de generación, es más difícil: se necesita similitud semántica, no coincidencias exactas.
Arquitectura jerárquica
Usar modelos en diferentes niveles de abstracción.
Patrón 1: Planificador-Executor
Planificador-Executor: un modelo fuerte planifica y modelos más pequeños ejecutan:
class PlannerExecutor:
    def __init__(self):
        self.planner = "qwen3-32b"
        self.executors = {
            "code": "qwen2.5-coder-7b",
            "search": "qwen3-8b",
            "math": "qwen3-8b",
        }

    def process(self, task: str) -> str:
        plan = self.call_model(self.planner, f"Plan: {task}")
        results = []
        for step in self.parse_plan(plan):
            executor = self.executors.get(step["type"], "qwen3-8b")
            result = self.call_model(executor, step["prompt"])
            results.append(result)
        return self.call_model(self.planner, f"Synthesize: {results}")
El planificador realiza el trabajo pesado. Los ejecutores manejan tareas específicas. Este patrón funciona bien cuando el paso de planificación es costoso pero los pasos de ejecución son baratos.
Patrón 2: Supervisor-Empleado
Supervisor-Empleado: un supervisor delega y revisa:
class SupervisorWorker:
    def __init__(self):
        self.supervisor = "qwen3-32b"
        self.workers = ["qwen3-8b", "qwen2.5-coder-7b"]

    def process(self, task: str) -> str:
        assignments = self.call_model(self.supervisor, f"Assign: {task}")
        results = []
        for assignment in self.parse_assignments(assignments):
            result = self.call_model(
                assignment["worker"], assignment["task"]
            )
            results.append(result)
        return self.call_model(self.supervisor, f"Review: {results}")
El supervisor es el cuello de botella. Planifica, delega y revisa. Asegúrese de que sea lo suficientemente rápido, o todo el sistema se ralentizará.
Arquitectura de conjuntos (Ensembles)
Combinar múltiples modelos para decisiones críticas.
Patrón 1: Conjunto ponderado (Weighted Ensemble)
Conjunto ponderado: puntuar la salida de cada modelo y elegir la más alta:
class WeightedEnsemble:
    def __init__(self):
        self.models = {
            "qwen3-32b": 0.5,
            "claude-sonnet-4": 0.3,
            "qwen3-8b": 0.2,
        }

    def decide(self, prompt: str) -> str:
        responses = {
            model: self.call_model(model, prompt)
            for model in self.models
        }
        scores = {}
        for model, response in responses.items():
            score = self.evaluate(response) * self.models[model]
            scores[response] = scores.get(response, 0) + score
        return max(scores, key=scores.get)
Los pesos reflejan su confianza en cada modelo. Adjústelos según el rendimiento real, no según las pruebas de referencia (benchmarks).
Patrón 2: Conjunto de consenso (Consensus Ensemble)
Conjunto de consenso: requerir acuerdo y escalar si no lo hay:
class ConsensusEnsemble:
    def __init__(self, threshold: float = 0.7):
        self.threshold = threshold
        self.models = [
            "qwen3-32b",
            "claude-sonnet-4",
            "qwen3-8b",
        ]

    def decide(self, prompt: str) -> str:
        responses = [
            self.call_model(model, prompt)
            for model in self.models
        ]
        from collections import Counter
        votes = Counter(responses)
        max_votes = max(votes.values())

        if max_votes / len(self.models) >= self.threshold:
            return votes.most_common(1)[0][0]

        return self.call_model("qwen3-32b", prompt)
El umbral controla qué tan estricto es el consenso. 0.7 significa acuerdo de dos tercios. Redúzcalo para decisiones más rápidas, y aumentarlo para mayor confianza.
Cuándo tienen sentido los sistemas de múltiples modelos
Los sistemas de múltiples modelos tienen sentido cuando se tienen cargas de trabajo mixtas, se necesita una alta calidad para decisiones críticas o se está optimizando por costo o latencia.
No tienen sentido cuando todas las tareas tienen una complejidad similar, se está prototipando o la simplicidad es más importante que la optimización.
La regla general: comience con un modelo. Agregue más cuando se enfrente a una restricción real: costo, latencia o calidad. No diseñe la complejidad antes de necesitarla.
Compensaciones (Tradeoffs)
| Patrón | Costo | Latencia | Calidad | Complejidad |
|---|---|---|---|---|
| Modelo único | Más bajo | Más baja | Variable | Más baja |
| Secuencial | Medio | Alta | Alta | Media |
| Paralelo | Alto | Baja | Alta | Media |
| Jerárquico | Alto | Alta | Más alta | Alta |
| Conjunto (Ensemble) | Más alto | Media | Más alta | Más alta |
Cada patrón sacrifica algo. Elija el que coincida con sus restricciones.
Relacionados
- Estrategias de enrutamiento de modelos — enrutamiento basado en capacidad, consciente del costo, consciente de la latencia
- Optimización de costos para sistemas LLM — presupuestación de tokens, modelos de respaldo, caché
- Barreras de seguridad (Guardrails) de LLM en la práctica — validación de entrada, filtrado de salida, seguridad
- LLMs de decisión: cuándo un modelo debe decidir — y cuándo no debe hacerlo — qué decisiones un modelo puede completar en una orquestación y cómo verificarlas
- Arquitectura LLM — pilar de diseño de sistemas: enrutamiento, costo, barreras de seguridad y orquestación
- Patrones de orquestación multiagente — diferente al enrutamiento de múltiples modelos: esto cubre cómo varios agentes autónomos se coordinan, no cómo las tareas se enrutan entre modelos
