Comment installer, configurer et utiliser OpenCode
OpenCode est un agent de codage IA open source que vous pouvez exécuter dans le terminal (TUI + CLI) avec des interfaces bureau et IDE optionnelles. Voici le Guide de démarrage rapide OpenCode : installation, vérification, connexion à un modèle/fournisseur, et exécution de flux de travail réels (CLI + API).
L’inférence LLM ressemble à « une API comme les autres » — jusqu’à ce que les pics de latence apparaissent, les files d’attente s’allongent et que vos GPU atteignent 95 % de mémoire sans explication évidente.
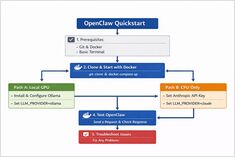
OpenClaw est un assistant IA auto-hébergé conçu pour fonctionner avec des runtime de LLM locaux comme Ollama ou avec des modèles cloud tels que Claude Sonnet.
Stratégie d’observabilité de bout en bout pour l’inférence des LLM et les applications LLM
Les systèmes LLM échouent de manière que la surveillance d’API traditionnelle ne peut pas révéler : les files d’attente se remplissent silencieusement, la mémoire GPU sature bien avant que le CPU ne semble occupé, et la latence explose au niveau de la mise en lot plutôt qu’au niveau de l’application.
Du RAG basique à la production : segmentation, recherche vectorielle, réordonnancement et évaluation en un seul guide.
Production-focused guide to building RAG systems: chunking, vector stores, hybrid retrieval, reranking, evaluation, and when to choose RAG over fine-tuning.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.
Contrôlez vos données et modèles avec des LLM auto-hébergés
L’auto-hébergement des LLMs permet de garder les données, les modèles et l’inférence sous votre contrôle, ouvrant ainsi une voie pratique vers la souveraineté de l’IA pour les équipes, les entreprises et les nations.
Test de vitesse d'un LLM sur une RTX 4080 avec 16 Go de VRAM
L’exécution de grands modèles de langage en local vous offre confidentialité, capacité hors ligne et zéro coût API.
Ce benchmark révèle exactement ce que l’on peut attendre de 14 modèles
LLM sur Ollama avec une RTX 4080.
L’écosystème Rust explose avec des projets innovants, en particulier dans les outils de codage en IA et les applications terminales. Ce panorama analyse les dépôts Rust les plus tendance sur GitHub ce mois-ci.
L’écosystème Go continue de prospérer avec des projets innovants couvrant l’outillage IA, les applications auto-hébergées et l’infrastructure développeur. Ce panorama analyse les dépôts Go les plus tendance sur GitHub ce mois-ci.
Ce guide complet fournit des informations de base et une comparaison détaillée d’Anaconda, Miniconda et Mamba (https://www.glukhov.org/fr/developer-tools/local-dev-platforms/anaconda-vs-miniconda-vs-mamba/ “Comparaison d’Anaconda, Miniconda et Mamba”) - trois outils puissants qui sont devenus essentiels pour les développeurs Python et les scientifiques des données travaillant avec des dépendances complexes et des environnements de calcul scientifique.
Le calendrier technologique essentiel de Melbourne pour 2026
La communauté technologique de Melbourne continue de prospérer en 2026 avec une impressionnante programmation de conférences, rencontres et ateliers couvrant le développement logiciel, l’informatique en nuage, l’IA, la cybersécurité et les technologies émergentes.