Prise en main rapide de llama.cpp avec l'interface en ligne de commande et le serveur
Exécuter des modèles GGUF avec l’interface en ligne de commande et le serveur
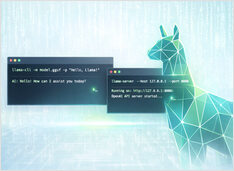
llama.cpp est un moteur d’inférence C/C++ pour les modèles GGUF : llama-cli pour le chat interactif, llama-completion pour les invites scriptées, et llama-server pour une API HTTP compatible OpenAI.