
AI 어시스턴트 아키텍처: LLM, 메모리, 도구, 라우팅, 관측 가능성
실제 생산성 어시스턴트는 어떻게 구축되는가.
프로덕션 AI 어시스턴트는 단순히 “프롬프트가 포함된 LLM"이 아닙니다. 사용자 의도를 수용하고, 상태를 유지하며, 검색 또는 실행 시점을 결정하고, 장애를 디버깅할 수 있도록 충분한 런타임 세부 정보를 노출하는 시스템입니다.
AI 어시스턴트가 단일 모델 호출의 범위를 넘어서는 순간, AI Systems 클러스터가 다루는 시스템 레벨의 관점이 중요해집니다.
OpenAI는 에이전트를 계획, 도구 호출, 협업 및 다단계 작업에 필요한 충분한 상태를 유지하는 애플리케이션으로 묘사하는 반면, Anthropic은 동일한 문제를 파일, 명령, 웹 접근 및 코드를 안전하게 실행할 수 있는 관리형 하네스(managed harness)로 정의합니다.
가장 깔끔한 아키텍처는 책임 범위를 LLM, 메모리, 툴링, 라우팅, 관찰성이라는 다섯 개의 레이어로 분할합니다. 이 분할은 주요 제공자 API, MCP, vLLM 및 llama.cpp과 같은 셀프호스티드 런타임, 그리고 OpenClaw와 Hermes와 같은 실제 어시스턴트 시스템이 노출하는 기능과 일치합니다.
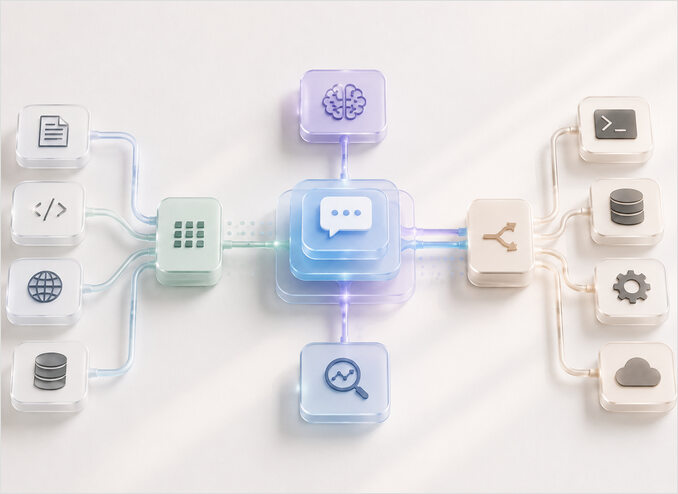
메모리는 단순히 “더 긴 컨텍스트"라고만 볼 수 없습니다. 검색 시스템은 외부 지식을 명시적인 비매개체(non-parametric) 메모리로 전환하며, 이는 검색 증강 생성 (RAG)에서 심도 있게 다루는 동일한 디자인 공간과 연결됩니다. Anthropic의 컨텍스트 가이드라인과 “Lost in the Middle” 논문 모두 컨텍스트에 더 많은 토큰을 밀어 넣는 것만으로는 신뢰할 수 있는 회상을 보장할 수 없다고 경고합니다.
도구 사용은 마법이 아닌 계약 경계입니다. OpenAI 함수 호출, Anthropic 도구 사용, MCP 모두 동일한 패턴에 의존합니다: 모델이 구조화된 요청을 출력하고, 런타임이 이를 실행한 후, 결과가 대화로 되돌아오는 방식입니다. 이 경계가 느슨하면 어시스턴트의 행동 역시 느슨해집니다.
제 신념은 단순합니다: 지루하게 시작하세요. 오케스트레이터 하나, 내구성 있는 메모리 경로 하나, 요청당 트래이스 하나, 그리고 도구 실행에 대한 명시적 정책 하나. 멀티 에이전트 그래프는 유용하지만, 추측 없이 단일 에이전트 실패 사례를 설명할 수 있게 된 이후에만 그 가치가 있습니다.
AI 어시스턴트 시스템이란 무엇인가
실용적인 정의는 다음과 같습니다: AI 어시스턴트 시스템은 모델 인터페이스, 컨텍스트 조립, 도구 실행, 상태 관리, 텔레메트리를 결합하여 사용자 의도를 응답이나 행동으로 전환하는 런타임입니다. 유익한 문서가 모델 카드일 뿐만인 이유가 바로 이것입니다. 유익한 문서는 API 레퍼런스, 도구 계약, 검색 가이드, 라우팅 문서, 트래이싱 문서입니다. OpenAI의 Responses API는 상태 있는(stateful) 상호작용, 내장 도구, 함수 호출을 노출합니다. Anthropic의 Claude API는 직접적인 Messages 접근과 함께 관리형 에이전트(Managed Agents)를 제공합니다. OpenClaw와 Hermes는 한 단계 더 나아가 이러한 기능을 영구적인 게이트웨이, 채널, 세션, 메모리 뒤로 배치했을 때 어떤 일이 발생하는지 보여줍니다.
즉, 어시스턴트 시스템은 채팅 완결(chat completion)보다 더 넓은 계약을 가진다는 의미입니다. 좋은 내부 계약은 다음과 같은 형태를 가집니다:
AssistantRequest  = user intent + identity + session + attachments + policy
AssistantResponse = answer + actions + citations + state changes + trace id
이 계약이 중요한 이유는 프로덕션 환경의 모든 분쟁이 결국 다음 질문 중 하나로 수렴하기 때문입니다: 어떤 컨텍스트가 보였는가, 어떤 도구가 실행되었는가, 어떤 모델이 응답했는가, 어떤 메모리가 읽히거나 기록되었는가, 그리고 트래이스가 시스템이 시간을 어디에 썼는지 어디라고 말하는가. OpenTelemetry는 트래이스를 애플리케이션을 통과하는 요청의 경로로 정의하는데, 이는 진지한 어시스턴트가 필요한 추상화 그 자체입니다. LangSmith와 OpenLIT는 이 개념을 LLM, 도구, 벡터 스토어, 에이전트 워크플로우에 대해 특화시킵니다.
핵심 구성 요소와 인터페이스
아래의 구성 요소 분할 방식은 제가 가장 내구성이 있다고 생각하는 것입니다. 또한 공식 API 및 실제 운영되는 오픈소스 런타임과 가장 잘 일치하는 분할 방식이기도 합니다.
| 레이어 | 주요 책임 | 일반적인 인터페이스 | 예시 기술 |
|---|---|---|---|
| LLM 레이어 | 추론, 생성, 결정, 구조화된 호출 출력 | Responses API, Messages API, OpenAI 호환 또는 Anthropic 호환 엔드포인트 | OpenAI, Anthropic, vLLM, llama.cpp, Ollama |
| 메모리 레이어 | 세션 상태, 내구적 노트, 검색 가능한 지식 유지 | 임베딩, 벡터 검색, 메모리 읽기/쓰기 도구, 검색 API | OpenAI 임베딩 및 벡터 스토어, Pinecone, Weaviate, pgvector, Milvus, Hermes 메모리, OpenClaw 메모리 |
| 툴링 레이어 | 모델 외부에서 데이터 읽기 및 행동 수행 | JSON-schema 도구, MCP 도구, 파일 및 웹 검색, 네이티브 런타임 도구 | OpenAI 함수 호출, Anthropic 도구 사용, MCP, LangChain 도구, LlamaIndex 쿼리 도구 |
| 라우팅 레이어 | 모델, 백엔드, 정책, 테넌트 경로 선택 | 모델 별칭, 페일오버 그룹, 헬스 체크, 예산, 채널 바인딩 | LiteLLM, OpenClaw 멀티 에이전트 라우팅, Hermes 프로바이더 런타임 해석 |
| 관찰성 레이어 | 발생했던 일과 그 이유 설명 | 트래이스, 스팬, 로그, 메트릭, 평가 실행 | OpenTelemetry, LangSmith, OpenLIT |
위의 표는 공식 프로바이더 인터페이스, MCP, 벡터 데이터베이스 문서, vLLM, llama.cpp, OpenClaw, Hermes의 런타임 문서에서 파생되었습니다.
LLM 레이어는 세 가지를 잘 수행해야 합니다: 현재 작업 컨텍스트를 소비하고, 최종 답변 또는 구조화된 행동 요청 중 하나를 출력하며, 재시도와 트래이싱을 지원할 수 있을 만큼의 메타데이터를 반환하는 것. OpenAI의 Responses API는 상태 있는 상호작용과 내장 도구, 함수 호출을 위해 명시적으로 설계되었습니다. Anthropic의 Messages API는 tool_use 블록과 tool_result 반환을 통해 동일한 핵심 루프를 노출하는 반면, 관리형 에이전트(Managed Agents)는 루프를 직접 구축하기 원하지 않을 경우 호스팅 하네스를 제공합니다. vLLM 및 llama.cpp와 같은 셀프호스티드 런타임은 익숙한 프로바이더 스타일의 인터페이스를 유지하면서 추론을 자체 환경 안에 배치할 수 있게 해주므로 중요합니다.
메모리 레이어는 정신적으로 세 가지 버킷으로 나뉘어야 합니다: 작업 메모리, 내구적 상징 메모리, 검색 가능한 의미론적 메모리. OpenAI 임베딩은 인덱싱 및 검색할 수 있는 벡터를 반환하며; OpenAI 검색(Retrieval) 및 파일 검색(File Search)은 벡터 스토어 위에 의미론적 및 키워드 검색을 겹쳐 놓습니다. Pinecone, Weaviate, pgvector, Milvus는 네 가지 일반적인 저장 형태를 나타냅니다: 완전 관리형, 오픈소스 벡터 네이티브, Postgres 네이티브, 분산형 벡터 데이터베이스. Hermes와 OpenClaw는 모든 메모리가 벡터 스토어에 있을 필요는 없다는 유용한 경고를 더합니다: 파일 기반 노트, 검토된 승격(promotion), 세션 스코프 스냅샷은 종종 더 정직한 디자인입니다. AI 어시스턴트에서의 메모리 시스템는 프레임워크 간 모델을 매핑하고; Hermes 에이전트 메모리 시스템는 한 제품 내에서 제한된 코어 메모리와 동결된 세션 스냅샷을 해석합니다.
툴링 레이어는 어시스턴트가 요약기가 멈추고 소프트웨어로 전환되는 곳입니다. OpenAI 함수 호출은 도구를 모델이 호출할 수 있다고 결정할 수 있는 스키마 정의된 기능으로 취급합니다. Anthropic은 이를 더 명시적으로 말합니다: 도구 사용은 애플리케이션과 모델 간의 계약이며, 모델은 절대 단독으로 아무것도 실행하지 않는다는 것입니다. MCP는 이 계약을 클라이언트-서버 프로토콜로 일반화하며, 호스트는 도구를 노출하는 하나 이상의 서버에 연결합니다. 여기서는 도구, 프롬프트, 리소스를 노출합니다. 이는 Go로 MCP 서버 구현하기에서 단계별로 설명된 동일한 경계입니다. LangChain과 LlamaIndex는 오케스트레이션 라이브러리로서 여기에 안착합니다: LangChain은 사전 구축된 에이전트 아키텍처와 통합에 초점을 맞추고, LlamaIndex는 컨텍스트 증강 데이터 접근, 쿼리 엔진, 워크플로우에 초점을 맞춥니다.
라우팅 레이어는 “어떤 모델?“이 유일한 질문이 아니기 때문에 존재합니다. 또한 “어떤 프로바이더 경로, 어떤 테넌트, 어떤 예산, 어떤 레이턴시 클래스, 어떤 페일백?“도 필요합니다. LiteLLM은 공식 문서가 눈부시도록 구체적이어서 유용합니다: 가중치 기반 선택, 최소 붐비기, 레이턴시 기반, 비용 기반 라우팅, 제한된 페일오버가 모두 1급(first-class) 패턴으로 처리됩니다. OpenClaw는 라우팅을 위로 채널 및 에이전트 격리로 확장하고, Hermes는 요약, 컨텍스트 압축, MCP 도구 라우팅과 같은 보조 작업을 위한 슬롯으로 모델 슬롯을 아래로 확장합니다. 이것이 올바른 정신 모델입니다: 라우터는 모델보다 더 많은 것을 선택하며, 실행 레인을 선택합니다.
관찰성 레이어는 아키텍처가 민담(folklore)으로 변하는 것을 방지하는 것입니다. OpenTelemetry는 트래이스 추상화를 제공합니다. LangSmith는 LLM 애플리케이션 단계에 대한 종단 간 가시성을 제공하고 클라우드, 하이브리드, 셀프호스티드 배포 형태를 지원합니다. OpenLIT은 LLM, 에이전트 프레임워크, 벡터 데이터베이스, GPU에 대한 지원을 포함하여 코드 없는(Zero-code) 및 수동 계측 옵션을 가진 OpenTelemetry 네이티브 AI 관찰성을 제공합니다. 추론 및 에이전트 워크플로우 전반의 프로덕션 메트릭, 트래이스, SLO 패턴에 대해서는 LLM 시스템 관찰성을 참고하세요. 요청당 트래이스, 모델 호출당 스팬, 도구 실행 이벤트 historii가 없는 어시스턴트를 가지고 있다면, 아직 아키텍처를 가지지 않은 것입니다. 단지 분위기(Vibes)만 있는 것입니다.
캡처, 증강, 응답
실제 시스템에서 반복적으로 나타나는 시퀀스는 캡처 -> 증강 -> 응답 -> 기록입니다. 다른 프레임워크들은 이를 다르게 포장하지만, 플로는 골격으로 취급하기에 충분히 안정적입니다.
캡처 단계는 외견상 중요해 보이는 것보다 훨씬 중요합니다. OpenClaw와 Hermes 모두 어시스턴트 앞에 영구적인 게이트웨이를 두는데, 이는 인그레스가 단순히 텍스트 입력이 아니기 때문입니다. 채널 메타데이터, 아이덴티티, 권한 부여, 세션 경계, 개인 메시지, 그룹, cron 틱, 전달 세맨틱스를 포함합니다. 이 레이어를 건너뛰고 원시 채팅 위젯 추상화에 의존한다면, 결국 임의의 미들웨어(ad hoc middleware)로 다시 부착하게 될 것입니다.
증강 단계는 성숙한 시스템이 토이 데모와 갈라지는 곳입니다. OpenAI 검색과 파일 검색은 벡터 스토어와 검색 호출을 통해 검색을 명시적으로 만듭니다. LlamaIndex는 데이터 커넥터, 인덱스, 쿼리 엔진, 워크플로우를 통해 동일한 패턴을 정식화합니다. Hermes는 모델 재산을 메인 및 보조 슬롯으로 나누어 압축, 요약, 라우팅과 같은 작업을 더 작거나 특수화된 모델로 오프로딩하여 한 걸음 더 나아갑니다. 이는 도둑맞아야 할 디자인 패턴입니다: 가장 비싼 모델 토큰을 잡일로 낭비하지 마세요.
응답 단계는 “텍스트 생성"이 아닙니다. 그것은 “현재 루프를 닫는다"는 것입니다. 모델이 직접 답변할 수 있다면 그렇게 합니다. 도구가 필요하면 구조화된 요청을 출력합니다. Anthropic의 도구 사용 계약과 OpenAI의 함수 호출 가이드는 모두 이를 명시합니다. 이것이 아키텍처적으로 중요한 이유는 출력이 이제 언어와 제어 흐름(control flow)을 모두 포함하기 때문입니다. 여러분의 응답 객체는 일부는 산문이고 일부는 런타임 계획입니다.
기록 단계는 정합성 세맨틱스가 나타나는 곳입니다. Pinecone은 쓰기 및 읽기 경로를 분리하고 내구성 확인(durable acknowledgement) 후 쓰기를 처리합니다. Hermes 메모리는 세션마다 동결된 스냅샷으로 주입되어 프리픽스 캐시(prefix-cache) 성능을 유지할 수 있으며, 이는 새 쓰기가 현재 세션 프롬프트에 자동으로 나타나지 않는다는 뜻입니다. OpenClaw의 Dreaming 시스템은 검토되고 기반이 되는 후보만 MEMORY.md로 승격하며, 항상 켜져 있는 것이 아니라 선택(opt-in) 방식입니다. 실용적인 교훈은 메모리가 모든 레이어에 걸쳐 진정한 읽기 후 쓰기(read-after-write)인 경우는 드물다는 것입니다. 단계별 가시성(staged visibility)을 위해 디자인해야 합니다.
참조 시스템으로서의 OpenClaw와 Hermes
OpenClaw와 Hermes는 한 프로바이더 API에 대한 래퍼에 불과하지 않기 때문에 유용한 참조 사례입니다. 둘 다 어시스턴트를 게이트웨이, 세션, 도구, 메모리, 다중 모델 백엔드를 가진 장기간 실행 시스템으로 제시합니다.
| 아키텍처적 관심사 | OpenClaw 매핑 | Hermes 매핑 |
|---|---|---|
| 인그레스 및 서피스 | 채팅 앱 및 채널 서피스를 연결하는 셀프호스티드 게이트웨이 | 많은 외부 플랫폼을 연결하는 단일 백그라운드 메시징 게이트웨이 |
| 오케스트레이션 | 채널 및 AI 상호작용을 위한 게이트웨이 중심 제어 평면 | 프롬프트 조립, 프로바이더 선택, 도구 디스패치, 재시도, 페일오버를 처리하는 AIAgent 루프 |
| 라우팅 | 멀티 에이전트 라우팅은 수신 트래픽을 격리된 에이전트(개별 워크스페이스 및 세션)에 바인딩 | 메인 및 보조 모델 슬롯은 코어 추론을 압축, 요약, 승인, MCP 라우팅과 분리 |
| 메모리 | 파일 기반 메모리 + 옵션 활성 메모리 및 백그라운드 Dreaming 승격 | MEMORY.md와 USER.md가 동결된 세션 스냅샷으로 주입, 외부 메모리 프로바이더 포함 |
| 툴링 및 확장 | 내장 도구, 세션 도구, 프로바이더 플러그인, 커스텀 및 셀프호스티드 엔드포인트 | 40개 이상의 도구, 내장 MCP 클라이언트, 툴셋, 스킬, 메모리-프로바이더 플러그인 |
이 매핑은 공식 OpenClaw와 Hermes 문서 및 저장소(레포)에 기반합니다. OpenClaw는 게이트웨이 아키텍처, 멀티 에이전트 라우팅, vLLM 및 Ollama를 포함한 커스텀 및 셀프호스티드 프로바이더 지원, 옵션 활성 메모리, Dreaming 기반 승격을 문서화합니다. Hermes는 메시징 게이트웨이, 중앙 AIAgent 루프, 메인 및 보조 모델 슬롯, 내장 메모리, 네이티브 MCP 통합을 문서화합니다.
제 다소 주관적인 해석은 두 시스템이 동일한 아키텍처적 논증을 다른 억양으로 하고 있다는 것입니다. OpenClaw는 강하게 게이트웨이 퍼스트(gateway-first)입니다. Hermes는 강하게 에이전트-루프 퍼스트(agent-loop-first)입니다. 그러나 둘 다 어시스턴트가 단순히 “프롬프트 + 모델"이라는 얕은 생각을 거부합니다. 채널, 아이덴티티, 메모리 세맨틱스, 도구 서피스, 백엔드 이질성을 1급 관심사로 모델링합니다. 이는 프로덕션 아키텍처가 해야 할 일 그 자체입니다.
두 시스템에서 영감을 받은 실용적인 하이브리드 스택은 다음과 같습니다:
edge:
  gateway: hermes or openclaw

routing:
  proxy: litellm
  policy: latency and budget aware
  tenancy: session and channel scoped

llm:
  primary: openai responses or anthropic messages
  local_fallback: vllm
  local_dev: ollama or llama.cpp

memory:
  session: sqlite or postgres
  semantic: pgvector or weaviate
  embeddings: openai embeddings or ollama embeddings

tools:
  contract: json schema tools plus mcp
  examples: filesystem, browser, web search, internal APIs

observability:
  traces: opentelemetry
  ai_dashboards: openlit or langsmith
  evals: openai evals plus app-specific regression sets
이 스택은 벤더가 지시한 청사진이 아니라 근거 있는 배포 패턴입니다. 공식 인터페이스가 일치하기 때문에 작동합니다: OpenAI와 Anthropic은 도구 지향적인 API를 노출하고, vLLM과 llama.cpp은 프로바이더 스타일 엔드포인트를 에뮬레이션하며, Ollama는 로컬 모델과 임베딩을 처리하고, MCP는 외부 도구를 표준화하고, LiteLLM은 라우팅과 페일오버를 처리하며, OpenTelemetry 호환 플랫폼은 전체 경로를 트래싱할 수 있습니다.
패턴, 테이블, 트레이드오프
명명할 가치가 있는 반복 가능한 어시스턴트 패턴이 몇 가지 있습니다. **관리형 어시스턴트(managed assistant)**는 런타임의 대부분을 프로바이더 API 안에 유지합니다. **검색 퍼스트 어시스턴트(retrieval-first assistant)**는 메모리와 검색을 주요 차별화 요소로 취급합니다. **도구 퍼스트 어시스턴트(tool-first assistant)**는 채팅봇보다 운영자(operator)처럼 행동합니다. **게이트웨이 어시스턴트(gateway assistant)**는 메시징 서피스를 통한 항상 켜져 있는(always-on) 접근을 우선시합니다. **전문가 메시(specialist mesh)**는 작업을 여러 에이전트나 루트로 분해합니다. OpenAI, Anthropic, LlamaIndex, LiteLLM, OpenClaw, Hermes의 공식 문서는 모두 이러한 패턴의 버전을 지원하며, 이름만 다를 뿐입니다.
| 패턴 | 최적화 대상 | 최적 사용 사례 | 숨겨진 비용 |
|---|---|---|---|
| 관리형 어시스턴트 | 배송 속도 | 내부 코파일럿 및 지원 봇 | 프로바이더 락인 및 런타임 세부 정보에 대한 통제 부족 |
| 검색 퍼스트 어시스턴트 | 소유 데이터에 기반한 근거 있는 답변 | 문서, 지원, 지식 업무 | 검색 품질이 실제 제품이 됨 |
| 도구 퍼스트 어시스턴트 | 대화보다 행동 | 운영 워크플로우, 데이터 취득, 자동화 | 부수 효과, 재시도, 승인이 핵심 관심사가 됨 |
| 게이트웨이 어시스턴트 | 만능 접근 | 채팅 서피스 전반의 개인 및 팀 어시스턴트 | 아이덴티티, 세션, 보안 복잡성 |
| 전문가 메시 | 분업 | 실제 소유권 경계가 있는 복잡한 워크플로우 | 디버깅, 오케스트레이션, 평가 디자인 어려움 |
전문가 메시 패턴은 에이전트 수가 증가함에 따라 별개의 엔지니어링 дисципли인으로 성장합니다. 6가지 정형 조정 패턴(오케스트레이터-워커, 순차 파이프라인, 팬아웃, 계층형, 스웜, 메시)과 구체적인 실패 모드 및 프로덕션 의사결정 프레임워크에 대해서는 멀티 에이전트 오케스트레이션 패턴을 참조하세요.
이 패턴 테이블은 특정 벤더의 주장이 아니라 프로바이더 문서, 프레임워크 문서, 참조 시스템에서 합성된 것입니다.
| 옵션 형태 | 전형적인 구성 요소 | 강점 | 약점 |
|---|---|---|---|
| 관리형 | OpenAI Responses 또는 Anthropic Managed Agents, 호스팅된 파일 검색 또는 벡터 스토어 | 가장 빠른 경로, 적은 이동 부품, 호스팅된 도구 | 데이터 경로 및 런타임 세맨틱스에 대한 통제력 최저 |
| 하이브리드 | 프로바이더 API + 셀프호스티드 라우터 및 벡터 스토어 | 속도와 통제의 좋은 균형 | 유지해야 할 계약이 더 많음 |
| 셀프호스티드 | vLLM 또는 llama.cpp 또는 Ollama, MCP, 셀프호스티드 벡터 DB, OTel | 강한 프라이버시 및 배포 통제 | 가장 높은 운영 부담, 하드웨어 및 튜닝 오버헤드 |
테이블 주석: OpenAI 호스팅 파일 검색은 관리형 도구이며, Anthropic은 관리형 하네스를 제공하고, Pinecone은 관리형 벡터 서비스입니다. 반면 vLLM, llama.cpp, Ollama, pgvector, Weaviate, Milvus, LangSmith 셀프호스티드, OpenLIT는 모두 다양한 정도의 셀프관리형 또는 하이브리드 운영을 지원합니다.
| 벡터 스토어 | 형태 | 팀이 선택하는 이유 | 주의할 점 |
|---|---|---|---|
| Pinecone | 관리형 벡터 서비스 | 강한 운영 단순성 및 확장 가능한 관리형 아키텍처 | 외부 의존성 및 관리형 서비스 경제성 |
| Weaviate | 오픈소스 벡터 데이터베이스 | 벡터 + 역색인(inverted indexes) 및 유연한 인덱스 선택 | 호스팅 전용 경로보다 더 많은 클러스터 튜닝 필요 |
| pgvector | Postgres 확장 | 관계를 데이터 및 기존 SQL 스택과 함께 벡터 유지 | 모든 대규모 ANN 워크로드에 가장 적합하지 않음 |
| Milvus | 분산형 벡터 데이터베이스 | 목적 기반 규모 및 관리형 Zilliz Cloud 중심 생태계 | 운영해야 할 또 다른 전문 데이터 저장소 |
테이블 주석: Pinecone은 관리형 제어 평면 및 리전별 데이터 평면을 문서화합니다. Weaviate는 여러 벡터 인덱스 유형을 가진 벡터 및 역색인을 문서화합니다. pgvector는 Postgres에 정확하고 근사한 최인접 검색을 추가합니다. Milvus는 오픈소스 고성능 확장 가능 벡터 데이터베이스로 포지셔닝되며, Zilliz Cloud가 관리형 옵션입니다.
| LLM 옵션 | 인터페이스 스타일 | 최적의 영역 | 주의할 점 |
|---|---|---|---|
| OpenAI Responses | 상태 있는 응답 + 내장 도구 | 빠른 시작, 호스팅된 도구, 구조화된 루프 | 플랫폼 특정 추상화를 상속받음 |
| Anthropic Messages | 명시적 도구 사용 계약과 함께 직접 모델 접근 | 명확한 도구 경계 및 커스텀 루프에서의 좋은 통제 | 관리형 에이전트를 사용하지 않으면 런타임이 더 큰 책임이 됨 |
| vLLM | OpenAI 호환 및 Anthropic 호환 셀프호스티드 서빙 | 고성능 셀프호스티드 추론 | 실제 인프라 및 모델 서빙 작업 |
| Ollama | 간단한 로컬 모델 및 임베딩 런타임 | 로컬 개발 및 소형 셀프호스티드 스택 | 튜닝된 분산 런타임과 동일한 클래스의 서빙 시스템이 아님 |
| llama.cpp | 프로바이더 호환 라우트가 있는 경량 로컬 서버 | 엣지, CPU 우선, 제한된 환경 | 더 많은 수동 튜닝 및 기능 매칭 필요 |
테이블 주석: OpenAI는 Responses를 상태 있는 응답 및 내장 도구를 위한 고급 인터페이스로 문서화합니다. Anthropic은 Messages API와 도구 사용 계약을 관리형 에이전트와 별도로 문서화합니다. vLLM은 OpenAI 호환 서버 및 Anthropic Messages API 지원을 노출합니다. Ollama는 로컬 임베딩 및 모델 워크플로우를 문서화합니다. llama.cpp은 OpenAI 호환 채팅, 응답, 임베딩 라우트 및 Anthropic 호환 채팅 완결을 문서화합니다.
| 제약 또는 트레이드오프 | 관리형 편향 | 셀프호스티드 편향 | 실용적 완화 조치 |
|---|---|---|---|
| 레이턴시 | 종종 더 나은 1차 반복 및 로컬 튜닝 작업 적음 | 모델과 데이터가 공위(colocated)되고 따뜻하게 유지될 때 이길 수 있음 | 라우팅 티어, 핫 캐시, 더 작은 보조 모델 사용 |
| 비용 | 시작하기 쉬움, 토큰 규모에서 변동성 있음 | 안정된 활용률에서 더 나은 상각화 | 직관에 의한 최적화 전에 실제 트래픽 측정 |
| 프라이버시 및 거주지 | 비민감 데이터에 더 단순 | 민감 및 규제 흐름에 더 강한 통제 | 하이브리드 경계 사용 및 이동해야 하는 것만 유지 |
| 정합성 | 호스팅된 도구에도 단계별 가시성 세맨틱스 있음 | 셀프호스티드 메모리 파이프라인도 데이터 단계화 및 승격 수행 | 레이어별로 읽기 후 쓰기 규칙 명시적 정의 |
| 스ケーling | 제어 평면 통증 적음 | 안정된 특수화 워크로드에 더 나은 맞춤화 | 배치 처리, 큐잉, 격리된 테넌트 사용 |
| 디버거빌리티 | 불투명한 프로바이더 내부 놓치기 쉬움 | 스스로 만든 복잡성에 빠져들기 쉬움 | 모든 요청 트래싱 및 모든 라우트 평가 |
이 트레이드오프 매트릭스는 벤더 벤치마크가 아닌 공식 문서로부터의 아키텍처적 추론입니다. 정합성 행은 많은 블로그 포스트가 인정하는 것보다 더 중요합니다: Pinecone은 쓰기 및 읽기 경로를 분리하고, Hermes는 세션 시작 프롬프트에 메모리를 동결하며, OpenClaw는 단계별 검토를 통해 내구적 메모리를 승격합니다. 이는 “메모리 업데이트됨"과 “현재 답변에 대한 메모리 가시"가 종종 다른 진실임을 의미합니다.
실패 모드와 완화 조치
대부분의 어시스턴트는 기본 모델이 “나쁘기” 때문에 실패하지 않습니다. 주변 시스템이 모델에게 거짓말을 하거나, 올바른 컨텍스트를 박탈하거나, 도구의 이탈(drift)을 허용하거나, 디버깅을 불가능하게 만들 때 실패합니다.
| 깨지는 위치 | 전형적인 증상 | 일반적 원인 | 완화 조치 |
|---|---|---|---|
| 프롬프트 조립 | 자신감 있지만 목표에서 벗어난 답변 | 관련 없는 컨텍스트 과다, 순서 불량 | 컨텍스트 예산 설정, 재랭킹, 주요 사실 상단 유지 |
| 검색 | 올바른 톤, 잘못된 사실 | 나쁜 청킹(chunking), 오래된 인덱스, 약한 필터 | 검색을 독립적으로 평가, 메타데이터 필터 및 하이브리드 검색 추가 |
| 도구 경계 | 잘못된 행동 또는 중복 행동 | 느슨한 스키마, 멱등성 없는 재시도 | 조밀한 스키마, 멱등성 키, 승인 게이트 |
| 라우팅 | 요청별 거칠게 일관되지 않는 행동 | 품질 제어 없는 비용 또는 레이턴시 라우팅 | 스티키 세션 및 라우트별 평가 추가 |
| 메모리 | 오래되거나 오염된 회상 | 조급한 쓰기, 약한 검토, 세션 간 누출 | 작업 메모리와 내구 메모리 분리, 승격 검토 |
| 관찰성 | 무슨 일이 있었는지 모름 | 누락된 트래이스 또는 스팬 세분도 없음 | 검색, 모델, 도구 호출에 대한 루트 및 하위 스팬 출력 |
| 환각 제어 | 그럴듯하지만 근거 없는 주장 | 약한 기반 또는 검증 패스 없음 | 참조 문서 검증, 자기 정합성 체크, 평가 게이트 |
이 테이블의 증거 기반은 넓지만 일관됩니다. Anthropic의 도구 문서는 도구 사용이 계약 경계임을 명확히 합니다. OpenAI 가드레일(Guardrails)은 파일 검색을 통해 참조 지식 기반에 대한 환각 감지를 포함합니다. SelfCheckGPT는 샘플 간의 자기 정합성이 근거 없는 주장 감지에 도움이 될 수 있음을 보여줍니다. “Lost in the Middle” 결과와 Anthropic의 컨텍스트 가이드라인은 모두 동일한 운영적 교훈을 강화합니다: 더 많은 토큰이 컨텍스트 큐레이션의 필요성을 제거하지는 않습니다.
선호하는 완화 스택은 지루하고 반복적일 수 있습니다: 모든 요청 트래싱, 프롬프트 버전 관리, 독립적인 검색 평가, 도구 멱등성 유지, 라우트 또는 메모리 정책 변경 전에 회귀 평가 실행. OpenAI의 Evals 문서 및 레포는 왜 이것이 필요한지 단호하게 말합니다: 평가가 없으면 모델 또는 프롬프트 변경이 사용 사례에 어떻게 영향을 미치는지 이해하기 어렵고 시간 소모적입니다. 이는 프롬프트만큼 라우터와 검색에도 동일하게 적용됩니다.
추가 독서
더 깊이 알고 싶다면, 어시스턴트 아키텍처를 디자인하거나 검토할 동안 열어 두어야 할 가장 유용한 1차 소스가 있습니다.
-
OpenAI: Responses 개요, 함수 호출, 도구 사용, 검색, 파일 검색, Evals, 그리고 원격 도구 서버용 MCP.
-
Anthropic: API 개요, 도구 사용, 도구 사용 계약, 관리형 에이전트, 컨텍스트 윈도우, 그리고 MCP 커넥터.
-
MCP 자체: 아키텍처 개요 및 사양은 호스트, 클라이언트, 서버, 도구, 프롬프트, 리소스, 트랜스포트, 기능 협상을 깔끔하게 설명하므로 직접 읽을 가치가 있습니다. MCP와 Agent2Agent 프로토콜의 실용적 비교 및 멀티 에이전트 시스템이 두 레이어 모두를 필요로 하는 시점에 대해서는 A2A vs MCP: AI 에이전트가 정말로 두 프로토콜이 모두 필요한가?를 참조하고, A2A 개념 자체(Agent Cards, 태스크 라이프사이클, 메시지, 파트, 아티팩트)에 대해서는 A2A 프로토콜이란? Agent Cards와 태스크 해설를 참조하세요.
-
백그라운드 및 능동적 어시스턴트: 툴링 레이어는 어시스턴트가 행동하는 방법의 일부일 뿐입니다. 어시스턴트가 스스로 감시하고, 결정하고, 행동하게 만드는 방법(스케줄러, 큐 기반 워커, 클레임 프로토콜, 내구적 워크플로우, 의미론적 폴링)에 대해서는 AI 어시스턴트에서의 폴링 에이전트: 11가지 구현 패턴를 참조하세요.
-
의사결정 권한: 모델이 어떤 결정을 해야 하고, 추천하고, 또는 단순히 정보를 제공해야 하는지 — 5가지 의사결정 역할, 가장 작은 유능한 티어로의 신뢰도 기반 라우팅, 폭발 반경에 맞춤 조정된 승인 게이트에 대해서는 의사결정 LLM: 모델이 결정해야 할 때와 결정하지 않아야 할 때를 참조하세요.
-
A2A 프로토콜 및 채택: 에이전트가 독립적으로 배포되고 소유권 경계를 넘어 협업해야 할 때, A2A가 관련이 됩니다. A2A가 실제로 견인력을 가지는 곳, 그것이 제기하는 보안 문제, 채택 의사결정 프레임워크에 대한 2026년의 실용적 관점에 대해서는 2026년 Google A2A 프로토콜: 채택, 과대평가, 현실를 참조하세요. 이러한 에이전트가 단일 채팅 턴이 아니라 장기간 실행 태스크를 교환할 때, 장기 실행 에이전트 워크플로우를 위한 A2A 스트리밍 및 비동기 태스크는 프로토콜 경계에서의 SSE, 푸시, input_required 디자인을 다룹니다.
-
프레임워크 및 라우팅: LangChain 개요, LlamaIndex 컨텍스트 증강 문서, LiteLLM 라우팅 문서, LangSmith 관찰성 문서.
-
셀프호스티드 런타임 및 어시스턴트 시스템: vLLM, llama.cpp 서버, Ollama 임베딩, OpenClaw 문서 및 레포, Hermes 문서 및 레포.
-
스토리지 및 관찰성: Pinecone, Weaviate, pgvector, Milvus, OpenTelemetry, OpenLIT.
-
연구 논문: 지식을 많이 요구하는 NLP 태스크를 위한 검색 증강 생성(Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks), Lost in the Middle, SelfCheckGPT.
